sábado, 24 de septiembre de 2011

miniSL parte 15 - Funciones auxiliares de evaluación

En la última entrada sobre miniSL estuvimos estudiando la evaluación. La evaluación es directa en casi todos los casos. Únicamente cuando tenemos que ejecutar una función definida por el usuario (celda de tipo LAMBDA_VAL) necesitamos una función auxiliar.

Esta función es ApplyLambda() y lo que hace es tomar
  • El código del usuario que hay que ejecutar (esto está en la celda LAMBDA_VAL) que contiene también el nombre de los parámetros. 
  • El código de los argumentos que se le pasa a la función (esto está en el código, en la celda COMBINE_CODE) 
  • El entorno de clausura donde queremos que se evalúe el código del usuario (también está en la celda LAMBDA_VAL)
  • El entorno donde hay que evaluar los argumentos, ya que estos se evalúan en el entorno de llamada y no en el local.

CELL& Script::ApplyLambda(CELL& code, CELL& args, CELL& closure, CELL& envir)
{

Con estos valores, la función ApplyLambda() crea un entorno nuevo. El entorno local.
CELL& new_envir=CreateEnvir(&closure);

Luego, evalúa los argumentos en el entorno de llamada y los va introduciendo en este entorno local con los nombres de los parámetros que se declararon en el código. Si la función era f(a,b,c) y se llama con f(1+2,3+4,5+6), lo que ApplyLambda() hace es evaluar 1+2, obteniendo el valor 3, y vincular la variable a al valor 3 recién obtenido. Luego hace lo mismo vinculando b a 7 y c a 11. Esto se hace con este bucle.

CELL* params=code.head;
 CELL* arguments=&args;
 while(params->type==CONS_CTOR && arguments->type==CONS_CTOR)
 {
  (*new_envir.envir_table)[params->head]=&Evaluate(*arguments->head, envir);
  params=params->tail, arguments=arguments->tail;
 }

Bien podría ocurrir que nos sobren argumentos o parámetros. Es decir, que la aridad de la función no coincida con la de la llamada. Eso es un error.

if((params->type!=CONS_CTOR) != (arguments->type!=CONS_CTOR))
  throw L"Invalid arity";

Finalmente, evaluamos el código. El código es una secuencia y se debe evaluar como tal usando otra función auxiliar.

return EvaluateInSequence(*code.tail->head, new_envir);
}

La función auxiliar EvaluateInSequence() es sumamente sencilla. Evalúa una lista en secuencia y retorna el valor de la última expresión evaluada.

CELL& Script::EvaluateInSequence(CELL& c, CELL& envir)
{
 CELL* aux=&CreateCell(EMPTY_LIT);
 for(CELL* p=&c; p->type==CONS_CTOR; p=p->tail)
  aux=&Evaluate(*p->head, envir);
 return *aux;
}

Como se observa, lo más complicado (y lento) es ir vinculando en el entorno local los valores de los argumentos a los parámetros. De hecho, en los lenguajes de programación reales, se buscan convenios de llamada que eviten esto. Por ejemplo, introduciendo los valores de los argumentos en pila con cierto orden. De esta manera, la función llamada no tiene que buscar las variables por su nombre, que también es lento, sino por su posición en memoria que es mucho más rápido.

Con esto acabamos el núcleo del lenguaje. En la siguiente entrada pondré el código escrito hasta ahora y, a partir de entonces, empezaremos con el reconocimiento sintáctico del programa.

miércoles, 21 de septiembre de 2011

La intuición tras la transformada de Laplace

Imaginemos que queremos hacer una derivada de una señal [$x(t)$].[$$\frac{d}{dt}x(t)$$] Las derivadas son operadores lineales. Eso quiere decir que si dividimos la señal en dos términos [$A_1 x_1(t)+A_2 x_2(t)$] tenemos [$$  \frac{d}{dt}x(t)=    A_1 \frac{d}{dt}x_1(t)  +  A_2 \frac{d}{dt}x_2(t)  $$] Ya que estamos, seamos astutos. Busquémonos unos términos que se deriven con facilidad. Por ejemplo, [$A e^{st}$]. Si estos fueran los términos, tendríamos [$$x(t)=A_1 e^{s_1t} + A_2 e^{s_2t}$$] y entonces  [$$  \frac{d}{dt}x(t)=    A_1 \frac{d}{dt}x_1(t)   +  A_2 \frac{d}{dt}x_2(t)  = A_1 s_1 e^{s_1t} + A_2 s_2 e^{s_2t} $$]Mucho más fácil.

Todo esto está muy bien; pero es raro que una señal sea suma de dos exponenciales (bueno, quizás no sea tan raro). Una opción es hacer la suma infinita, lo cual abarca muchas más señales. Sin embargo, la opción buena, buena, buena es que sea una suma de densidades. Una integral. [$$ x(t)=\int_C{A(s)e^{st}ds}$$] El único truquillo es que la amplitud depende de la constante [$s$] que usemos en la exponencial. El contorno de integración [$C$] no nos interesa ahora. Cuando este contorno existe es que la señal puede representarse así. A veces, no existe. Es decir, que tampoco abarcamos todas las señales posibles, pero sí muchísimas. Todas las de interés.

¿Qué pasa cuando derivamos la señal [$x(t)$] descompuesta como una integral de exponenciales? La integral es lineal, la derivada también, la variable de derivación no está relacionada con la variable del diferencial... Todo esto nos permite mover la derivada bajo el signo de la integral. [$$  \frac{d}{dt}x(t)=  \frac{d}{dt}\int_C{A(s)e^{st}ds} =   \int_C{ \frac{d}{dt} A(s)e^{st}ds}  $$] Y ya tenemos lo que queríamos, la derivada de una exponencial que es ella misma por la derivada de su exponente. [$$  \frac{d}{dt}x(t)=  \int_C{A(s)\ s\ e^{st}ds} $$] Buscando la similitud con   [$$ x(t)=\int_C{A(s)e^{st}ds}$$] es fácil ver que la derivada lo único que hace es multiplicar [$A(s)$] por [$s$]. ¡Mucho más fácil multiplicar que hacer la derivada!

Esa [$A(s)$] es casi la transformada de Laplace. Digo casi porque el contorno [$C$] introduce un factor de [$2\pi j$] que hay que compensar. Entonces, si llamo [$\mathcal{L}_{x(t)}(s)$] a la transformada de Laplace de [$x(t)$], tendré que    [$$ x(t)=\frac{1}{2\pi j}\int_C{ \mathcal{L} _{x(t)}(s)e^{st}ds}$$] Concretamente la expresión de arriba es la transformada inversa de Laplace. La transformada directa es más sencilla.   [$$   \mathcal{L}_{x(t)}(s)=\int_0^\infty{x(t)e^{-st}dt}$$]

jueves, 15 de septiembre de 2011

Incompatibilidades sintácticas

Los operadores prefijos e infijos no pueden ser a la vez identificadores

Si ese fuera el caso, tendríamos la siguiente ambigüedad.

a b c //=> (a) b (c) si b fuera infijo
a b c //=> a (b c) si b fuera prefijo

Una solución a esto es restringir o bien los operadores infijos o bien los prefijos para que no puedan ser identificadores.
 
Las palabras clave de las sentencias no pueden ser identificadores

Parece una perogrullada, pero hay una razón para que sea así.

return + a //=> return (+a) si es palabra clave
return + a //=> (return) + (a) si es identificador

Una solución a esto es reservar ciertos identificadores como palabras clave. Otra solución es marcar de alguna manera los identificadores que queramos que sean introductores de sentencias.
 
La tensión entre la llamada por yuxtaposición y los operadores como identificadores

No pueden compartir la misma categoría sintáctica (identificadores) ya que su asociatividad es distinta.

a b c //=> (a b) c  si es llamada por yuxtaposición (currificación)
a b c //=> a (b c)  si b es un operador prefijo
a b c //=> (a) b (c) si b es un operadores infijo

Una solución es no tener llamada por yuxtaposición. Otra solución es restringir los operadores a símbolos.

+ - c //=> + (- c)  OK. No se confunde. Si son símbolos, son prefijos.

Un operador no puede ser infijo, prefijo y postfijo a la vez

Si ese fuera el caso, tenemos la siguiente ambigüedad. Incluso con una categoría sintáctica distinta.

a + + b //=> (a +) + b  si el primer más es tomado como postfijo
a + + b //=> a + (+ b)  si el segundo más es tomado como prefijo

Llamada por yuxtaposición y tuplas son incompatibles con la sintaxis usual de llamada

Esto sólo es relevante si la semántica es distinta. Si la semántica es la misma, la ambigüedad confluye en un mismo significado.

f(a,b,c) //=> La función f aplicada por yuxtaposición a un argumento que es la tupla (a,b,c)
f(a,b,c) //=> La función f aplicada a tres argumentos que son a, b y c

Una solución a esto es usar otra sintaxis para las tuplas, por ejemplo [a,b,c].

Tuplas y parentización

Es una ambigüedad muy usual.

(1) //=> El número uno
(1) //=> Una tupla con un elemento que es el número uno

Algunos lenguajes como Python solucionan esto añadiendo una coma extra en el caso de ser una tupla y no una parentización.

(1,) //=> Una tupla en Python

viernes, 9 de septiembre de 2011

¿Qué es una clausura léxica?

Expresiones abiertas

Antes de ver qué es una clausura léxica debemos saber qué es una clausura y antes de saber qué es una clausura debemos saber qué es lo que cierra la clausura. Lo que la clausura cierra son expresiones abiertas. Ahora bien, ¿qué es una expresión abierta? Para responder a esta pregunta necesitamos saber antes qué es una variable ligada y una variable libre.

La forma más sencilla de explicarlo es mediante un mínimo ejemplo. Definamos dos funciones.

f= λx.x+3
g= λx.5x

Aunque hemos usado la misma variable “x” en ambas funciones, cada “x” tiene un significado distinto en cada función. No hay más que aplicar las funciones.

f(4) = 4+3
g(7) = 5·7

La “x” de la función “f” vale 4 y la “x” de la función “g” vale 7. Esto es así porque estas “x” son variables ligadas. La “x” de “x+3” está ligada a la “λx” de “f” y la “x” de “5x” está ligada a la “ λx” de “g”.

Otro ejemplo:

h = λx. x+y

En este caso la “x” de “x+y” está ligada a la “λx” de “h”. Por otra parte la “y” no está ligada, es una variable libre.

En “a+b” tanto “a” como “b” son variables libres y en “c+c” la “c” es una variable libre que aparece dos veces.

Se llaman expresiones cerradas a las que no tienen variables libres y se llaman expresiones abiertas a las que tienen variables libres.

“5+3” es una expresión cerrada.
“λx.2x” es una expresión cerrada.
“λx.x+x” es una expresión cerrada.
“λxy.2x+5y+3” es una expresión cerrada.
“a” es una expresión abierta (la variable “a” es libre).
“λy.y+x” es una expresión abierta (la variable “x” es libre).
“1+z” es una expresión abierta (la variable “z” es libre).

Clausuras

Realizar una clausura consiste en ligar las variables libres dándoles algún valor. Una clausura podría ser la clausura cero en la cual todas las variables libres toman el valor cero.

En esta clausura la expresión “3+x” es abierta, pero se cierra a “3+0”. Igualmente, la expresión “f= λx.x+y” que tiene de variable libre a la “y”, se cierra a “f= λx.x+0”.

Pero podríamos tener otro tipo de clausura. Por ejemplo, la que se usa en matemáticas que llamaremos aquí la clausura convencional. En esta clausura las variables libres toman el valor que hayan definido por nosotros los matemáticos.

La expresión “cos(3)” es abierta porque “cos” es una variable libre. Ahora bien, todo el mundo sabe que “cos” es el coseno por lo que cerramos la expresión ligando la variable “cos” con la función coseno.
En algunos casos la clausura convencional no nos sirve. Imaginemos que nos encontramos con la expresión “K(5)”. Leyendo las bibliotecas de funciones matemáticas nos damos cuenta que podría ser la función de Bessel o la función de Sturve o la integral elíptica de primer orden o varias cosas más.

La forma de resolverlo es haciendo una clausura global. En esta clausura ligamos explícitamente las variables a su significado siempre que no se diga lo contrario. Es lo que se suele hacer cuando definimos una función. El decir “f=λx.2x” significa que “f” es la función doble y, si más adelante tenemos “f(2)”, recordamos el significado de “f” que le dimos. Este tipo de clausura global es la que se usa en lenguajes de programación como el C.

Por cierto, cuando digo “f=λx.2x” no sólo estoy ligando “f” para la clausura global, también estoy ligando “x” en la expresión “2x”. Esta es la clausura local. En este punto, el lector con conocimiento de informática habrá identificado las clausuras con los entornos. Realmente la clausura es el entorno (el ligado de variables) más la expresión que se cierra.

La clausura léxica

El adjetivo “léxico” significa “relativo a las palabras de un lenguaje”. Es decir, que haremos la clausura según nos digan las palabras del lenguaje.


En los lenguajes de ordenador (y en las matemáticas) las expresiones se anidan unas dentro de otras. Así, la expresión “1+2” está dentro de la expresión “7+g(1+2)”. Esto da lugar a una estructura del propio lenguaje. La clausura léxica es la que respeta esa estructura.

{
      define x=5 //Definimos “x”
      define g(y)=x+y //Definimos “g”. La “x” es libre aquí
}

En este programa, la expresión “define g(y)=x+y” está dentro de la estructura superior “{ define x=5; define g(y)=x+y }”. En muchos lenguajes de programación las llaves {} se usan para mostrar la estructura del programa.

Cuando se define la función “g(y)”, la variable “y” está ligada, pero la “x” no. Sin embargo, siguiendo la estructura del programa, el valor de “x” está definido un poco más arriba. Esto quiere decir que la clausura léxica liga la variable “x” (dentro de la función de “g”) a la “x” que está definida fuera de esa definición, pero estructuralmente por encima de ella.

Podría uno pensar que la clausura léxica es un descontrol porque liga las variables como le da la gana. No es así. En este ejemplo, la clausura léxica no liga la “y” y un compilador daría un error.

{
      define g(y)=y+7
      define f(x)=x+y
}

No hay ligazón porque la expresión “define g(y)=y+7” no define la “y”, define la “g”. Además, la “y” de “g(y)” ya está ligada a la de “y+7”.

El siguiente diagrama muestra cómo, al realizar la clausura léxica, se van buscando estructura arriba las ligazones de variables.


La clausura léxica como valor

Una de las claves de la clausura léxica es que se son un valor. El ejemplo típico es el siguiente:

{
      define f(x)=λy.x+y;
      define a=f(2);
      define b=f(5);
      print a(4); //Imprime 6
      print b(4); //Imprime 9
}

En este ejemplo la expresión “λy.x+y” es una expresión abierta y la clausura léxica de la misma nos dice que hemos de ligar la “x” a la de la “f(x)”. Sin embargo esta “x” es el argumento de una función así que el resultado de “f(2)” es la clausura léxica de la expresión “λy.x+y” ligando la “x” al “2”. Esto es un valor como la cadena “hola”, sólo que es algo más largo de describir.

De la misma forma “b” se define a la clausura léxica de la expresión “λy.x+y” ligando “x” al “5”. Dado que la expresión “λy.x+y” es la función que toma un “y” y devuelve “x+y”, podemos usar esa función. Es lo que se hace en los “print”.

En el primer “print” usamos la variable “a” cuyo valor era “ λy.x+y” ligando la “x” al “2”. Al aplicar “a(4)” le damos un valor a “y” así que el resultado es “x+4” ligando la “x” al “2” que a su vez es “6”. Lo que se imprime. El mismo razonamiento obtenemos para “b(4)”.

La clausura léxica y la asignación

Existe un pequeño detalle final y consiste en distinguir ligazón y asignación. Realmente, realmente al hacer “f(2)” en este último ejemplo no ligamos la “x” de “λy.x+y” a “2”. Lo que hacemos es ligar esa “x” a la de “f(x)” y, luego, al hacer “f(2)” asignamos la “x” de “f(x)” a “2”. El siguiente diagrama lo muestra.


Esta distinción es importante porque en los lenguajes imperativos se permite reasignar. Es lo que ocurre en este código.

{
      define x=5;
      define f(y)=x+y;
      print f(3); //Imprime 8
      x=7;        //Reasignación de x
      print f(3); //Imprime 10
}

Cuando el lenguaje es funcional estas distinciones no son importantes porque no se puede reasignar.

jueves, 25 de agosto de 2011

Lo que nunca me enseñaron: Los filtros de Cauer (y parte IV)

Partes anteriores: 1, 2 y 3.

Las funciones elípticas de Jacobi

Las funciones elípticas de Jacobi son una generalización de las funciones trigonométricas. Hay doce funciones elípticas de Jacobi, pero sólo vamos a usar una que se llama [$cd$] y está relacionada con el coseno. Si bien el argumento de las funciones trigonométricas son ángulos, el argumento de las funciones elípticas de Jacobi es un valor [$u$] que no tiene una relación inmediata ni con los ángulos, ni áreas ni longitudes de arco.

Trigonometría en la elipse usando las funciones elípticas de Jacobi [$sd$], [$nd$] y [$cd$]. Hay más funciones elípticas de Jacobi, pero sólo nos será de utilidad la [$cd$].


El valor [$k^'$] se llama el comódulo elíptico y se relaciona con la excentricidad de la elipse [$k$], también llamada el módulo elíptico, de la siguiente forma. [$$ k^2+(k^')^2=1$$] Dependiendo de la excentricidad de la elipse sobre la que trabajemos las funciones de Jacobi cambian por lo que es usual presentarlas con dos argumentos.[$$cd(u,k),\ \ \ \ sd(u,k),\ \ \ \ nd(u,k)$$] En concreto, la función [$cd(u,k)$] es muy parecida al coseno cuando se observa su inversa. [$$ arccd(u,k)=\int_u^1{\frac{dt}{\sqrt{1-t^2}\sqrt{1-k^2 t^2}}}$$] Investigaremos el recorrido que hace esta función cuando [$u$] se mueve desde [$0$] hasta infinito. Empieza en [$$ arccd(0,k)=\int_0^1{\frac{dt}{\sqrt{1-t^2} \sqrt{1-k^2 t^2}}}$$] Este valor es conocido como la integral elíptica completa de primera especie de módulo [$k$] y se escribe usualmente como [$K(k)$].

Diagrama representando el valor real resultado de la integral completa de primera especie que es el valor del [$arccd$] de cero.


Conforme aumente [$u$] por los reales, decrecerá el [$arccd$] hasta que lleguemos a [$u=1$] donde los límites de la integral van a coincidir por lo que su valor será cero. Si hacemos el recorrido simétrico hacia los valores negativos, llegaremos a [$u=-1$] donde el valor de su [$arccd$] será [$2K(k)$].

Recorrido del valor de [$arccd$] con argumentos desde cero hasta uno (y simétrico por los negativos).


A partir de este punto, seguir integrando significa que la raíz [$\sqrt{1-t^2}$] va a resultar en valores imaginarios. Nuestro recorrido pasará a moverse verticalmente por la gráfica hasta que [$u=\frac{1}{k}$]. A partir de este valor, la raíz [$\sqrt{1-k^2 t^2}$] también se hace imaginaria. El valor del [$arccd$] en [$u=\frac{1}{k}$] es fácilmente calculable mediante un cambio de variables. [$$ arccd \left(\frac{1}{k},k\right)=\int_{\frac{1}{k}}^1{\frac{dt}{\sqrt{1-t^2}\sqrt{1-k^2 t^2}}}=\int_0^1{\frac{dt}{\sqrt{t^2-1}\sqrt{1-(k^')^2 t^2}}}=jK(k^' )$$] Trazando estos segmentos verticales del recorrido obtenemos el siguiente diagrama.
Recorrido del valor de [$arccd$] con argumentos desde cero hasta [$\frac{1}{k}$] (y simétrico por los negativos)
Finalmente, continuamos a partir de [$\frac{1}{k}$]. Ahora las dos raíces tienen el radicando negativo y son por tantos imaginarias, como [$j^2=-1$] el sentido de nuestro recorrido ha de ser opuesto al que inicialmente tenía. En el límite hacia el infinito será: [$$arccd(\infty,k)\rightarrow \int_\infty^1{\frac{dt}{\sqrt{1-t^2}\sqrt{1-k^2 t^2}}}=K(k)+jK(k^' )$$] Así que terminamos el recorrido de la siguiente manera.
Recorrido completo del valor de [$arccd$] con argumentos reales.


Sabiendo que al seguir este recorrido sobre la función [$cd(u,k)$] debemos obtener la función identidad, ganamos perspectiva de cómo es la función [$cd(u,k)$].

Secciones de cd

Su diagrama de polos y ceros se presenta a continuación y observamos que tiene dos periodos. El usual de [$4K(k)$] que se correspondería con el [$2\pi$] de las funciones trigonométricas y otro imaginario de [$2iK(k^' )$] que aparece por esa segunda raíz cuadrada en la integral. La zona sombreada es la que se repite periódicamente tanto horizontal como verticalmente.
Diagrama de polos, ceros y valores destacados de [$cd$].

Como hicimos con la función coseno, vamos a ver cómo es la función [$cd(u,k)$] en las tres secciones del recorrido de [$arccd(u,k)$]. Recordemos que en estas rectas la función [$cd(u,k)$] es real.


Tres secciones de la función [$cd$] por las rectas que va a seguir su [$arccd$]. En estas rectas el valor de [$cd$] es real y se representa a su derecha.

Para la rama negativa tenemos que [$$ cd(u+2K(k),k)=-cd(u,k)$$] Además, existe una propiedad de simetría entre [$cd(t,k)$] y [$cd(t+jK(k^' ),k)$] que usaremos más adelante. [$$cd(u+jK^' (k),k)=\frac{1}{k\ cd(u,k)}$$] En la DLMF podemos ver en 3D la función [$cd$] con sus polos bien distinguidos.

http://dlmf.nist.gov/22.3.F19.mag


La función racional elíptica


El lector astuto ya habrá imaginado que lo siguiente que vamos a hacer es [$$cd(n\ arccd(u ,k),k)$$] Como hicimos con los polinomios de Chebyshev, el recorrido del [$arccd$] queda ampliado [$n$] veces. Siguiéndolo, nos haremos una idea de cómo es esta función. Como antes, sólo seguiremos los valores positivos ya que los negativos son simétricos.


Recorrido de [$arccd$] ampliado tres veces sobre el diagrama de polos y ceros de [$cd$].

El resultado es una oscilación entre +1 y -1 en el primer segmento, otra oscilación entre 1 y 1/k en el segundo segmento y otra oscilación entre 1/k e infinito (cambiando de signo en cada infinito) en el tercer segmento.


Gráfica de la función [$cd(3\ arccd(x, k), k)$] con cada uno de los tramos coloreados.

Esta función no nos sirve como función [$F^2 (\omega)$] porque tendría oscilaciones en la banda de paso.
La función anterior al cuadrado como intento de aproximación a [$F^2(\omega)$]. La banda de transición es muy ancha y tiene oscilaciones.

Afortunadamente tenemos dos [$k$] a nuestra disposición, la del [$arccd$] que llamaremos [$k_a$] y la del [$cd$] que llamaremos [$k_c$]. Entonces, se define la función racional elíptica de la siguiente forma:[$$R_n (u,k_a,k_c )=cd\left(n\ \frac{K(k_c )}{K(k_a )} arccd(u ,k_a ),k_c \right)$$] La aparición del cociente [$\frac{K(k_c )}{K(k_a )}$] es necesaria para convertir el periodo real del [$arccd$] en el periodo real del [$cd$] que ahora son distintos al tener módulos distintos. Bueno, exactamente [$n$] veces ese periodo.
Por otra parte, ese n no lo queremos en el periodo imaginario. Querríamos tener [$$ R_n (u,k_a,k_c )=cd\left(\frac{K(k_c^' )}{K(k_a^' )} arccd(u ,k_a ),k_c \right)$$] ¡Y podemos tener ambas condiciones si elegimos con cuidado! [$$ n=\frac{K(k_a )K(k_c^' )}{K(k_a^' )K(k_c )} $$] De esta forma el recorrido queda multiplicado sólo en la dirección horizontal.
El recorrido que tomamos en la función elíptica racional con unos parámetros adecuados para que sólo se mueva medio periodo imaginario.

La gráfica de esta función es como sigue. En ella aparece tanto la [$k_a$] como la [$k_c$] explícitamente.

Gráfica de la función elíptica racional con módulos [$k_a$] y [$k_c$] (y la [$n$] adecuada según se comentó arriba).

Como ocurría con los polinomios de Chebyshev, esta función es real, aunque esta vez no puede expresarse como un polinomio ya que tiene polos (los infinitos). Debe expresarse como un cociente entre polinomios, de ahí que se llame función racional elíptica.

El filtro de Cauer

El filtro de Cauer o filtro elíptico es el que toma esa función racional elíptica como [$F(\omega)$]. La gráfica de su cuadrado es la que sigue.
La función racional elíptica como función [$F(\omega)$] de un filtro.

Ajustando para que se cumplan los requisitos de un filtro tenemos que [$$ F^2 (\omega)=\epsilon_p^2 R_n^2 \left(\frac{\omega}{\omega_p} ,\frac{\omega_p}{\omega_s} ,\epsilon_p \epsilon_s \right)$$] Donde hemos usado [$$k_a=\frac{\omega_p}{\omega_s}$$][$$ k_c=\epsilon_p \epsilon_s$$]
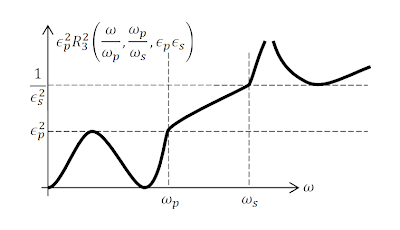
La función racional elíptica como función   [$F(\omega)$] de un filtro con los parámetros ajustados a las especificaciones del filtro.  
Así que un filtro de Cauer de orden [$n$] tiene la siguiente respuesta en frecuencia al cuadrado. [$$ |H(j\omega) |^2=\frac{1}{1+\epsilon_p^2 R_n^2 \left( \frac{\omega}{\omega_p} ,\frac{\omega_p}{\omega_s} ,\epsilon_p \epsilon_s \right)}$$] Realmente, su banda de transición es mucho más pequeña que lo trazado en las gráficas anteriores. La siguiente gráfica muestra la respuesta en frecuencia bien escalada.
Respuesta en frecuencia de un filtro de Cauer

Además, la condición de la no oscilación en la banda base y ajuste de periodos es precisamente la cota del orden del filtro. [$$ n\ge \frac{K(\frac{\omega_p}{\omega_s}) K^' (\epsilon_p \epsilon_s )}{K^' ( \frac{\omega_p}{\omega_s} )K( \epsilon_p \epsilon_s )}$$] Donde [$K^' (k)=K(k^' )$].
Ojo: una vez hallado [$n$] con la desigualdad, hemos de modificar algún requisito para que se cumpla la igualdad. Debemos tener la igualdad si no queremos oscilaciones en la banda de transición.

La búsqueda de la función de transferencia

Para obtener la función de transferencia necesitamos conocer los polos y los ceros de la misma. Ambos son sencillos de calcular. Hagamos el cambio [$\omega=-js$] y empecemos por los ceros de la función de transferencia. Ocurrirán cuando [$R_n^2$] tienda a infinito. Es decir, en los polos de [$R_n^2$]. [$$R_n^2 \left(\frac{-js_{cero}}{\omega_p} ,\frac{\omega_p}{\omega_s} ,\epsilon_p \epsilon_s \right)=\infty$$] [$$n \frac{K(\epsilon_p \epsilon_s )}{K(\frac{\omega_p}{\omega_s} )} arccd\left(\frac{-js_{cero}}{\omega_p} ,\frac{\omega_p}{\omega_s} \right)=arccd(\infty,\epsilon_p \epsilon_s )$$]
El miembro de la derecha es la localización de los polos de [$cd$]. Recordemos que hay dos periodos y, por la dirección del recorrido del [$arccd$] en la zona de los ceros, nos interesa el periodo real.[$$n \frac{K(\epsilon_p \epsilon_s )}{K(\frac{\omega_p}{\omega_s})} arccd\left(\frac{-js_{cero\ m}}{\omega_p} ,\frac{\omega_p}{\omega_s}\right)=(2m+1)K(\epsilon_p \epsilon_s )+jK^' (\epsilon_p \epsilon_s )$$]
Despejando llegamos a la expresión siguiente. [$$ s_{cero\ m}=j\omega_p cd\left(\frac{2m+1}{n} K\left(\frac{\omega_p}{\omega_s}\right)+jK^' \left(\frac{\omega_p}{\omega_s}\right),\frac{\omega_p}{\omega_s} \right)$$]Por la propiedad de simetría, se simplifica aún más. [$$ s_{cero\ m}=\frac{j \omega_s}{cd\left(\frac{2m+1}{n} K(\frac{\omega_p}{\omega_s}),\frac{\omega_p}{\omega_s} \right)}$$]
Para los ceros con los que nos quedamos en H(s), el valor de [$m$] se debe mover entre [$0$] y [$n-1$]. En algunos casos el cero aparecerá en el infinito. Eso significa que no debemos tenerlo en cuenta.
Para los polos hay que igualar [$\epsilon_p^2 R_n^2$] a menos uno. [$$ \epsilon_p^2 R_n^2 \left(\frac{\omega_{polo}}{\omega_p} , \frac{\omega_p}{\omega_s} ,\epsilon_p \epsilon_s \right)=-1$$][$$ R_n \left( \frac{\omega_{polo}}{\omega_p} , \frac{\omega_p}{\omega_s} ,\epsilon_p \epsilon_s \right)  =\frac{j}{\epsilon_p}$$] Obtenemos una expresión similar a la que teníamos para los ceros. [$$ cd\left(n\ \frac{K(\epsilon_p \epsilon_s )}{K(\frac{\omega_p}{\omega_s})} arccd \left(\frac{-js_{polo}}{\omega_p} ,\frac{\omega_p}{\omega_s} \right),\epsilon_p \epsilon_s \right)=\frac{j}{\epsilon_p}$$]De nuevo elegimos el periodo real.[$$ n \frac{K(\epsilon_p \epsilon_s )}{K(\frac{\omega_p}{\omega_s})} arccd \left(\frac{-js_{polo\ m}}{\omega_p} ,\frac{\omega_p}{\omega_s}\right)=arccd\left(\frac{j}{\epsilon_p} ,\epsilon_p \epsilon_s \right)+2mK(\epsilon_p \epsilon_s )$$]Y despejamos[$$s_{polo\ m}=j \omega_p cd\left(\frac{K(\frac{\omega_p}{\omega_s})}{n\ K(\epsilon_p \epsilon_s ) } \left[arccd\left(\frac{j}{\epsilon_p} ,\epsilon_p \epsilon_s \right)+2mK(\epsilon_p \epsilon_s ) \right] ,\frac{\omega_p}{\omega_s}\right )$$]
Así podemos construir la magnitud de la función de transferencia al cuadrado a falta de la constante multiplicativa. [$$ |H(s) |^2=A^2 \frac{\prod{(s-s_{cero\ m})}}{\prod{(s-s_{polo\ m})}}$$] La constante se halla haciendo [$s=0$] en la expresión de [$|H(s) |^2$] basada en [$R_n^2$] e igualándola con la de arriba. [$$ |H(0) |^2=A^2 \frac{\prod{(0-s_{cero\ m})}}{\prod{(0-s_{polo\ m})}}=\frac{1}{1+\epsilon_p^2 R_n^2 (0,\frac{\omega_p}{\omega_s} ,\epsilon_p \epsilon_s ) }$$] Finalmente, se toman los polos con parte real menor que cero para conseguir que pueda ser realizado en la práctica.

Epílogo

Si el lector compara, para un mismo conjunto de especificaciones, los órdenes que se requieren de los filtros, verá que el filtro de Cauer mejora los otros dos tipos de filtros.

Debido a que el orden del filtro está relacionado con el número de componentes que se necesitan para hacer un circuito eléctrico del filtro, es inmediato llegar a la conclusión de que los filtros de Cauer son más económicos.

Esa es la razón por la que Cauer conseguía un filtro con las mismas prestaciones, pero con una bobina menos.

lunes, 22 de agosto de 2011

Lo que nunca me enseñaron: Los filtros de Cauer (parte III)

La primera parte está aquí y la segunda parte aquí.

Los viajes del arcocoseno

Hasta aquí todo lo visto ha sido para entender el proceso de realización de un filtro. A partir de aquí empezamos a acercarnos a los filtros elípticos. Sin embargo, antes debemos pararnos a explorar los filtros de Chebyshev. Los filtros de Chebyshev son más simples porque usan para su expresión matemática la circunferencia en vez de la elipse. Deberían llamarse filtros circulares, pero ya se ha quedado el nombre de Chebyshev.

Lo primero que necesitamos para entender los filtros de Chebyshev es la definición de arcocoseno. [$$arccos(x)=\int_x^1{\frac{dt}{\sqrt{1-t^2}}}$$] Esta integral no es más que la longitud de arco de una circunferencia unitaria desde una abscisa [$x$]. (Nota: Por supuesto, es una función multivaluada. Tomaremos sólo la rama de la raíz principal aquí).

El arcocoseno no es más que la longitud del arco marcado.

Lo sorprendente es que esta integral, el arcocoseno, tiene sentido cuando [$x$] va más allá de [$\pm 1$]. Eso sí, hemos de usar números complejos porque el radicando que aparece en la raíz se hace negativo.
Dibujaremos el valor que toma el arcocoseno en el plano de Argand conforme [$x$] tome valores reales. Empezaremos por el arcocoseno de cero que es [$\pi/2$].

El arcocoseno de cero es [$\pi/2$].

Si vamos aumentando [$x$], llegamos hasta [$arccos(1)=0$] obteniendo únicamente números reales. Es el arcocoseno clásico. Igualmente, si disminuimos [$x$], llegamos hasta [$arccos(-1)=\pi$]. Esta simetría continuará por lo que no hablaremos más de los valores negativos de [$x$].

El recorrido desde el arcocoseno de cero al arcocoseno de uno (y menos uno).

En el punto [$arccos(1)=0$] ocurre que la raíz del integrando se anula. [$$\sqrt{1-t^2 }=0$$] Si seguimos moviendo [$x$] por la recta real, el arcocoseno entrará en el eje imaginario. A partir de aquí tenemos otras dos ramas, la raíz positiva y la negativa. Elegimos la positiva y recordamos para luego que hay simetrías.
El recorrido del valor del arcoseno de los números reales.


Las olas del coseno

En los complejos, el coseno es una función holomorfa. Una de sus particularidades es la periodicidad en el eje real. Si trazamos su diagrama de ceros (no tiene polos) y añadimos algunos puntos destacados en la línea real obtenemos lo siguiente.

Los valores destacados que toma el coseno cuando su argumento es un número complejo.


Si recorremos el plano de Argand por la línea real [$x=\sigma$], obtenemos la función coseno clásica. El lado más oscuro corresponde a los valores negativos.


Los valores del coseno cuando su argumento es un número real ([$\omega=0$])


Si recorremos el coseno por la recta imaginaria obtenemos el coseno hiperbólico. Es importante darse cuenta que por estos dos recorridos el coseno siempre proporciona un valor real.

Los valores del coseno cuando su argumento es un número imaginario ([$\sigma=0$])


Como era de esperar, al ser el arcocoseno la función inversa del coseno, si hacemos el recorrido del arcocoseno desde 0 hasta infinito, vamos visitando los argumentos cuyo coseno se mueve desde 0 hasta infinito.

Los valores del arcocoseno recorren los argumentos del coseno cuyo resultado es el argumento del arcocoseno. Son funciones inversas una de otra.


Los polinomios de Chebyshev

Los polinomios de Chebyshev se definen así: [$$C_n (x)=cos(n\ arccos(x) )$$] Para ver cómo son, observemos el recorrido de [$n\ arccos(x)$] sobre la función coseno. Es muy sencillo porque lo único que hacemos al multiplicar por [$n$] es ampliar fotográficamente [$n$] veces el recorrido del arcocoseno. En el siguiente diagrama usamos [$n=3$].

El polinomio de Chebyshev de orden tres se obtiene ampliando por tres el recorrido del arcocoseno (la gráfica de abajo) y, luego, realizar el coseno (las dos gráficas de arriba).


Ampliar tres veces el recorrido no cambia mucho el valor del coseno por la recta imaginaria. Lo hace más abrupto porque nos movemos más rápidamente hacia el infinito. En donde sí que hay un cambio es en la parte real donde tenemos tres cuartos de pi en vez de uno. Esto hace que se oscile en esa parte.

Recordemos que en estas rectas todos los valores del coseno son reales y que hay otra parte simétrica cuando [$t\lt 0$]. Con esto en mente podemos dibujar [$C_3$].

Polinomio de Chebyshev de orden tres.


Observando con cuidado el recorrido de arriba, vemos que atraviesa exactamente 3 ceros del coseno: el [$\pi/2$] y su simétrico en [$5 \pi/2$] y el [$3 \pi/2$] que es su propio simétrico. Además, no es casual que los puntos donde [$x=\pm 1$] tome el valor [$y= \pm 1$] ya que son los puntos de arcocoseno nulo.

Una manera fácil de calcular los polinomios de Chebyshev es la siguiente. [$$C_{n+1} (x)=cos(n\ arccos(x)+arccos(x) )=x C_n (x)+sin(n\ arccos(x) ) sin(arccos (x) )$$][$$ C_{n-1}(x)=cos(n\ arccos(x)-arccos(x) )=x C_n (x)-sin(n\ arccos(x) ) sin(arccos(x) )$$] Sumando se llega a [$C_{n+1} (x)+C_{n-1} (x)=2 x C_n (x)$] y despejando [$C_{n+1} (x)$] se obtiene la siguiente fórmula recursiva. [$$C_{n+1} (x)=2 C_n (x) - C_{n-1} (x)$$] Usando la definición se obtiene que [$C_0 (x)=1$] y [$C_1 (x)=x$] con lo que tenemos todos los datos para calcular el polinomio de Chebyshev del orden que queramos.

El filtro de Chebyshev

La función [$C_n^2 (\omega)$] es una buena aproximación de [$F^2 (\omega)$]. Dibujemos su gráfica para n=3.

El polinomio de Chebyshev de tercer grado al cuadrado como aproximación a [$F^2(\omega)$].


Para que cumpla los requisitos de un filtro hay que ajustarla un poco. [$$ F^2 (\omega)=\epsilon_p^2 C_n^2 \left(\frac{\omega}{\omega_p} \right)$$]
La función [$F^2(\omega)$] de un filtro de Chebyshev.


Así que un filtro de Chebyshev es el que tiene la siguiente respuesta en frecuencia al cuadrado. [$$ |H(j\omega) |^2=\frac{1}{1+\epsilon_p^2 C_n^2 \left(\frac{\omega}{\omega_p} \right)}$$] A partir de aquí procedemos como en el filtro de Butterworth. Calculamos [$\epsilon_s$], despejamos [$n$] para el orden; calculamos los polos de [$|H(s) |^2$] (este filtro no tiene ceros) y separamos los polos para obtener [$H(s)$].

Todo esto lo dejaremos para el lector que observará, entre otras cosas, que el orden requerido es menor en un filtro de Chebyshev que en un filtro de Butterworth para los mismos requisitos.

El lector curioso queda emplazado para explorar los filtros inversos de Chebyshev e intentar usar la misma técnica de inversión para los filtros de Butterworth.

Continúa y acaba en la cuarta parte.

viernes, 19 de agosto de 2011

Lo que nunca me enseñaron: Los filtros de Cauer (parte II)

Parte 1 aquí.

El filtro de Butterworth

Aproximar la función [$F^2 (\omega)$] que debería valer 0 si [$\omega < \omega_p$] e infinito si [$\omega > \omega_s$] es muy sencillo. Todas las funciones monótonas (siempre crecientes) lo aproximan con más o menos éxito.

Una [$F^2 (\omega)$] muy usada es [$$F^2 (\omega)=  \epsilon  _p^2 \left(\frac{ \omega }{  \omega_p } \right)^{2n}$$] Este es el llamado filtro de Butterwoth. El número [$n$] es el orden del filtro. Debido a que debemos trabajar con polinomios, las potencias han de ser números naturales y, por tanto, el orden del filtro n debe ser un número natural. El orden del filtro está relacionado con el número de componentes eléctricos que va a tener nuestro circuito.

Construyamos su respuesta en frecuencia al cuadrado. [$$ |H(j\omega)|^2=\frac{1}{1+\epsilon_p^2 \left(\omega/\omega_p \right)^{2n}}$$] El filtrado de frecuencias que hace este filtro se muestra a continuación. Esta gráfica es la original del artículo de Butterworth de 1930 y representa [$|H(j\omega)|$] con [$\omega_p=1$].

Respuesta en frecuencia de un filtro de Butterworth tal cual aparecía en su artículo de 1930.


El valor [$\epsilon_p$] está explícitamente escrito en la ecuación, pero no sabemos nada de [$\epsilon_s$]. Hemos de usar la expresión de [$|H(j\omega) |^2$] para deducir qué valor tendremos para [$\epsilon_s$]. Bastará calcular la respuesta en frecuencia a la frecuencia [$\omega_s$]. [$$|H(j\omega_s ) |^2=\frac{1}{1+\epsilon_p^2 \left(\omega_s/\omega_p\right)^{2n}} = \frac{\epsilon_s^2}{1+\epsilon_s^2}$$][$$ \frac{1}{\epsilon_s^2}=\epsilon_p^2 \left(\frac{\omega_s}{\omega_p}\right)^{2n},\ \ \ \ \epsilon_s \epsilon_p=\left( \frac{\omega_p}{\omega_s}\right) ^n$$] Esta última expresión, muy simple gracias a la introducción de los épsilon en la parte anterior, relaciona el orden del filtro con los requisitos. Como el orden del filtro ha de ser un natural, es usual escribir la ecuación como una cota. [$$ n \ge \frac{log(\epsilon_s \epsilon_p)}{log \left( \frac{\omega_p}{\omega_s} \right) } $$]

Polos y ceros

La función [$|H(j\omega) |^2$] está relacionada con la respuesta en frecuencia del filtro [$|H(j\omega) |$] sin cuadrado, pero lo que nos interesa para poder implementar el filtro es la función de transferencia [$H(s)$] que abarca todos los complejos. Los pasos son los siguientes.

Primero, con un cambio de variables [$\omega=-js$], convertimos [$|H(j\omega) |^2$] en [$|H(s) |^2$].  [$$ |H(s)|^2=\frac{1}{1+\epsilon_p^2 \left(-js/\omega_p \right)^{2n}}$$]
A continuación, obtendremos la función [$|H(s) |^2$] como un cociente de dos polinomios. Escribiremos los polinomios factorizando sus raíces. [$$|H(s) |^2=A^2 \frac{\prod{s-s_{cero m} }}{\prod{s-s_{polo m} }}$$] Las raíces del numerador se llaman ceros porque cuando [$s$] sea un [$s_{cero}$], tendremos que [$|H(s) |^2=0$]. Las raíces del denominador se llaman polos porque cuando [$s$] tienda a un [$s_{polo}$], todo [$|H(s) |^2$] tiende a infinito. El por qué se llaman polos es obvio cuando se hace la gráfica en tres dimensiones.

Visión 3D de la función de transferencia de un filtro de Butterworth. Se observan los polos y la respuesta en frecuencia cuya parte positiva está remarcada en rojo.


Los filtros de Butterworth no tienen ceros. Esto ocurre porque el numerador de [$|H(s) |^2$] es uno. Pero sí tienen polos cuando el denominador se anula. Es decir, cuando [$F^2 (\omega)=-1$].[$$F^2 (-js_{polo} )=-1$$][$$\epsilon_p^2 \left(\frac{-js_{polo}}{\omega_p}\right)^{2n}=-1$$][$$\epsilon_p \left(\frac{-js_{polo}}{\omega_p}\right)^n=j$$][$$  \sqrt[n]{\epsilon_p}\frac{-js_{polo}}{\omega_p}=\sqrt[n]{j}$$][$$s_{polo}=\frac{j \omega_p}{\sqrt[n]{\epsilon_p}} \sqrt[n]{j}$$]
Usando las raíces de la unidad, llegamos a que los polos de [$|H(s) |^2$] yacen en un círculo. Como hay más de uno, los numeramos con un subíndice [$m$]. [$$s_{polo\ m}=\omega_p \epsilon_p^{\frac{-1}{n}} e^{j\left[\frac{p}{2}+\frac{p}{2n}+\frac{2p}{n} m\right]}$$] Es interesante localizar los polos en el plano de Argand (plano complejo). El siguiente diagrama muestra los polos de [$|H(s) |^2$] de un filtro de Butterworth de orden tres.

Distribución de los polos de la función de transferencia al cuadrado de un filtro de Butterworth de orden tres.


Obteniendo la función de transferencia

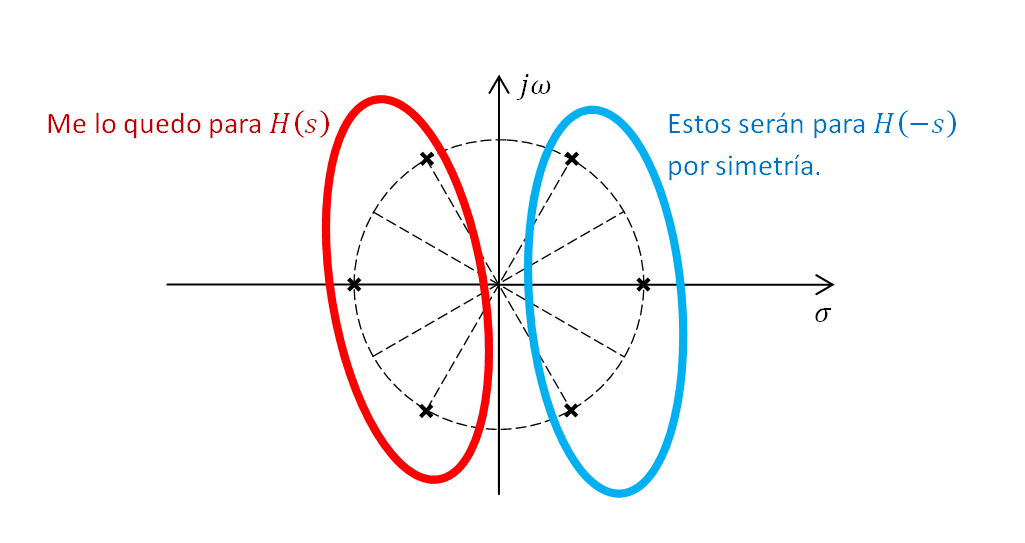
La simetría que aparece en el diagrama anterior es usual en [$|H(s) |^2$] y se llama simetría cuadrantal. Ocurre que [$$|H(s) |^2=|H(-s) |^2=|H(s^* ) |^2$$] por lo que la función [$|H(s) |^2$] queda completamente definida por lo que pase en sólo uno de sus cuadrantes. Esta simetría se usa para obtener [$H(s)$] a partir de [$|H(s) |^2$] mediante la siguiente ecuación: [$$|H(s) |^2=H(s)H(-s)$$] Recordemos que [$|H(s) |^2$] estaba descrita como un producto de polos y ceros. Entonces, podemos separar los polos que van para [$H(s)$] y los que van para [$H(-s)$].[$$ A^2 \frac{\prod{(s-s_{cero\ m})}}{\prod{(s-s_{polo\ m})}}=\left[A \frac{\prod{(s-s_{cero\ de\ H(s)\ m})}}{\prod{(s-s_{polo\ de\ H(s)\ m} )}}\right]\left[A \frac{\prod{(s-s_{cero\ de\ H(-s)\ m} )} }{\prod{(s-s_{polo\ de\ H(-s)\ m}) } }\right]$$] Lo que sí que hay que decidir es qué polos van para [$H(s)$] y qué polos van para [$H(-s)$]. Es fácil. Para que [$H(s)$] sea realizable físicamente y estable, hay que escoger los polos cuya parte real sea negativa. Y para que el filtro sea de fase mínima (menor dispersión) también cogeremos los ceros que tengan su parte real negativa.

Separación de los polos de [$|H(s)|^2$] que van para [$H(s)$] de los que van para [$H(-s)$].


Una vez tenemos [$H(s)$] podemos usar alguna de las técnicas de síntesis de circuitos para realizar el filtro.

Continúa en la parte tres.