miércoles, 24 de noviembre de 2010

Por qué no sumar FPS y la ley de Amdahl

Hace poco leí de un desarrollador de videojuegos algo así como "cuando uso el nuevo método, pierdo 30 FPS". Los FPS son los fotogramas por segundo. Es decir, son una frecuencia. Generalmente la suma y las frecuencias se llevan mal y este es un buen ejemplo de por qué no es válido sumar.

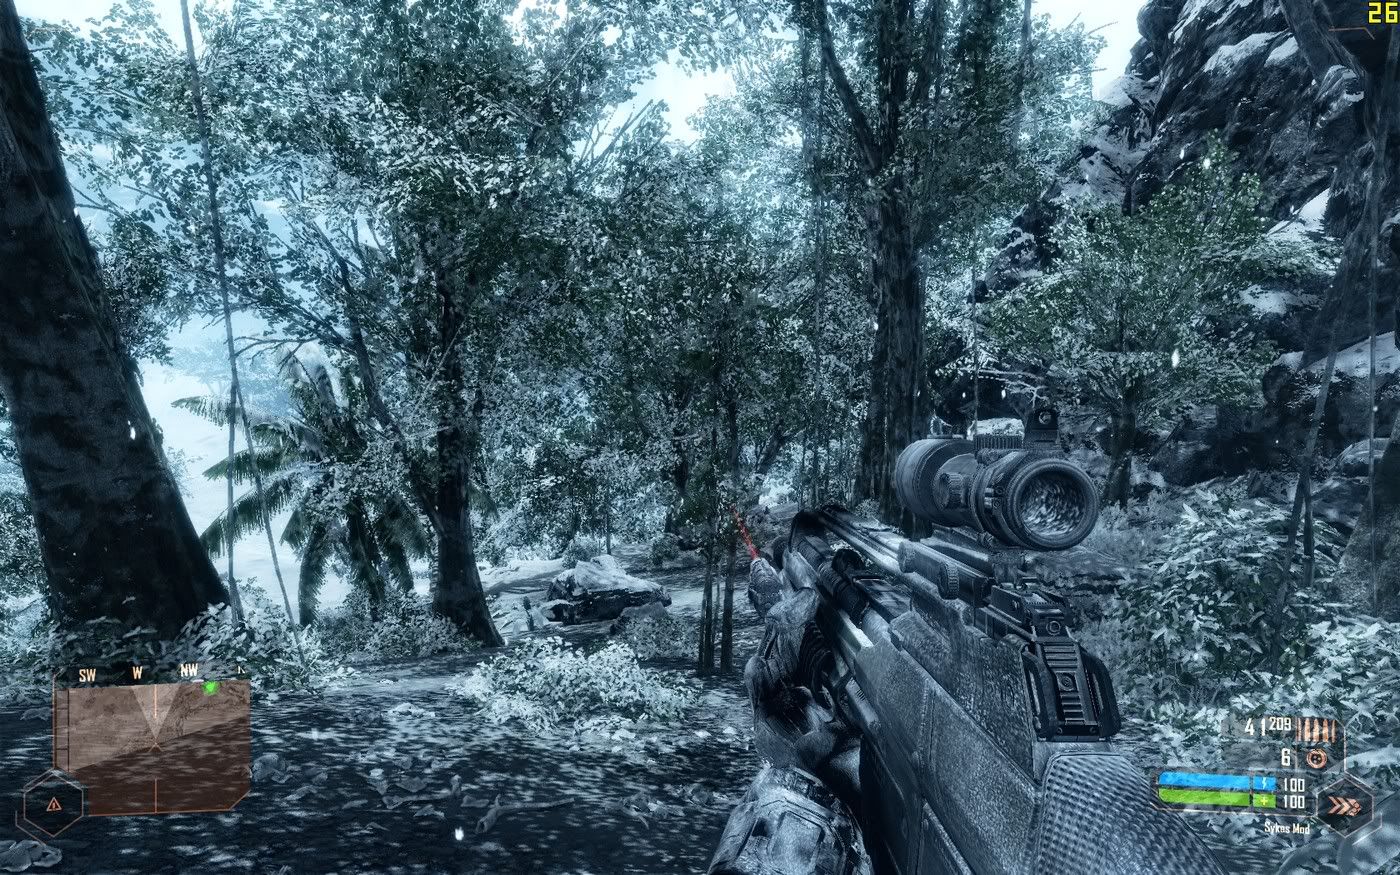
Pantalla del Crysis con grandes cantidades de vegetación que ralentizan el renderizado bajando los FPS a lo mínimo imprescindible para que la vista sea suave: 26, la cifra en la esquina superior derecha. El estándar de cine es de 24 FPS, pero las imágenes suelen contener movimiento. Generalmente esto es muy costoso de conseguir en tiempo real por lo que en los videojuegos el resultado es más brusco a esa misma tasa de fotogramas.


Al trabajar con frecuencias contamos cuántas veces podemos realizar una operación que dura [$ t $] segundos. La frecuencia será precisamente
[$$ f=\frac{1}{t} $$]
Si añado algo a esa operación, me durará lo que duraba antes más el añadido [$ t+a $]. La nueva frecuencia será
[$$ f_a=\frac{1}{t+a} $$]

Generalmente no añadimos o quitamos nada. Simplemente, al cambiar una parte de nuestra operación, ésta se hace más larga o más corta. Es lo que pasaba con el desarrollador de videojuegos que cambiaba la manera de hacer algo y cambiaba su frecuencia de desempeño.

Supongamos que de todo ese tiempo [$ t $] solamente la fracción [$ p $] es la parte que tocamos. Esto quiere decir que la parte tarda en ejecutarse [$ tp $] y todo lo que no es la parte cambiada es [$ t(1-p) $].

El cambio que hago será probablemente una mejora. Si antes de la mejora tardaba [$ tp $] en realizar la operación de la parte a cambiar, después de una mejora de [$s$] veces tardará [$s$] veces menos. Es decir,

[$$ \frac{tp}{s} $$]

Como bien se sabe, en computación mejorar es ir más rápido haciendo algo. Tardamos menos tiempo así que dividimos. Ir el doble de rápido significa tardar la mitad.

Ahora voy a sumar los tiempos que tardo en la parte no mejorada y la parte mejorada. Es esta expresión:

[$$ \frac{tp}{s}+t(1-p) = t\left( \frac{p}{s} + (1-p) \right)$$]

Finalmente voy a obtener en vez del tiempo que tardo en hacer la operación completa, cuántas veces voy a poder realizarla. Esto es la frecuencia con mejora [$ f_s $].

[$$ f_s = \frac{1}{ t\left( \frac{p}{s} + (1-p) \right) } $$]

Afortunadamente podemos expresar esta frecuencia con mejora en función de la frecuencia sin mejora.

[$$ f_s = f \frac{1}{ \frac{p}{s} + (1-p) } $$]

El factor de mejora no es una suma como decía el desarrollador de videojuegos al hablar de FPS. El factor de mejora es una constante multiplicativa. Precisamente es

[$$ A =  \frac{1}{ \frac{p}{s} + (1-p) } $$]

Esta expresión es la conocida Ley de Amdahl y el factor que calcula puede escribirse como un tanto por ciento. Habría sido más correcto entonces que el desarrollador de videojuegos hubiese dicho que perdía el 30% de rendimiento con el nuevo método.

miércoles, 17 de noviembre de 2010

miniSL parte 6 - Campos de celda

En las entradas anteriores hemos decidido los tipos de celdas que tenemos. Falta por saber qué información guarda cada uno de estos tipos. Está claro que, por lo menos, toda celda ha de guardar el tipo de celda que es. De esta manera lo que tendremos es una unión etiquetada.

Además, necesitaremos según el tipo:
  • UNUSED: Un puntero a la siguiente celda sin usar. De esta manera mantenemos una lista simplemente enlazada de las celdas sin usar.
  • EMPTY_LIT: La lista vacía no requiere ningún valor adicional.
  • INT_LIT: Un literal entero requiere el valor entero que almacena.
  • STRING_LIT: Un literal de cadena requiere la cadena que almacena.
  • LAMBDA_VAL: Un valor de función definida por el usuario requiere tres cosas: el código a ejecutar, los parámetros que tiene la función y la clausura léxica del código. Usaremos una lista para agrupar el código con los parámetros por lo que sólo requeriremos dos valores.
  • NATIVE_VAL: Un puntero a la función nativa.
  • ENVIR_VAL: Un puntero a la tabla hash o árbol de búsqueda que relaciona los nombres de las variables con sus valores. Además, otro puntero a el entorno padre (si existe) donde se buscarán los nombres que no se encuentren en la tabla de éste.
  • BOOL_VAL: El valor verdadero o falso del booleano.
  • NAME_CODE: Un puntero a la cadena con el nombre de la variable.
  • COMBINE_CODE: El operador y sus operandos en una lista.
  • CONS_CTOR: La cabeza y el resto de la lista.
Adicionalmente, vamos a guardar en cada celda un bit con la marca del recolector de basura. Esta marca significa que la celda está en uso y no se puede borrar.

Con todas estos campos en la cabeza, la estructura de una celda queda así:

struct CELL
{
 CELL_TYPE type;
 bool mark;    //Garbage collection mark
 union
 {
  CELL* next_unused;   //UNUSED
  int int_val;    //INT_LIT
  bool bool_val;    //BOOL_VAL
  STRING const* string_val; //STRING_LIT
  CELL* head;     //CONS.
  CELL* code;     //LAMBDA_VAL. The cell must be a CONS_CTOR with parameters and body
  NATIVE native;    //NATIVE_VAL
  ENVIR_TABLE* envir_table; //ENVIR_VAL
  CELL* op;     //COMBINE_CODE. The cell must be code (Any *_CODE type or CONS or EMPTY)
 };

 union
 {
  CELL* tail;   //CONS. Must be CONS or EMPTY.
  CELL* closure;  //LAMBDA_VAL. The cell must be an environment (ENVIR_VAL)
  CELL* parent_envir; //ENVIR_VAL. The pointer may be NULL or an environment cell (ENVIR_VAL)
  CELL* operands;  //COMBINE_CODE. The cell must be a list of code.
 };
};

La mayoría de los tipos de C++ que hemos usado han quedado por definir. En principio dependerán de la plataforma.

typedef std::wstring STRING;
typedef std::wistream ISTREAM;
typedef std::wostream OSTREAM;
typedef std::map<STRING, CELL*> STRING_MAP;
typedef std::map<CELL*, CELL*> ENVIR_TABLE;
typedef std::deque<CELL> CELL_STORAGE;
typedef CELL& (*NATIVE) (Script& script, CELL& args, CELL& envir);

En la siguiente entrada hablaremos con más tranquilidad de STRING_MAP y ENVIR_TABLE; en otra posterior hablaremos de CELL_STORAGE y, mucho después, de NATIVE, ISTREAM y OSTREAM.

miércoles, 10 de noviembre de 2010

Asincronía en C# 5.0

En octubre Eric Lippert empezó una serie en su blog dedicada a la nueva característica de C#: la posibilidad de escribir programas asíncronos. Es un paso lógico tras los cambios producidos en las versiones anteriores de C#.

¿Qué tienen en común las siguientes características de C#? (Todas convenientemente explicadas por Eric)
  1. Los iteradores
  2. Métodos anónimos
  3. LINQ
  4. Asincronía
Muy sencillo. Todas estas características se obtienen mediante una transformación sintáctica del código. Es decir. No hay una nueva semántica, sólo transformaciones sintácticas. ¿Y por qué es esto relevante? Porque se habrían evitado todo el follón si hubieran introducido un mecanismo de macros en el lenguaje. No algo tan crudo como el preprocesador de C. Quizás algo como los patrones de C++. O, mucho mejor, algo como las macros del LISP o Scheme.

Si es que al final volvemos al principio.

jueves, 4 de noviembre de 2010

miniSL parte 5 - Tipos de celda

Como se comentó anteriormente, nuestra implementación de lenguaje script no sólo requiere almacenar valores, también requiere almacenar código o el estado de la ejecución. Esto se consigue mediante el uso de celdas (CELL).

Ahora que conocemos la sintaxis, sabemos qué tipos de celdas necesitamos para almacenar el código. De hecho, cada tipo de nodo del AST tendrá que ser una celda así que tenemos los siguientes tipos de celdas por ahora:

enum CELL_TYPE
{
UNUSED, 

//Literals
EMPTY_LIT, INT_LIT, STRING_LIT,

//Value constructors

//Code constructors
NAME_CODE, COMBINE_CODE,

//Value and code constructors
CONS_CTOR
};

Finalmente debemos saber cuáles van a ser los resultados de nuestras evaluaciones. Aparte de los literales, usaremos tres valores.
  1. Los booleanos. 
  2. Las funciones definidas por el usuario (lambda).
  3. Las funciones predefinidas (nativas).
Para las evaluaciones, además, necesitamos un contexto que guarde la relación entre los nombres de las variables y el valor vinculado a ellas. Son los entornos de ejecución. En definitiva, los tipos de celdas que tenemos son:

enum CELL_TYPE
{
UNUSED, 

//Literals
EMPTY_LIT, INT_LIT, STRING_LIT,

//Value constructors
LAMBDA_VAL, NATIVE_VAL, ENVIR_VAL, BOOL_VAL, 

//Code constructors
NAME_CODE, COMBINE_CODE,

//Value and code constructors
CONS_CTOR
};

Ahora nos queda por saber qué información requiere cada tipo de celda y cómo vamos a almacenarla.

sábado, 30 de octubre de 2010

miniSL parte 4 - Sintaxis

El gran problema que tiene el LISP, desde el punto de vista humano, es su sintaxis uniforme. Por otra parte, esa es su gran ventaja a la hora de implementarlo o extenderlo. Conforme vayamos complicando la sintaxis, y esta sea adecuada, se facilitará la lectura y se dificultará su procesado.

Todo lenguaje de programación se puede reducir a una serie de combinaciones de operadores con sus operandos. En LISP esa combinación la produce la lista.

( operador operando1 operando2 … operandoN )

Si queremos introducir expresiones infijas y prefijas, necesitamos separar la lista por comas. En caso de no hacerlo, tendríamos la siguiente ambigüedad:

( operador 1 + 2 )
( operador 1 [+2] )
( operador [1+2] )

Una vez separada por comas, no hay dificultades en resolver la ambigüedad anterior.

( operador, 1, +2 )
( operador, 1+2 )

Es habitual usar la combinación preponiendo el operador y esa será nuestra sintaxis básica.

operador(1, +2)

Esta sintaxis es similar a las expresiones M del LISP y, al usarla, perdemos algo de la homoiconicidad. Es decir, la representación en memoria se aleja de la representación textual del código.

Mezclando operadores infijos, prefijos y postfijos obtenemos esta gramática informal.

exp             -> infija
infija          -> prefija | infija SIMBOLO infija
prefija         -> postfija | SIMBOLO prefija
postfija        -> primaria | postfija "(" lista_operandos? ")"
primaria        -> ENTERO | CADENA | NOMBRE | "(" exp ")"
lista_operandos -> exp | exp "," lista_operandos

Los SIMBOLOs son cadenas de

 !%&*+-/<=>?^|~

Más adelante estableceremos algunas restricciones sobre los símbolos. Los nombres cadenas de letras, dígitos y subrayado que no empiecen por dígitos. Las cadenas se expresarán entre comillas.

"Escribiremos las cadenas así"

Nada de esto está especificado en la gramática de arriba donde hemos usado los token SIMBOLO, ENTERO, CADENA y NOMBRE en los casos descritos. Por ahora no profundizaré en este aspecto ya que nos interesa saber cómo va a ser el AST, no cómo va a ser el análisis léxico (escaneado).

Todas las operaciones generan una combinación. Eso quiere decir que 1+2 se transforma en +(1,2) y que -7 se transforma en -(7). De esta manera, se consigue uniformidad en la representación pero legibilidad en el código. El resultado es que, tras estas transformaciones, toda la sintaxis se puede describir con cuatro tipos de nodos.
  1. Valores literales como 1 u "hola".
  2. Nombres como f o x.
  3. Combinaciones como f(x, x).
  4. Listas para almacenar la lista de operadores de una combinación. Aprovecharemos también para representar listas así [1, "hola", x].
Entonces, cuando escribimos f(1+2), se transforma en f(+(1,2)) y se representa en un árbol sintáctico con los siguientes nodos.
  1. Nodo de nombre f.
  2. Node de nombre +.
  3. Nodo de literal entero 1.
  4. Nodo de literal entero 2.
  5. Nodo de lista vacía. Esto es la lista [].
  6. Nodo de construcción de lista a partir de los nodos 4 y 5. Esto es la lista [2].
  7. Nodo de construcción de lista a partir de los nodos 3 y 6. Esto es la lista [1,2].
  8. Nodo de combinación a partir de los nodos 2 y 7. Esto es la combinación +(1,2).
  9. Nodo de combinación a partir de los nodos 1 y 8. Esto es la combinación f(+(1,2)).
En la siguiente entrada veremos cómo construir el árbol sintáctico usando celdas en un montículo de forma similar a como hicimos en el LISP.

jueves, 28 de octubre de 2010

Semántica operacional de continuaciones

He encontrado una semántica operacional para las continuaciones que es muy simple de entender.

Sintaxis

Su sintaxis es la siguiente:


[$$ t::= x \mid \lambda x.t \mid tt \mid callcc \mid \#e $$]

Esto quiere decir que un término será o bien una variable, o bien una abstracción lambda, o bien una aplicación de un término sobre otro, o bien una llamada a call/cc o bien una continuación (con el [$ \# $] delante).

Como se observa, las continuaciones hacen uso de una nueva categoría sintáctica [$ e $]. Esta es la categoría de los términos con hueco. Debido a que vamos a evaluar primero el operador y luego el operando, en la última aplicación de esta categoría requerimos un valor a la izquierda.


[$$ e::= [] \mid et \mid ve $$]

Los valores son los ya conocidos más una continuación.

[$$ v::= \lambda x.t \mid x v_1 ... v_n \mid \#e $$]

Así que, en el fondo, una continuación no es más que una expresión con un hueco. Ese hueco hay que rellenarlo cuando utilicemos la continuación. Para eso hemos de definir primero la semántica.

Semántica

Esta semántica hace uso de los propios términos con hueco. Cuando escribimos [$ e[t] $] lo que queremos decir es un término con hueco [$ e $] rellenado el hueco con el término [$ t $]. En este caso, la regla β queda así:

[$$ e[(\lambda x.t)v] \rightarrow e[ [x \mapsto v] t] $$]

Que no es más que decir: allá donde haya una aplicación de una abstracción sobre un valor, sustitúyela por el término de la aplicación cambiando la variable ligada por el valor. Esta regla es usual en el lambda cálculo, aunque dentro de un término con hueco hecho explícito, así que no comentaré nada más.

El meollo del asunto está en modificar ese término con hueco y para eso usamos call/cc y la continuación.

[$$ e[callcc\ t] \rightarrow e[t (\#e)] $$]
[$$ e[(\#e') v] \rightarrow e'[v] $$]

Lo que hace call/cc es recordar el término con hueco, guardándolo en la continuación. Lo que hace la continuación es volver a ese término con hueco.

Ejemplo

De esta manera, usando las continuaciones, se pueden implementar las sentencias de control que queramos. Por ejemplo, un bucle, si suponemos que tenemos secuencia, variables y condicionales.

[$$ n=0;\ k=callcc\ (\lambda x. x)\ ;\ if\ n<5\ \{\ print\ n\ ;\ n=n+1\ ;\ k\ 0\ \} $$]

Evalúo [$ n=0 $]. Ahora [$ n $] vale [$ 0 $].

[$$ k=callcc\ (\lambda x. x)\ ;\ if\ n<5\ \{\ print\ n\ ;\ n=n+1\ ;\ k\ 0\ \} $$]

Evalúo [$ callcc $]. Es un paso importante porque todo lo que hay alrededor del call/cc pasa a ser la continuación.

[$$ k\ =\ (\lambda x. x)\ (\#\ []\ ;\ if\ n<5\ \{\ print\ n\ ;\ n=n+1\ ;\ k\ 0\ \} )\ ;\ if\ n<5\ \{\ print\ n\ ;\ n=n+1\ ;\ k\ 0\ \} $$]

Evalúo la aplicación de la abstracción lambda con la continuación. Es muy fácil porque es la función identidad por lo que el resultado es la propia continuación.

[$$ k\ =\ (\#\ []\ ;\ if\ n<5\ \{\ print\ n\ ;\ n=n+1\ ;\ k\ 0\ \}\ )\ ;\ if\ n<5\ \{\ print\ n\ ;\ n=n+1\ ;\ k\ 0\ \} $$]

Ahora [$ k $] vale la continuación  [$ \#\ []\ ;\ if\ n<5\ \{\ print\ n\ ;\ n=n+1\ ;\ k\ 0\ \} $].

[$$ if\ n<5\ \{\ print\ n\ ;\ n=n+1\ ;\ k\ 0\ \} $$]

Evalúo el [$ if $] que, al ser cierto, es igual a evaluar su cuerpo.

[$$ print\ n\ ;\ n=n+1\ ;\ k\ 0 $$]

Como [$ n $] valía [$ 0 $], imprimimos un cero.


[$$ n=n+1\ ;\ k\ 0 $$]

Y [$ n $] vale [$ 1 $]

[$$ k\ 0 $$]

Ahora empieza el baile. Debido a que [$ k $] vale la continuación  [$ \#\ []\ ;\ if\ n<5\ \{\ print\ n\ ;\ n=n+1\ ;\ k\ 0\ \} $], evaluamos a:

[$$ (\#\ []\ ;\ if\ n<5\ \{\ print\ n\ ;\ k\ 0\ \})\ 0 $$]

Aplicar la continuación es sustituir toda la expresión por la continuación sustituyendo el hueco por el operando evaluado (ya lo está, es el cero).

[$$ 0\ ;\ if\ n<5\ \{\ print\ n\ ;\ k\ 0\ \} $$]

El cero se ignora en la secuencia y repetimos el bucle con [$ n $] igual a [$ 1 $]. Obviamente, cuando sea [$ 5 $], el cuerpo del [$ if $] no se ejecutará y terminaremos el programa.

miércoles, 27 de octubre de 2010

Arreglado el LaTeX

Al final he usado MathJax para el LaTeX ya que el anterior sistema parece que ha muerto definitivamente. Ha sido un poco tedioso modificar todas las fórmulas, pero poco a poco creo que están todas bien.