lunes, 25 de octubre de 2010

miniSL parte 3 - Celdas

Para cada una de las partes mencionadas anteriormente, tendremos que escribir un programa que tomará una entrada y devolverá una salida.
  • Escaneador: Caracteres a tokens.
  • Reconocedor: Tokens a AST.
  • Generador: AST a código intermedio (o máquina).
  • Ejecución: Código intermedio (o máquina) a valores de resultado.
Debido a que vamos a realizar un intérprete muy simple (el paso 3 se omite y la ejecución evalúa directamente el AST) durante ejecución necesitamos trabajar con dos tipos de objetos: el AST y los valores. Usaremos una misma estructura para almacenar ambos tipos: la celda (CELL). La celda es el nombre usual de la unidad de memoria cuando ésta es uniforme. Ayudará en el futuro para la recolección de basura.

Llamaremos valor a los posibles resultados de la evaluación de cierto código (código=AST). En principio, sólo podremos evaluar el código aunque existen valores que son código y se evalúan a ellos mismos: los literales como el entero 3 o la cadena "hola". Las celdas de valor entero serán del tipo INT_VAL y las cadenas STRING_VAL.


Es probable que necesitemos alguna celda especial de gestión del propio intérprete y que no será ni código ni valor (por ejemplo, una celda sin usar UNUSED). También (y coincidiendo con el LISP) tomaremos el constructor de lista (CONS_CTOR) como código y valor, aunque no es literal ya que lo evaluaremos. Así que, por ahora lo que tendría sería la siguiente clasificación de tipos de celdas.

enum CELL_TYPE
{
UNUSED, 

//Literals
INT_VAL, STRING_VAL,

//Value constructors

//Code constructors

//Value and code constructors
CONS_CTOR,
};

Para terminar de rellenar esta lista de tipos de celda necesitamos saber cómo construir código y eso requiere conocer la sintaxis. Por eso la siguiente entrada de esta serie se dedicará a elegir una sintaxis para nuestro lenguaje script.

lunes, 18 de octubre de 2010

miniSL parte 2 - Pasos a realizar

Un intérprete de un lenguaje de programación, procede en los siguientes pasos (de forma simplificada).

  1. Escaneador (lexer): Leer los caracteres del código fuente y agruparlos en tokens. Los tokens son grupos de caracteres que tienen significado sintáctico. Es usual que el espacio en blanco y los comentarios se ignoren al buscar tokens. También es usual que se realicen ciertas transformaciones como calcular el valor de un número a partir de los caracteres que lo componen.
  2. Reconocedor (parser): Usando la sintaxis, reconstruir el árbol sintáctico del código fuente. Este paso es el reconocimiento y, debido a la simplicidad que queremos en nuestra implementación, en él utilizaremos una sintaxis con una gramática muy fácil de reconocer. En concreto, como veremos más adelante, será una sintaxis LL(1).
  3. Generación de código: Opcionalmente, se puede transformar el árbol sintáctico abstracto en el árbol objetivo abstracto y generar código a partir de él. Este código podrá ser primero un código intermedio a ejecutar en una máquina virtual o a compilar en código máquina y ejecutar en una máquina real. En nuestro lenguaje miniSL no utilizaremos esta transformación y ejecutaremos directamente el árbol sintáctico por simplicidad.
  4. Ejecución: La ejecución del resultado de los pasos anteriores. Esto podrá ser o bien la ejecución del árbol sintáctico, o bien la ejecución en una máquina virtual de un código intermedio generado por el paso 3, o bien la ejecución en una máquina real del código máquina generado por el paso 3. Existe la posibilidad de realizar el paso 3 mientras se ejecuta. Esto ya se comentó en una entrada anterior.
En la siguiente entrada de esta serie empezaremos a pensar en la sintaxis. La sintaxis ha de ser suficientemente simple para poder ser reconocida fácilmente, pero con las características descritas en la primera parte. A partir de la sintaxis decidiremos qué tokens y qué reglas sintácticas vamos a utilizar.

miércoles, 13 de octubre de 2010

miniSL parte 1

Hace algún tiempo escribí una serie de entradas sobre cómo hacer un intérprete LISP. El LISP es un lenguaje perfecto para iniciarse en la escritura de lenguajes de script propios, pero no es excesivamente amistoso a la hora de programar. De hecho, jocosamente se le llama "Lots of Insipid, Stupid Parentheses" que traducido es "montones de insípidos y estúpidos paréntesis" y muchas cosas más. La verdad es que, salvo para los fanáticos, el que sólo haya un tipo de parentización en LISP no ayuda visualmente a comprender la estructura del programa.
  • En LISP se escribe:  (+ (* 5 2) x)
  • Lo que usualmente se escribe como: 5*2+x
El uso de operadores infijos y precedencias despeja la expresión y facilita su lectura. Esto no es gratis. El reconocedor sintáctico (parser) de un lenguaje con operadores infijos y precedencias es algo más complejo. Por eso creo que es muy interesante ver de la manera más simplificada posible cómo funciona un lenguaje script con estas características.

De estas ideas surge miniSL ("mini scripting language" o  "mini lenguaje de script") que, en poco más de mil líneas de código C++, implementa un lenguaje con las siguientes características destacables:
  • Sintaxis no trivial con operadores prefijos, infijos y postfijos.
  • Sentencias de control de selección (if) y bucle (while).
  • Recolección de basura.
  • Manejo explícito de entornos (let).
  • Funciones anónimas (funciones lambda).
  • Bucle REPL.
  • Varios tipos de datos básicos: booleano, entero y cadena.
  • Distinción entre declaración y modificación de variables.
  • Posibilidad de definición de funciones nativas adicionales. 
En la siguiente entrada del blog dedicada a este lenguaje empezaremos con las estructuras de datos que vamos a utilizar.

martes, 5 de octubre de 2010

Enlaces de interés

Muy breve esta vez:

¿Cómo ser un (buen) programador?

¿Cómo es el lenguaje de programación ese? 

¿Uso un lenguaje dinámico o estático?

¿Qué tal programador soy?

jueves, 30 de septiembre de 2010

El isomorfismo de Curry-Howard

Uno de los descubrimientos más impactantes en la lógica del siglo XX es el isomorfismo de Curry-Howard. También llamado la correspondencia de Curry-Howard o, como veremos inmediatamente, tipos como predicados.

Historia

Todo empezó cuando, en 1934, Haskell Curry se fijó en lo siguiente:

Si tengo una función f que toma un valor de tipo A y devuelve un valor de tipo B, su tipo lo escribiré como A -> B. Para indicar que f tiene ese tipo usaré los dos puntos f : A -> B y leeremos "f tiene tipo función de A a B". Escribiré los tipos en mayúsculas y los términos en minúscula. Para aplicar esa función a un término t arbitrario uso la siguiente regla de inferencia:

Si sé que f : A -> B y sé que t : A entonces puedo deducir que f(A) : B.

El golpe de genialidad de Curry consistió en quitar los términos y observar que los tipos solos conforman la regla de inferencia lógica del modus ponens.

Si sé que A implica a B y sé que A es cierto, entonces puedo deducir que B es cierto.

Tras años de trabajo, en 1958, Curry concluyó que no podía expresar la lógica proposicional clásica. Sólo una parte de ella llamada lógica intuicionista. En esta lógica no tenemos el principio del tercero excluido por lo que no podemos realizar demostraciones por reducción al absurdo.

Años más tarde, William Alvin Howard descubrió que no sólo se podía expresar la lógica proposicional intuicionista, sino un gran conjunto de lógicas intuicionistas incluidas las de primer orden y orden superior. Desde entonces se ha extendido aún más la correspondencia y se ha incluido la lógica clásica mediante el uso de continuaciones. De hecho, se han inventado lógicas gracias a la correspondencia.

Explicación

¿Pero cómo es posible que un tipo sea una proposición lógica? En todo caso un tipo es un conjunto de valores o de términos, pero ¿cómo expresar conjunciones o implicaciones? Aunque no lo parezca a primera vista, es relativamente fácil.

Por ejemplo, ¿qué significa cuando decimos 3 : int ? Que tres es un entero, sí. Pero también podemos decir que los enteros tienen algún habitante: existe un valor, el 3, que es un entero y por tanto los enteros no están vacíos. En este sentido el valor 3 sería la demostración de que los enteros están habitados. La proposición int significa "los enteros están habitados". Si nuestro lenguaje de programación no tuviera enteros, int sería falso. Si los tiene, int es cierto.

Entonces, los términos son, por un lado, valores de un tipo y, por otro, demostraciones de que ese tipo no está vacío. Que un tipo no esté vacío significa que, visto como proposición, tiene una demostración y por tanto es cierto en nuestro sistema o lenguaje de programación.

Seguimos: ¿Cómo demuestra una función una implicación? Viendo la regla modus ponens de arriba, la demostración de que B está habitado es f(t) así que lo que hace una función f es, dada una demostración t,  construye otra f(t). O como siempre se ha entendido, dado un valor devuelve otro. Por esta razón demuestra la implicación: dame una demostración de A que te doy otra de B. Si A es cierto, entonces B también.

Hasta ahora tengo predicados constantes como int e implicaciones como A->B. Introduciremos la conjunción A & B. Desde el punto de vista lógico si A & B es cierto es por que A es cierto y B es cierto. Si me pongo a trabajar con las demostraciones necesito la demostración de A y la demostración de B para tener la demostración de A & B. Llamemos a estas demostraciones a : A y b : B. Entonces, un término que agrupa ambas demostraciones es un par (a, b). Por tanto, el tipo conjunción no es más que el tipo de los pares (a, b) : A & B más usualmente llamado producto cartesiano.

De esta forma se pueden obtener todas las conectivas en gran cantidad de lógicas distintas y, lo que es más importante, se estandariza la forma de demostrar las proposiciones en dichas lógicas: Los programas son esas demostraciones.
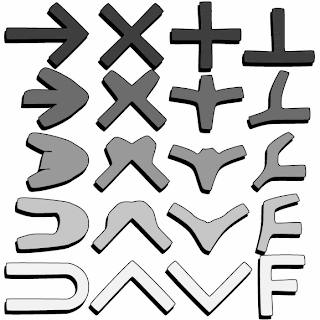
Portada de las actas del congreso LICS'90, humorísticamente titulada el homeomorfismo de Curry-Howard. Los constructores de tipos (arriba) se transforman en las conectivas lógicas (abajo) de forma continua.
  
En acción

Para finalizar vamos a demostrar, usando programas como prueba, que A -> B -> C es lógicamente equivalente a (A & B) -> C. Para esto primero demostraremos ( (A & B) -> C) -> (A -> B -> C) y luego (A -> B -> C) -> ( (A & B) -> C).

λ f. (λ x. λ y. f (x, y) ) : ( (A & B) -> C) -> (A -> B -> C)
λ f. λ x. f (primero x) (segundo x) :  (A -> B -> C) -> ( (A & B) -> C)

Sólo hay que hacer notar que hemos usado las proyecciones de un par: primero (p, q) se evalúa a p y segundo (p, q) se evalúa a q. El resto de la demostración es obvia en el sentido de que el programa que proporciono tiene ese tipo que digo. Para comprobar eso harían falta ciertas reglas de inferencia, pero eso será para otro día.

sábado, 25 de septiembre de 2010

Implementando el algoritmo de la playa de agujas

Ya he hablado de cómo funcionaba el algoritmo de la playa de agujas en una entrada anterior. Hoy voy a especificar el pseudocódigo para definir completamente el algoritmo.

Antes de entrar de lleno en materia, hemos de explicar las funciones y tipos auxiliares que vamos a usar.

  • RESULTADO: El tipo del resultado del algoritmo. Será una expresión parentizada como 1+(2*3).
  • TOKEN: El tipo de los elementos de la entrada podrán ser o bien operandos simples como 1, 2 o 3; o bien operadores como +, * o -.
  • PrioridadDelOperador(t): Si t es un TOKEN de tipo operador, devuelve su prioridad. Los operadores con más prioridad se agrupan antes que los de menos prioridad. 
  • ElSiguienteTokenEsOperador(): Devuelve cierto si el siguiente TOKEN a leer es un operador.
  • LeeOperandoSimple(): Lee de la entrada un operando simple y lo consume quitándolo de la entrada. Falla (y el algoritmo termina con error) si el siguiente TOKEN es un operador.
  • ConsultaSiguienteToken(): Lee sin consumir el siguiente TOKEN de la entrada.
  • ConsumeToken(): Consume el siguiente TOKEN de la entrada quitándolo de la misma.
  • CreaExpresion(operador, operando1, operando2): Crea una expresión parentizada con los operadores y operandos dados. Así, por ejemplo, CreaExpresion(+, 3, 7-2) crea la expresión 3+(7-2).  
Visto todo esto, podemos exponer el algoritmo que llamamos LeeExpresion().

RESULTADO LeeExpresion(int pri_anterior)
{
 RESULTADO a=LeeOperandoSimple();
 if(!ElSiguienteTokenEsOperador())
  return a;

 TOKEN t=ConsultaSiguienteToken();
 int pri_siguiente=PrioridadDelOperador(t);

 if(pri_siguiente<pri_anterior)
  return a;

 ConsumeToken();
 return CreaExpresion(t.data, a, LeeExpresion(prec));
}

Esta implementación funciona muy bien cuando todos los operadores son asociativos por la derecha. Es decir, tendremos que 1+2+3+4 se agrupa como 1+(2+(3+4)). Si queremos operadores que se asocien por la izquierda, necesitamos modificar ligeramente el algoritmo. También necesitamos saber si un operador es asociativo por la derecha o no. Esto lo conoceremos usando OperadorEsAsociativoDerecha(t) donde t es un TOKEN.

Este algoritmo mejorado es el siguiente:

RESULTADO LeeExpresion(int pri_anterior)
{
 RESULTADO a=LeeOperandoSimple();

 while(ElSiguienteTokenEsOperador())
 {
  TOKEN t=ConsultaSiguienteToken();
  int pri_siguiente=PrioridadDelOperador(t);

  if(OperadorEsAsociativoDerecha(t) ? pri_siguiente<pri_anterior : pri_siguiente<=pri_anterior)
   return a;

  ConsumeToken();
  a=CreaExpresion(t.data, a, LeeExpresion(prec));
 }

 return a;
}

Usando estos algoritmos es muy sencillo añadir operadores infijos a un reconocedor descendiente recursivo.

lunes, 20 de septiembre de 2010

Fallo de LaTeX

Me he dado cuenta que el renderizador de LaTeX no funciona. Leyendo en el blog del autor parece ser que tiene problemas por sobrepaso de quota en disco duro. Según dice, está trabajando en cambiar el motor de renderización de LatexRender a mimeTex. Esperemos que tarde poco.