Mostrando entradas con la etiqueta ensamblador. Mostrar todas las entradas

miércoles, 18 de diciembre de 2013

La historia de Mel

Una historia clásica de un pasado mejor. Nada mejor para estas fiestas navideñas. Citado de aquí.


Fuente: utastro!nather (Ed Nather), 21 de Mayo de 1983.


La historia de Mel


En un artículo reciente, hablando del lado macho de la programación, se hizo la simple y llana afirmación:

Los Verdaderos Programadores escriben en FORTRAN

Quizá lo hagan ahora, en esta era decadente de cerveza sin alcohol, calculadoras de bolsillo y programas "user-friendly" pero en los Viejos Buenos Tiempos, cuando el término "software" sonaba a broma y los Verdaderos Ordenadores estaban hechos de tambores y tubos de vacío los Verdaderos Programadores escribían en código máquina. No FORTRAN. No RATFOR. Ni siquiera ensamblador. Código máquina. Crudos, sin adornos, inescrutables números hexadecimales. Directamente

Toda una nueva generación de programadores creció en la ignorancia de este glorioso pasado, por lo que me siento obligado a describir, tan bien como me sea posible debido al salto generacional, cómo un Verdadero Programador escribía código.

Le llamaré Mel, porque ese era su nombre.


Conocí a Mel cuando empecé a trabajar para Royal McBee Computer Corp., una extinta subsidiaria de una compañía de maquinas de escribir. La empresa producía el LGP-30, un pequeño y barato (para los estándares de la época) ordenador con memoria de tambor, y empezaba a producir el RPC-4000, un ordenador con memoria de tambor mejorado, más grande y más rápido. Estos ordenadores costaban demasiado, y tampoco duraron mucho de todas formas (es por esto que no habéis oído hablar de la compañía ni del ordenador)
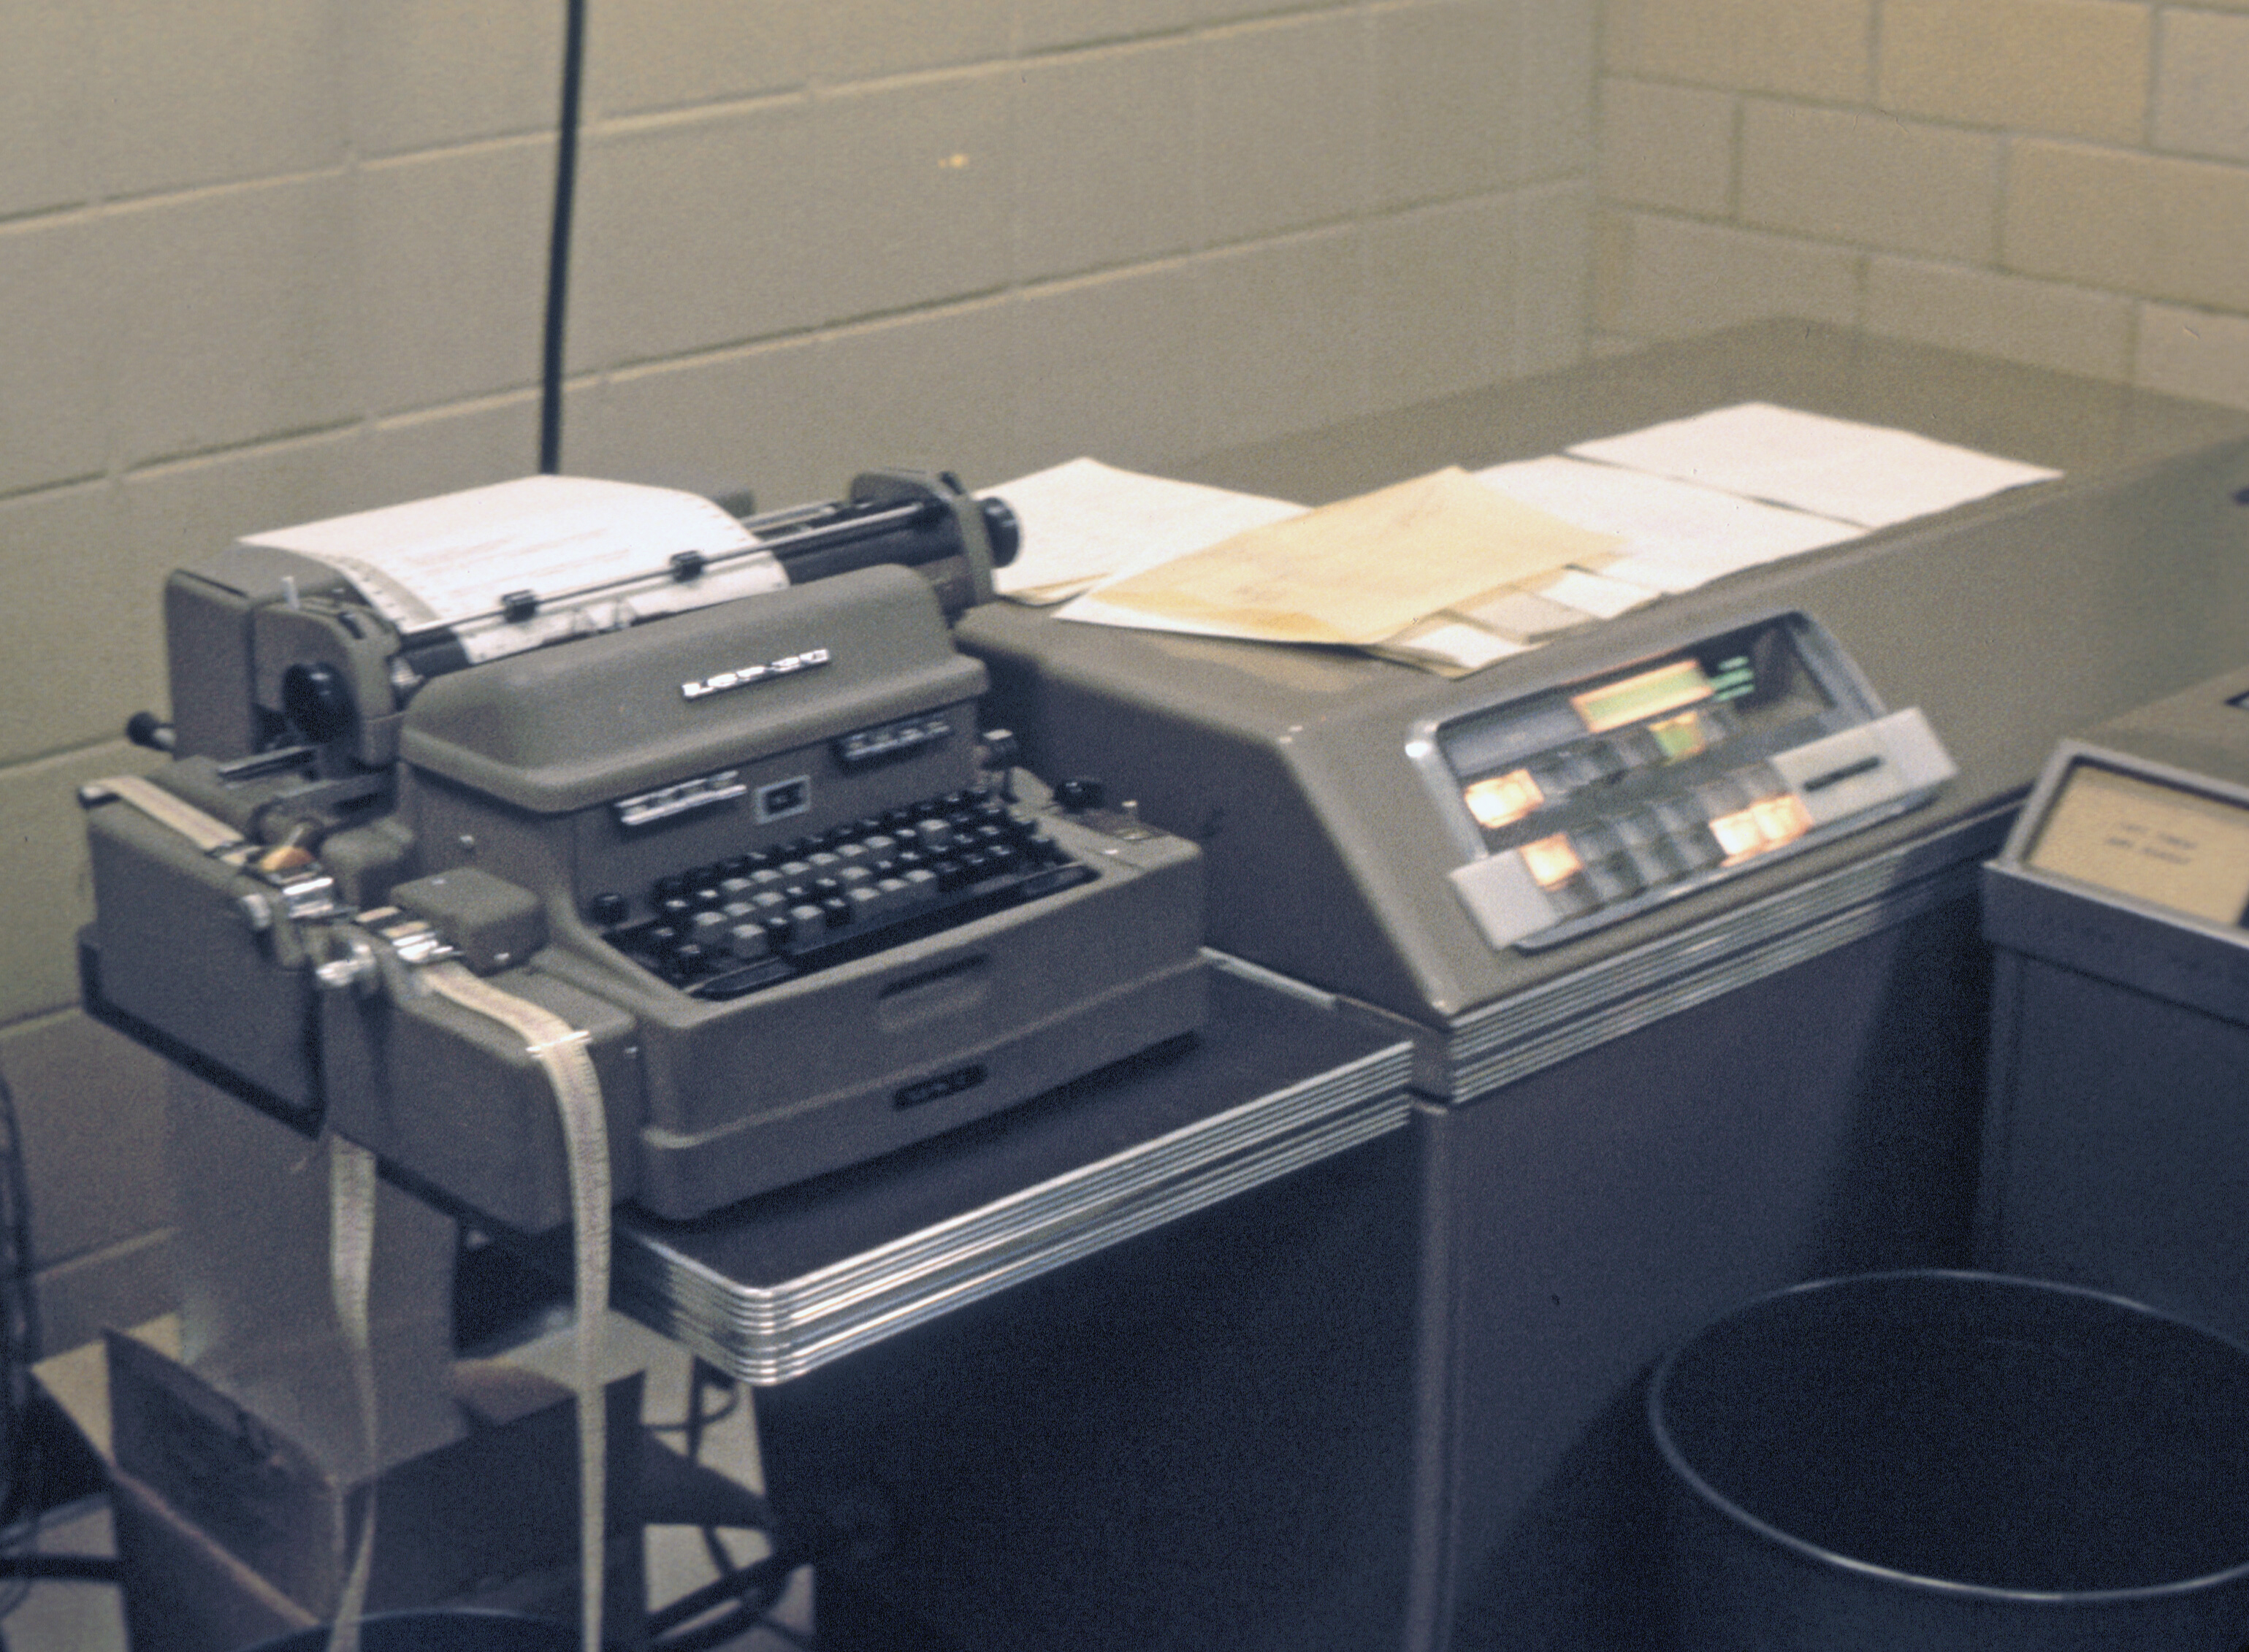

 Había sido contratado para escribir un compilador de FORTRAN para esta nuevo portento y Mel fue mi guía a sus maravillas. Mel no soportaba a los compiladores.

– ¿Si un programa no puede rescribir su propio código — preguntó — qué tiene de bueno?

Mel había escrito, en hexadecimal, el programa de ordenador más conocido que la compañía poseía. Corría sobre el LGP-30 y jugaba al blackjack con los compradores potenciales en las exposiciones de ordenadores. Su efecto era increíble. El stand del LGP-30 estaba siempre lleno en cada exposición, y los vendedores de IBM estaban allí de pie sin poder hacer otra cosa que hablar entre ellos. Si aquello servía para vender ordenadores o no era una pregunta que nadie se planteó nunca.

El trabajo de Mel era reescribir el programa de blackjack para el RPC-4000 (¿Portable? ¿Qué significa eso?). El nuevo ordenador tenia un sistema de direccionamiento de uno más uno, en donde cada instrucción máquina, aparte del código de operación y de la dirección del operando utilizado, tenía una segunda dirección que indicaba donde estaba la próxima instrucción en el tambor giratorio.
¡Una forma moderna de contarlo sería que cada instrucción estaba seguida de un GOTO! Pon eso en la pipa de Pascal y fúmatelo.

Mel amaba al RPC-4000 porque podría optimizar su código: es decir, localizar las instrucciones en el tambor de modo que cuando una hubiera terminado su trabajo, la próxima estuviera pasando por debajo de la cabeza lectora y, por lo tanto, estuviera disponible para su inmediata ejecución. Había un programa que se usaba para hacer eso, un "optimizador de código de ensamblador", pero Mel se oponía a usarlo.

– Nunca sabes donde va a poner las cosas — explicaba — por lo que deberías utilizar constantes separadas.

Tardé un buen tiempo antes de poder entender esa extraña frase. Como Mel conocía el valor numérico de cada código de operación, y había asignado sus propias direcciones en el tambor, cada instrucción que escribía podía también ser considerada como una constante numérica. Podía tomar una instrucción "add" anterior, por ejemplo, y multiplicar algo con ella, si tenía el valor numérico que necesitaba. Su código no era muy sencillo de modificar por otra persona que digamos.

Comparé los programas optimizados a mano de Mel con el mismo código pasado por el programa de optimización de código de ensamblador, y los de Mel siempre se ejecutaban más rápido. Esto era debido a que el sistema de programación "top-down" no había sido inventado aún, y Mel no lo habría utilizado de todas formas. Escribía las partes más internas de los bucles de su programa primero, para que se pudieran situar en las direcciones optimas del tambor. El optimizador de código ensamblador simplemente no era lo suficientemente listo para hacerlo de ese modo.

Mel nunca escribía bucles de espera, a pesar de que la Flexowriter requería un tiempo de espera entre los caracteres de salida para funcionar correctamente. Simplemente situaba las instrucciones en el tambor de forma que cada una ya hubiera pasado por debajo de cabeza cuando se necesitaba; de forma que el tambor debía realizar otra revolución completa para encontrar la instrucción que acababa de pasar. Acuñó un término inolvidable para este proceso. A pesar de que "óptimo" es un término absoluto, como "único", se convirtió en una costumbre hacerlo relativo: "no del todo óptimo" o "menos óptimo" o "o no muy óptimo". Mel llamaba a las localizaciones con mayor tiempo de espera las "más pésimas".

Después de terminar el programa de blackjack y conseguirlo ejecutar ("Incluso el inicializador está optimizado" dijo orgullosamente), recibió una Petición de Modificación desde el departamento de ventas. El programa utilizaba un elegante (y optimizado) generador de números aleatorios para barajar las "cartas" y repartirlas desde el "montón", y algunos de los vendedores creían que esto era demasiado justo, porque a veces los compradores perdían. Querían que Mel modificara el programa para que, cuando se cambiara un interruptor en el panel, pudieran cambiar la suerte y dejar al comprador ganar.

Mel protestó. Creía que la proposición era sencillamente deshonesta, que lo era, y que chocaba con su integridad personal como programador, lo que pasaba de veras, por lo que se negó a hacerlo. El Director de Ventas habló con Mel, igual que lo hizo el Gran Jefe, y, a petición del jefe, unos cuantos Compañeros Programadores. Mel finalmente se rindió y escribió el código, pero hizo la comprobación al revés, y, cuando el interruptor se pulsaba, el programa hacia trampas, ganando todo el rato. Mel estaba encantado con ello, proclamando que su subconsciente era incontrolablemente ético, y se negó estoicamente a arreglarlo

Después de que Mel dejara la compañía en busca de pa$to$ más verdes, el Gran Jefe me preguntó si podía mirar el código y ver si podía encontrar la comprobación y darle la vuelta. Un poco reticente acepté mirar. Seguir el código de Mel era una verdadera odisea.

A veces creo que programar es un arte, y su valor solo puede ser apreciado por otra persona versada en ese arcano arte; existen gemas maravillosas y brillantes ocultas a la vista y admiración humanas, algunas veces para siempre, por la naturaleza misma del proceso. Puedes aprender un montón sobre alguien sólo leyendo su código, incluso en hexadecimal. Mel era, creo, un genio incomprendido.

Quizá mi mayor conmoción fue cuando encontré un inocente bucle que no contenía ninguna condición. Nada. El sentido común me decía que tenía que ser un bucle cerrado, donde el programa se ejecutaría para siempre, sin fin. Sin embargo el control del programa pasaba a través de él hasta el otro extremo sin problemas. Me llevó dos semanas descubrir lo que sucedía.

El RPC-4000 tenía un dispositivo realmente moderno llamado registro índice. Permitía al programador escribir un bucle que utilizara una instrucción indexada en su interior; cada vez que se pasaba por ese punto el valor en el registro índice era añadido a la dirección del operando de aquella instrucción, por lo que se referiría al próximo dato de una serie. Sólo tenía que incrementar el registro índice cada vez. Mel nunca lo utilizó

En su lugar, él ponía la instrucción en un registro de la máquina, añadia uno a su dirección y la almacenaba de nuevo. Entonces ejecutaba la instrucción modificada, directamente desde el registro. El bucle estaba escrito de forma que este tiempo adicional de ejecución se tenía en cuenta, cuando la instrucción en curso terminaba la próxima estaba justo bajo la cabeza de lectura del tambor, lista para ser ejecutada. Pero el bucle no tenía comprobación.

La pista vital llegó cuando me di cuenta que el bit del registro índice, el bit que estaba entre la dirección y el código de operación en la palabra de la instrucción estaba activo… a pesar de que Mel nunca utilizaba el registro índice, dejándolo a cero todo el tiempo. Cuando la luz brilló, casi me cegó.

Mel había situado los datos en los que trabajaba cerca de la parte alta de la memoria, las direcciones más grandes que las instrucciones podían direccionar por lo que, después de que el último dato hubiera sido utilizado, incrementar la dirección de la instrucción haría que se desbordara. El acarreo añadiría uno al código de operación, cambiándolo a la siguiente instrucción en el juego: una instrucción de salto. Además la próxima instrucción de programa estaba en la dirección cero, y el programa seguiría felizmente su recorrido

No me he mantenido en contacto con Mel, por lo que no se si se rindió a los cambios que los tiempos han introducido en las técnicas de programación desde esos días desaparecidos hace mucho tiempo. Me gusta pensar que no lo hizo. De todas maneras me impresionó tanto aquello que dejé de buscar la comprobación, diciéndole al Gran Jefe que no podía encontrarla. No pareció sorprendido.

Cuando dejé la compañía el programa de blackjack seguía haciendo trampas si activabas el interruptor, y creo que es como debe ser. No me siento a gusto hackeado el código de un Verdadero Programador
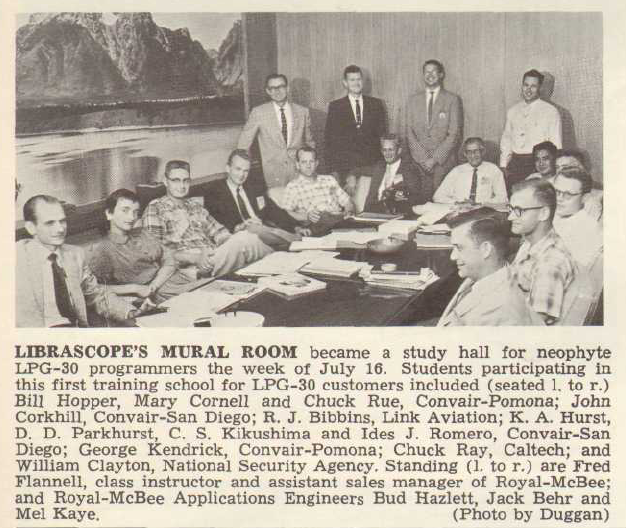
Mel está de pie a la derecha

miércoles, 27 de abril de 2011

Modelos de memoria compartida

Orden de programa

Un programa se compone de instrucciones.

1 x=A //Lee el valor de A
2 B=2 //Escribe un valor en B
3 y=B //Lee el valor de B

Usaré las letras mayúsculas (A,B,C) para las localizaciones de memoria y las minúsculas (a,b,c) para registros o valores que no estén en memoria. Como nos interesa el modelo de memoria, ignoraremos las operaciones que no trabajen con memoria. Para mayor facilidad usaremos números para cada instrucción.

Cuando se ejecuta un programa las instrucciones que se van ejecutando conforman una secuencia que se denomina traza. Se llama orden de programa a la relación de orden estricto que encadena las instrucciones según se ejecutan en una traza. Si escribimos esta relación como [$ \rightarrow_p $] entonces, el programa de arriba tiene la siguiente traza

[$$ 1 \rightarrow_p 2 \rightarrow_p 3 $$]

Nada extraño. Esta relación es un orden estricto y, en principio, total.


Modelo secuencialmente consistente (SC)

Cuando tenemos varios procesadores, cada uno de ellos ejecutando una hebra distinta, ¿cómo se reparten las instrucciones? ¿Y qué instrucciones se ejecutan antes que otras? Un modelo de memoria compartida responde a estas preguntas.

El modelo más simple es el secuencialmente consistente (SC) de Lamport. En este modelo las instrucciones de todos los procesadores se intercalan y el orden resultante de las mismas ha de ser un orden total que llamaremos de ocurrencia [$ \rightarrow_o $].

Si no pusiéramos más condiciones, este orden podría ser cualquiera, incluso sin respetar el orden de programa.

Por ejemplo, este programa con dos hebras

INICIALMENTE: A=B=0
HEBRA 1   HEBRA 2
1 x=A     11 y=B
2 B=1     12 A=1


Tiene el siguiente orden de programa

[$$ 1 \rightarrow_p 2 $$]
[$$ 11 \rightarrow_p 12 $$]

Sin condiciones adicionales, el orden de ocurrencia podría ser, por ejemplo

[$$ 2 \rightarrow_o 12 \rightarrow_o 1 \rightarrow_o 11 $$]

Nota: Tanto el orden [$ \rightarrow_p $] como el orden [$ \rightarrow_o $] son transitivos por lo que con el ejemplo de arriba también tendríamos [$ 2 \rightarrow_o 1, 2 \rightarrow_o 11, 12 \rightarrow_o 11 $]. Es usual no listar estas relaciones que se pueden derivar fácilmente de la primera.

Este orden daría como resultado x=y=1 lo cual es bastante contraintuitivo. El modelo SC tiene la siguiente restricción: si [$N$] y [$M$] son dos instrucciones y [$ N \rightarrow_p M $] entonces debe darse que [$ N \rightarrow_o M $]. Esta condición se expresa de la siguiente manera.

[$$ \frac{N \rightarrow_p M}{N \rightarrow_o M} $$]

Esto quiere decir que si en una hebra se ejecuta una instrucción antes que otra por el orden de programa (por ejemplo, la 11 antes de la 12) entonces ese mismo orden aparece en el orden de ocurrencia. Como en el ejemplo anterior teníamos que 12 ocurría antes que 11, excluimos este posible orden del modelo SC.

[$ 2 \rightarrow_o 12 \rightarrow_o 1 \rightarrow_o 11$] no es SC porque [$2 \rightarrow_o 1$] pero [$1 \rightarrow_p 2$]
[$ 11 \rightarrow_o 1 \rightarrow_o 2 \rightarrow_o 12 $] sí es SC y el resultado es un intuitivo x=y=0
[$ 1 \rightarrow_o 2 \rightarrow_o 11 \rightarrow_o 12 $] sí es SC y el resultado es otro intuitivo x=0, y=1

El dibujo típico del modelo secuencialmente consistente es una memoria compartida asignada únicamente a un procesador en cada momento.


Optimizaciones en compiladores y procesadores

Desafortunadamente las cosas no son tan sencillas. Generalmente el orden de programa es excesivamente restrictivo para realizar optimizaciones. Una optimización típica es la siguiente.

1 A=5
2 x=A
3 B=1

En el anterior programa, la instrucción 2 ha de esperar a que la instrucción 1 escriba el valor 5 en A. Un compilador o un procesador astuto reordena el programa de la siguiente forma.

11 A=5
12 B=1
13 x=A

En este programa transformado, la instrucción 12 se ejecuta mientras la instrucción 11 se está terminando. Esto evita que tengamos que esperar en la instrucción 13 tanto como hacíamos en la instrucción 2.

El problema es que el programador ha escrito las instrucciones 1,2,3 y no las 11,12,13. ¿Qué pasa si ejecutamos esto con otra hebra?

HEBRA 1   HEBRA 2
1 A=5     21 if(B=1)
2 x=A     22   A=7
3 B=1

Pensando en SC de ninguna manera podría ocurrir que x=7 ya que para cuando B=1, x ya tiene el valor 5 y por mucho que modifiquemos A=7, x ya no va a cambiar. Esto no es así si el procesador o el compilador reordena el programa de la hebra 1 sin que lo sepamos.

HEBRA 1   HEBRA 2
11 A=5    21 if(B=1)
12 B=1    22   A=7
13 x=A

Aunque el programador ha escrito 1,2,3, el compilador o el procesador lo reordena a 11,12,13 para optimizar la espera de la instrucción 2 tras la 1. Ahora bien, ¡esto ahora permite que x=7! El orden de ocurrencia para este bug sería

[$$ 11 \rightarrow_o 12 \rightarrow_o 21 \rightarrow_o 22 \rightarrow_o 13 $$]

Si el pobre programador intenta razonar sobre el orden del programa original 1,2,3 lo que vería sería

[$$ 1 \rightarrow_o 3 \rightarrow_o 21 \rightarrow_o 22 \rightarrow_o 2 $$]

que no es SC porque la instrucción 3 se ejecuta antes que la 2.

Relajando el modelo SC

Por esta razón el modelo SC no es útil: no permite al compilador o al procesador optimizar los programas sin dejar al programador con un difícil bug a resolver. La solución es exponer al programador un modelo más débil que se denomina un modelo relajado.

¿Cómo vamos a relajar ese modelo? Hay varias formas.

La primera es permitir reordenar las instrucciones de un programa y proporcionar al programador herramientas para decirle al compilador y al procesador cuándo no se pueden reordenar. Una de estas herramientas es una instrucción llamada barrera de memoria (memory fence) y lo único que significa es que es una barrera que las instrucciones no se la pueden saltar al ser reordenadas.

Con una barrera, el programa anterior quedaría así

HEBRA 1   HEBRA 2
1 A=5     21 if(B=1)
2 x=A     22 A=7
3 FENCE
4 B=1


Y ni el compilador ni el procesador podrían reordenar la instrucción 4 sobre la 3 o la 1 o la 2 bajo la 3. De esta manera, el programador se asegura de que leemos A antes de modificar B. Por otra parte, el compilador o el procesador son libres de realizar otras optimizaciones en otros sitios.

¿Pero en qué sitios? ¿Podría reordenar la instrucción 2 sobre la 1? Realmente no, porque necesitamos conocer A en la instrucción 2 y eso depende de la instrucción 1. A esta relación se la llama una dependencia y la escribiremos [$\rightarrow_d$]. Básicamente indica que un valor no se puede usar antes de que haya sido calculado. En un modelo de memoria relajado al menos se debe conservar la dependencia. Es decir,

[$$\frac{N \rightarrow_d M}{N \rightarrow_o M}$$]

Además, las barreras de memorias ordenan lo que ocurre antes y después de ellas.

[$$\frac{N \rightarrow_p M,  N\ es\ FENCE}{N \rightarrow_o M},\ \ \frac{N \rightarrow_p M,  M\ es\ FENCE}{N \rightarrow_o M}$$]

Entonces, en el programa anterior teníamos.

[$$1\rightarrow_p 2\rightarrow_p 3\rightarrow_p 4,11\rightarrow_p 12$$]
[$$1\rightarrow_d 2,11\rightarrow_d 12$$]
[$$3\ es\ FENCE$$]

Por la dependencia debe cumplirse que

[$$1\rightarrow_o 2,11\rightarrow_o 12$$]

y por barrera debe cumplirse que

[$$1\rightarrow_o 3,2\rightarrow_o 3,3\rightarrow_o 4$$]

Entonces, está claro que

[$1\rightarrow_o 11\rightarrow_o 2\rightarrow_o 12\rightarrow_o 3\rightarrow_o 4$] sí cumple con el modelo relajado
[$1\rightarrow_o 11\rightarrow_o 2\rightarrow_o 12\rightarrow_o 4\rightarrow_o 3$] no cumple con el modelo relajado porque [$4\rightarrow_o 3$]

Nota: La instrucción 12 no se ejecuta, pero de ejecutarse lo haría en la posición arriba puesta.
Nota: Sabemos que si [$4\rightarrow_o 3$] entonces no se da [$3\rightarrow_o 4$] porque estamos tratando con órdenes.


Otras barreras, otros modelos, otras instrucciones

Algunos compiladores y procesadores se restringen a reordenar instrucciones que son de cierto tipo. Los más usuales son
  • Reordena una escritura seguida de otra escritura (WW)
  • Reordena una lectura seguida de una escritura (RW)
  • Reordena una escritura seguida de una lectura (WR)
  • Reordena una lectura seguida de otra lectura (RR) 
Eso permite además tener barreras de memoria selectivas que
  • Impida reordenar escrituras anteriores a la barrera con escrituras posteriores (WW)
  • Impida reordenar lecturas anteriores a la barrera con escrituras posteriores (RW)
  • Impida reordenar escrituras anteriores a la barrera con lecturas posteriores (WR)
  • Impida reordenar lecturas anteriores a la barrera con lecturas posteriores (RR) 
Esto lleva permitirle al compilador y al procesador más optimizaciones. Existen más métodos de restringir la reordenación como instrucciones atómicas, sincronizaciones, bloqueos, etc. Eso sí, empieza a crearnos un zoológico de modelos de memoria que, sin embargo, se dan en la vida real. Por ejemplo,

Procesador o 
Modelo de memoria  Relaja WR  Relaja WW  Relaja RW  Relaja RR
SC
IBM 360            Sí
TSO                Sí
PC                 Sí
PSO                Sí         Sí
WO                 Sí         Sí         Sí         Sí
RCsc               Sí         Sí         Sí         Sí
RCpc               Sí         Sí         Sí         Sí
Alpha              Sí         Sí         Sí         Sí
RMO                Sí         Sí         Sí         Sí
PowerPC            Sí         Sí         Sí         Sí


Para más información http://citeseerx.ist.psu.edu/viewdoc/summary?doi=10.1.1.106.5742&rank=1

sábado, 23 de abril de 2011

Divisiones y módulos enteros

Supongamos que queremos saber si un número es impar. ¿Bastaría este código?

bool impar(int n)
{
 return (n%2) == 1;
}

Veamos. Introducimos el valor 5, hacemos la división por 2 y obtenemos el resto 1. Efectivamente, es impar. Ahora introduzcamos el valor -3, hacemos la división por 2 y obtenemos ¿qué resto? En mi implementación obtengo -1. Eso es un problema, pero ¿por qué sale -1? ¿No debería salir 1?

El operador de módulo % está muy relacionado con la división entera. La división entera se define de la siguiente manera. Sean cuatro números enteros [$n, d, c$] y [$r$] que llamaremos dividendo, divisor, cociente y resto. Esos cuatro números cumplen la siguiente ecuación.

[$$ n = dc + r $$]

Si, además, imponemos la siguiente inecuación, el cociente y el resto son únicos para cada par de dividendo y divisor.

[$$ 0\le r \lt \left| d \right| $$]

Esto es, básicamente, la llamada división euclídea. Matemáticamente este procedimiento de división es muy interesante y tiene muchas propiedades, pero carece de otras. En concreto, con esta división entera multiplicar divisor y dividendo por menos uno altera el resultado.

[$$ \frac{a}{b} \ne \frac{-a}{-b} $$]

Se puede probar con, por ejemplo, [$ \frac{7}{3} $] el cociente será [$2$] y el resto [$1$] mientras que [$ \frac{-7}{-3} $] tiene cociente [$3$] y resto [$2$]. No puedo obtener cociente [$2$] porque el resto tiene que ser positivo.

Entonces, usemos una división más intuitiva. Por ejemplo, hacemos la división en los reales y luego redondeamos. Ahora bien, hay varios tipos de redondeo. Los más usuales son el redondeo por truncamiento, por defecto, por exceso y al entero más cercano (con varias estrategias de desempate).

Según usemos un tipo de división u otra, obtendremos el resto (es decir, el resultado del operador %) de una forma u otra, pero todas mediante la ecuación anterior para mantener consistencia. Despejamos de ella el resto y esa es nuestra definición del operador %.

[$$ n\%d = r = n - dc = n - d \left[ \frac{n}{d} \right] $$]

La división entre corchetes representa el cociente que cambiará según elijamos uno u otro redondeo. El resumen está en esta tabla.

Redondeo por truncamiento Redondeo por defecto Redondeo por exceso Redondeo al más cercano División euclídea
[$$\frac{3}{5}$$] c=0
r=3
c=0
r=3
c=1
r=-2
c=1
r=-2
c=0
r=3
[$$\frac{-3}{5}$$] c=0
r=-3
c=-1
r=2
c=0
r=-3
c=-1
r=2
c=-1
r=2
[$$\frac{3}{-5}$$] c=0
r=3
c=-1
r=-2
c=0
r=3
c=-1
r=-2
c=0
r=3
[$$\frac{-3}{-5}$$] c=0
r=-3
c=0
r=-3
c=1
r=2
c=1
r=2
c=1
r=2

Hay tres hechos importantes en esta tabla:
  1. En el redondeo por truncamiento el signo del resto coincide con el signo del dividendo.
  2. En el redondeo por defecto el signo del resto coincide con el signo del divisor (y en el redondeo por exceso con su opuesto).
  3. En el redondeo al entero más cercano el resto es el más cercano a cero posible.

Nota: La división que utilizamos cuando usamos el AND binario (&) para calcular rápidamente un módulo [$ a\% 2^n = a \& (2^n -1) $] es o bien la por defecto o la euclídea (tanto el divisor como el resto son positivos en este caso).

Ahora sólo queda ver qué lenguaje de programación usa qué tipo de división y módulo. La siguiente tabla extraída de la Wikipedia lo lista.

Lenguaje Operador El resultado tiene el mismo signo que
ActionScript % Dividendo
Ada mod Divisor
rem Dividendo
ASP Mod No definido
ALGOL-68 %× Euclídea
AMPL mod Dividendo
AppleScript mod Dividendo
BASIC Mod No definido
bc % Dividendo
bash % Dividendo
C (ISO 1990) % Depende de implementación
C (ISO 1999) % Dividendo
C++ % Depende de implementación
C# % Dividendo
CLARION % Dividendo
Clojure mod Divisor
ColdFusion % Dividendo
Common Lisp mod Divisor
rem Dividendo
D % Dividendo
Eiffel \\ Dividendo
Erlang rem Dividendo
Euphoria mod Divisor
remainder Dividendo
FileMaker Mod Divisor
Fortran mod Dividendo
modulo Divisor
GML (Game Maker) mod Dividendo
Go % Dividendo
Haskell mod Divisor
rem Dividendo
J |~ Divisor
Java % Dividendo
JavaScript % Dividendo
Just Basic MOD Dividendo
Lua 5 % Divisor
Lua 4 mod(x,y) Divisor
Liberty Basic MOD Dividendo
MathCad mod(x,y) Divisor
Maple (software) e mod m Divisor
Mathematica Mod Divisor
Microsoft Excel =MOD() Divisor
MATLAB mod Divisor
rem Dividendo
Oberon MOD Divisor
Objective Caml mod Dividendo
Occam \ Dividendo
Pascal (Delphi) mod Dividendo
Pascal (ISO-7185 and ISO-10206) mod Euclídea
Perl % Divisor
PHP % Dividendo
PL/I mod Divisor (ANSI PL/I)
PowerBuilder mod(x,y)  ?
PowerShell % Dividendo
Prolog (ISO 1995) mod Divisor
rem Dividendo
Python % Divisor
RealBasic MOD Dividendo
R %% Divisor
RPG %REM Dividendo
Ruby %, modulus() Divisor
remainder() Dividendo
Scheme modulo Divisor
remainder Dividendo
Scheme R6RS mod Euclídea
mod0 Más cercano a cero
SenseTalk modulo Divisor
rem Dividendo
Smalltalk \\ Divisor
SQL (SQL:1999) mod(x,y) Dividendo
Standard ML mod Divisor
Int.rem Dividendo
Stata mod(x,y) Euclídea
Tcl % Divisor
Torque Game Engine % Dividendo
Turing (programming language) mod Divisor
Verilog (2001) % Dividendo
VHDL mod Divisor
rem Dividendo
Visual Basic Mod Dividendo
x86 Assembly IDIV Dividendo
ADEP_AUTO language MODULO(x,y) Divisor


También existe el mismo problema relacionado con la operación equivalente en los reales (flotantes). Esta es la tabla en este caso.


Lenguaje Operador El resultado tiene el mismo signo que
C (ISO 1990) fmod  ?
C (ISO 1999) fmod Dividendo
remainder Más cercano a cero
C++ std::fmod  ?
C# % Dividendo
D %  ?
Common Lisp mod Divisor
rem Dividendo
Go math.Fmod Dividendo
Haskell (GHC) Data.Fixed.mod' Divisor
Java % Dividendo
JavaScript % Dividendo
Objective Caml mod_float Dividendo
Perl POSIX::fmod Dividendo
PHP fmod Dividendo
Python % Divisor
math.fmod Dividendo
Ruby %, modulus() Divisor
remainder() Dividendo
Scheme R6RS flmod Euclídea
flmod0 Más cercano a cero
Standard ML Real.rem Dividendo


Bueno. Entonces. Al final. ¿Cómo sé si un número es impar o no? Lo mejor es aprovechar que el resto cero es igual en todas las implementaciones y hacer algo así.

bool impar(int n)
{
 return (n%2) != 0;
 }


domingo, 2 de mayo de 2010

Nunca es tarde para una (buena) compilación

Compilación estática y compilación dinámica

La compilación usual es la compilación estática. En la compilación estática analizamos el código fuente y generamos un código ejecutable en la plataforma de destino que queramos. Es lo que se denomina código nativo o código máquina.

Generalmente este tipo de compilación es muy rígida porque necesitamos saberlo todo antes de producir el ejecutable nativo. Una primera solución a este problema es separar el código nativo en bloques distintos que cargamos cuando vayamos a ejecutar. A esto se le denomina biblioteca dinámica.

Pero podemos hacerlo mejor. Podríamos no generar un código nativo, sino separar el compilador en dos partes. La primera genera un código incompleto llamado código intermedio o bytecode y la segunda termina de compilar ese código incompleto al código nativo más tarde. Cuando vayamos a ejecutar.

Esto es la compilación dinámica que fue introducida por David Ungar en el lenguaje Self. Este tipo de traducciones de un código binario a otro código binario se llaman traducciones binarias. Son usuales en los emuladores y máquinas virtuales.

La compilación dinámica más simple es la adelantada en el tiempo (AOT en sus siglas en inglés). En este caso compilamos todo el código intermedio a código nativo en cuanto tenemos que ejecutar el programa. Esto hace que sea lento arrancar el programa pero, una vez funcionando, vaya rápido.

¡Justo a tiempo!

Otra opción es compilar más tarde. ¿Cómo vamos a compilar después de cargar el código? Muy sencillo: compilamos conforme vayamos ejecutando. Empezamos a ejecutar una sección del código (función o incluso un bloque de una función). Si está compilado lo ejecutamos y si no, lo compilamos y ejecutamos. De esta manera el arranque es más rápido que en AOT porque sólo compilamos lo que necesitamos para arrancar y no todo el programa.

Esta compilación es la compilación justo a tiemo (JIT en sus siglas inglesas) y es la más usada con diferencia. De hecho, se puede hasta hacer más rápida aún. La técnica es muy sencilla. Introducimos junto al compilador un intérprete. Cuando nos encontramos un trozo de código sin compilar pasamos el intérprete y recogemos estadísticas de uso de ese trozo de código.

Cuando la estadística nos indica que es un trozo de código muy usado, compilamos. Si no es muy usado lo dejamos sin compilar y lo interpretamos. De esta manera se mejoran incluso los tiempos de arranque ya que suelen ser secciones de código que usan mucho las entradas/salidas a disco y compilar no sirve para acelerarlas. Véase la Ley de Amdhal.

Finalmente podemos hacer que el propio usuario o el propio programa decida cuándo compilar y cuándo no. Incluso, compilar desde código fuente y no desde código intermedio. En este caso hay que meter todo el compilador (y no solo la parte de traducción binaria) en el sistema de ejecución. Esto es lo que se llama la compilación incremental.

Pero no todo acaba aquí: Cuando el programa ya está compilado ¡podemos recompilarlo! Esta técnica es la recompilación dinámica (dynarec o DRC en inglés). La recompilación vuelve a optimizar el código ya que una vez que tenemos el programa entero se dispone de más información que cuando se está compilando.


domingo, 5 de julio de 2009

Máquinas virtuales e instrucciones

Una máquina virtual es un procesador que se emula por software. Si la máquina virtual está pensada para ofrecer todas las prestaciones de un sistema real, se llama máquina virtual de sistema. Si es una abstracción para que algún proceso funcione, se llama máquina virtual de proceso. (Ver la Wiki).

Una máquina virtual puede ser una implementación de una máquina ideal que no exista. Es más, podemos inventarnos la máquina virtual que necesitemos para resolver un problema específico. Inventar las instrucciones de la máquina y definir su comportamiento es una de las partes más emocionantes de la creación de máquinas virtuales propias.

Personalmente he tratado con un tipo de máquinas virtuales que se denominan máquinas de pila. Sin embargo, hoy en día estoy con otro tipo llamadas máquinas de registro. Las primeras me parecen mucho más fáciles, pero he de reconocer que la comparación hecha en la Wikipedia deja claro que las segundas son mucho más rápidas. También hay un tercer tipo por lo que la lista completa sería:

  • Máquinas de pila. Instrucciones sin argumentos del tipo PUSH, POP, ADD, SUB, etc.
  • Máquinas de registro. Instrucciones con argumentos de origen y destino tipo ADD x,y; SUB x,y; etc.  Algunos juegos de instrucciones tienen también tres argumentos como MUL x, y, z;
  • Máquinas de acumulador. Instrucciones con argumento de origen únicamente. El destino es un registro especial que es el acumulador. Serían cosas como ADD x; SUB x; etc.


Esta clasificación también se puede extender a máquinas reales, aunque sea muy difícil encontrar un microprocesador que sea exclusivamente de un tipo. Por ejemplo, la arquitectura i386 tiene instrucciones de pila (como FSUB), instrucciones de acumulador (como STOS) e instrucciones de registro de dos (como ADD) y de tres (como IMUL) argumentos.