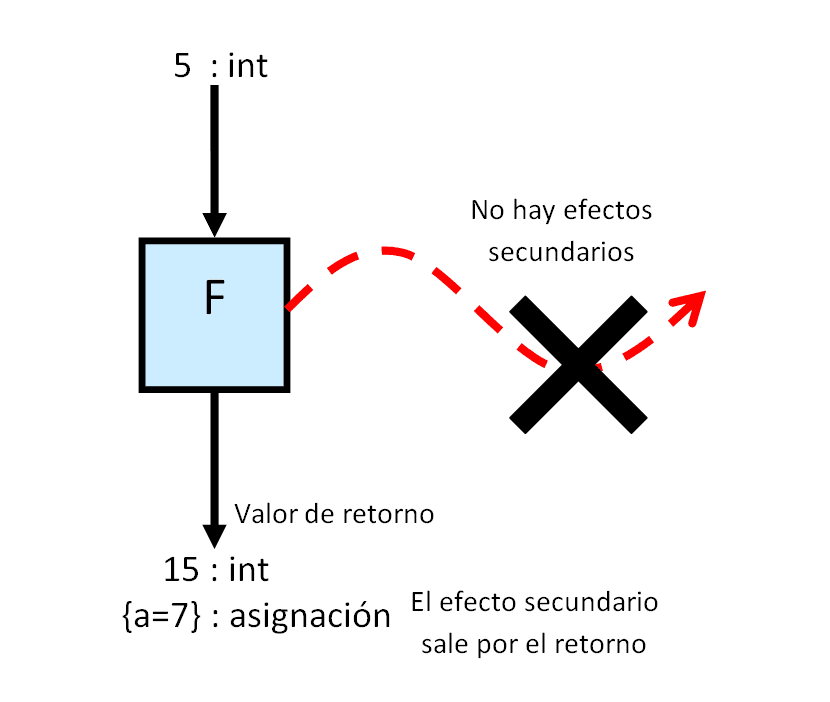
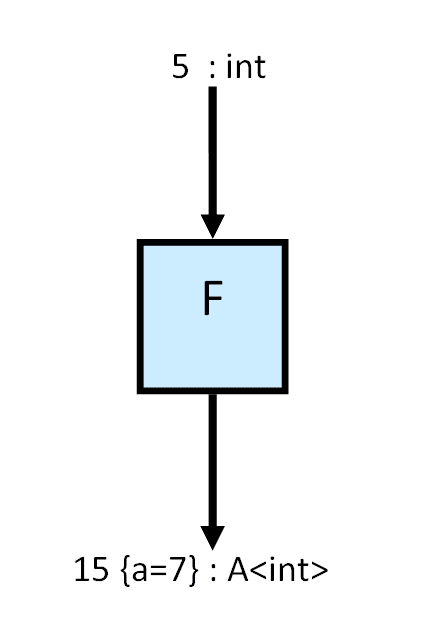
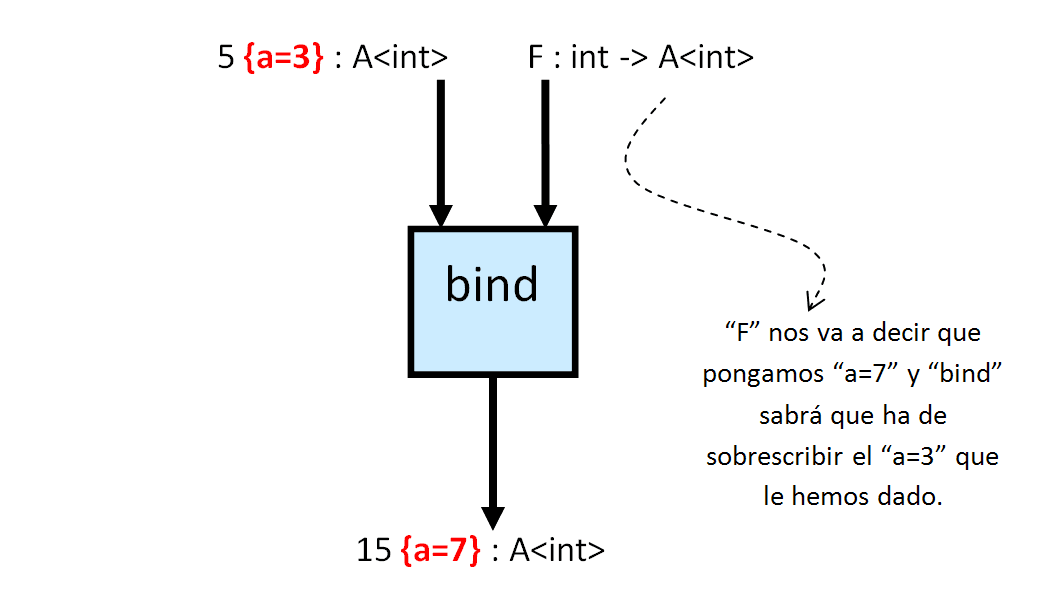
Mostrando entradas con la etiqueta semántica formal. Mostrar todas las entradas

domingo, 19 de mayo de 2013

Álgebras y coálgebras

He encontrado varias veces por Internet la pregunta de qué es un coálgebra y las respuestas han sido más o menos liosas. El motivo es que en computación al hablar de (co)álgebras nos referimos a las F-(co)álgebras. Lo que implica explicar qué es la F y esa F es un funtor. Un funtor es una operación en categorías y hay que introducir parte de la teoría de categorías para explicarlo.

Puede hacerse más simple.

El producto cartesiano generalizado

Estrictamente hablando el producto cartesiano es una operación entre dos conjuntos.[$$A\times B$$]El resultado es otro conjunto y sus elementos son los pares ordenados de forma que el primer elemento se obtenga del primer conjunto y el segundo elemento del segundo. En notación matemática:[$$A\times B = \{ (a,b) \mid a\in A, b\in B \}$$] Cuando hacemos dos productos cartesianos, surge la duda de si es asociativo o no.[$$A\times (B \times C) \overset{?}{=} (A\times B)\times C$$] En general el producto cartesiano no es asociativo, ya que [$(a,(b,c))\ne((a,b),c)$], pero nada impide usar un producto cartesiano generalizado (que escribiré entre paréntesis) en el cual el producto de tres conjuntos no sean pares, sino triplas. [$$(A\times B \times C) = \{ (a,b,c) \mid a\in A, b\in B, c\in C \}$$] El de cuatro conjuntos serían cuadruplas y el de [$n$] conjuntos lo que llamaremos [$n$]-tuplas. [$$(A_1\times\cdots\times A_n) = \{(a_1,\dots,a_n) \mid a_1\in A_1,\dots,a_n\in A_n \}$$] Usaremos este producto cartesiano generalizado.

Antes de acabar este apartado sólo resta destacar un caso particular. El del producto cartesiano de cero conjuntos. Llamaremos a este conjunto [$1$] y sólo contiene un elemento que es la tupla vacía [$()$].

Esta definición no debe ser extraña si seguimos la siguiente secuencia. [$$(A\times B \times C) = \{ (a,b,c) \mid a\in A, b\in B, c\in C \}$$][$$(A\times B) = \{ (a,b) \mid a\in A, b\in B \}$$][$$(A) = \{ (a) \mid a\in A \}$$][$$1 = \{ () \}$$]

Algebras

La idea de usar álgebras proviene de tomar un tipo de datos como sus valores y las operaciones que los construyen por inducción. Por ejemplo, en el caso de una lista, estos constructores serían.
  • La lista vacía. Lo que se ha venido a llamar la constante nil.
  • Añadir un elemento a la lista. Función que se llama cons.
Las constantes se expresan como funciones que no toman argumentos (mejor dicho, toman la tupla vacía), por lo que si la lista es de enteros y llamo al tipo de esta lista [int], el tipo de cada una de estas funciones sería: [$$nil : 1 \to [int]$$]Que no toma argumentos y devuelve la lista de enteros vacía y[$$cons : (int \times [int]) \to [int]$$]Que toma un entero y una lista de enteros y devuelve otra con este elemento añadido.

Teniendo en mente estas funciones, decimos que el tipo lista de enteros [int] no es más que el conjunto de sus valores (que llamaré [$A_{[int]}$]) y las dos funciones que los construyen por inducción. [$$(A_{[int]}, nil : 1\to[int] , cons : (int \times [int]) \to [int] )$$]Muy similar a, por ejemplo, un monoide [$$(M,e:1 \to M ,\otimes:(M\times M)\to M )$$] donde [$M$] son los elementos del monoide, [$e$] el elemento neutro y [$\otimes$] la operación interna. O a la definición de los números naturales[$$(N,cero:1\to N, suc:N \to N)$$] donde [$cero$] es la constante cero y [$suc$] la operación que obtiene el siguiente número natural (el sucesor).

Generalizando de nuevo, vemos que todas estas definiciones tienen siempre la misma estructura.[$$(A, f_1: X_1 \to A,\dots, f_n: X_n \to A)$$]Donde los [$X_i$] son productos cartesianos de conjuntos en los cuales puede estar el propio [$A$] o no.

Bien. Eso es un álgebra. Un conjunto y varias operaciones cuyo codominio es tal conjunto.

Coálgebras

En un coálgebra lo que tenemos es [$$(A, f_1: A\to X_1,\dots, f_n: A\to X_n)$$] En este caso las operaciones tienen el conjunto en su dominio.

¿Qué significado tiene esto?

Pensemos en una lista. La operación cons tomaba una lista y un elemento e introducía ese elemento en la lista.

cons(7,[1,2,3])=[7,1,2,3]
cons(9,[8,1,3])=[9,8,1,3]
cons(4,[])=[4]

El tipo de cons era [$(int\times [int])\to [int]$]. En una coálgebra la operación correspondiente (que llamaremos headtail) deberá tener el tipo [$[int]\to(int\times [int])$] lo que significa que de una lista obtenemos un elemento y otra lista. Una forma de ver esto es pensar que, en la coálgebra, la operación headtail extrae un elemento de la lista. En general, las operaciones de una coálgebra deshacen lo que los constructores hacían en las álgebras. Por esta razón a las operaciones de una coálgebra se las denomina destructores.

headtail([1,2,3])=(1,[2,3])
headtail ([8,1,3])=(8,[1,3])
headtail ([])=????

¿Qué pasó en este último ejemplo? ¿Es realmente headtail una función sobre las listas o sólo sobre las listas no vacías?

Existen dos respuestas aquí.

La primera respuesta es introducir los tipos suma. De esa manera, headtail podría devolver un error sumando el conjunto unidad al tipo de su codominio ([$headtail: [int]\to 1+(int\times [int])$]). Esto es dual a la agrupación de todas las operaciones del álgebra de la lista en una única operación sumando sus dominios ([$nilcons: 1+(int\times [int])\to [int]$]) y por esta vía definimos el funtor polinómico [$F X = 1+(X\times [X])$] y llegamos a las F-(co)álgebras que es de lo que realmente estamos hablando.

Aún introduciendo la posibilidad de que headtail acabe de leer una lista, no significa que lo haga. Usar coinducción permite trabajar con listas infinitas en las cuales siempre podemos ir extrayendo elementos. Esto nos lleva a...

La segunda respuesta es modificar nuestro tipo de datos y decir que no trabajamos con listas, sino con listas infinitas (los llamados streams). Como la lista es infinita, nunca va a estar vacía y siempre podremos usar headtail. Estos tipos de datos infinitos definidos por coálgebras y coinducción se denominan codatos. Son útiles para modelar, por ejemplo, la entrada del usuario que, en principio, nunca acaba.

jueves, 10 de noviembre de 2011

Semántica natural de LISP - parte 2 - LISP imperativo

En la primera parte de esta serie homenaje a John McCarthy vimos una semántica de LISP sin permitir la modificación ni de los valores ni de las vinculaciones. Era un LISP funcional. En esta parte vamos a introducir esa posibilidad. Es por tanto un LISP imperativo.

La memoria y los contextos

En el momento que introducimos cambios, hemos de manejar estados. El estado con el que trabajaremos será la memoria [$M$]. Esta memoria será el conjunto libremente generado por [$$M::= \emptyset \mid M,m\Leftarrow c$$] Los identificadores [$m$] son las direcciones de memoria y los objetos sintácticos [$c$] son las celdas con el contenido de esa dirección. Veremos la sintaxis de las celdas más abajo.

Usaremos también los identificadores [$E$] como sinónimos a [$m$]. No son una nueva categoría, son la misma categoría sintáctica. Simplemente, vamos a usar [$E$] cuando hablemos de posiciones de memoria que guardan entornos. Esto nos hará mucho más legibles las ecuaciones y reglas a continuación.

Si bien recuerda el lector de la primera parte, esta definición de [$M$] es muy similar a la definición de contexto [$C$] que teníamos. Esta vez, nuestro contexto no podrá tener valores porque todo hemos de guardarlo en la memoria para que pueda ser modificado. Así pues, nuestro contexto ahora será [$$C::=\emptyset \mid C,x\leftarrow m$$] Donde [$x$] son los identificadores de variable.

Operaciones sobre memoria y contextos

Debido a la similitud entre la sintaxis de memoria y contexto, vamos a dar sus operaciones a la vez. La primera operación es el dominio que nos indica qué posiciones de memoria o qué identificadores de variable están en uso.

En primer lugar, la memoria vacía o el contexto vacío tienen un dominio vacío.
[$$dom(\emptyset)=\emptyset$$][$$dom(\emptyset)=\emptyset$$]
Para continuar, el dominio de la memoria o el contexto más una asignación de memoria o vinculación de variable se calcula recursivamente.
[$$dom(M,m\Leftarrow c)=dom(M)\cup\{m\}$$][$$dom(C,x\leftarrow m)=dom(C)\cup\{x\}$$]

La siguiente operación que vamos a especificar es la pertenencia a memoria o a contexto. El caso base es cuando la propia asignación o vinculación está en la parte más externa de la memoria o contexto.
[$$(m\Leftarrow c)\in(M,m\Leftarrow c)$$][$$  (x\leftarrow m)\in(M,x\leftarrow m)  $$]
El caso recursivo ocurre cuando no se encuentra en esa posición externa.
[$$\frac{m\ne m'\;\;\;\;\;\;  (m\Leftarrow c)\in M}{(m\Leftarrow c)\in(M,m'\Leftarrow c')}$$][$$\frac{x\ne x'\;\;\;\;\;\;(x\leftarrow c)\in C}{(x\leftarrow m)\in(C,x'\leftarrow m')}$$]

Finalmente, y dado que estamos hablando de mutaciones de memoria, tendremos que introducir las operaciones de cambio de memoria y de contexto. Es similar a la pertenencia, pero con una comprobación extra por si la dirección de memoria o variable que queremos modificar no está usada y, por tanto, hay que añadirla. Empecemos por esta regla extra.
[$$\frac{m\notin dom(M)}{M\langle m\Leftarrow c\rangle=M,m\Leftarrow c}$$][$$  \frac{x\notin dom(C)}{C\langle x\leftarrow m\rangle=C,x\leftarrow m}$$]
 Cuando lo que queremos cambiar sí está en el dominio, hemos de buscarlo y cambiarlo.
[$$(M,m\Leftarrow c)  \langle m\Leftarrow c'\rangle= (M,m\Leftarrow c') $$][$$  (M,x\leftarrow m)   \langle x\leftarrow m'\rangle =   (M,x\leftarrow m')    $$]
[$$\frac{m\ne m'\;\;\;\;\;\;  m' \in dom(M)}{  (M,m\Leftarrow c)\langle m'\Leftarrow c' \rangle =   (M \langle m'\Leftarrow c' \rangle ,m\Leftarrow c)  }$$][$$\frac{x\ne x'\;\;\;\;\;\; x'\in dom(C)}{(C,x\leftarrow m)\langle x'\leftarrow m'\rangle =   (C \langle x'\leftarrow m'\rangle ,x\leftarrow m)   }$$]


Celdas y entornos

Las celdas van a contener los valores del LISP funcional. Además, dado que las vinculaciones de variables van a poder ser modificadas, también vamos a introducir en ellas a los contextos. Su sintaxis es la que sigue [$$c::= l \mid x \mid (m.m) \mid \lambda^Emm \mid |p| \mid C $$] Es decir, que una celda podrá ser o bien un literal [$l$], o bien una variable [$x$], o bien un par [$(m.m)$], o bien una clausura [$\lambda^Emm$], o bien un valor predefinido [$|p|$], o bien un contexto [$C$]. Recordemos que la [$E$] no es más que una dirección de memoria como las [$m$].

Dentro de los literales incluimos la lista vacía que escribiremos [$()$]. Una lista de contextos es un entorno. La operación más importante en los entornos es la búsqueda de la vinculación de una variable. Lo haremos buscando en el contexto en posición de cabeza de la lista y luego, si no se encuentra, usando la recursión en el resto de la lista. Bastan dos reglas para realizar este procedimiento. 
[$$\frac{E\Leftarrow(m'.E')\in M\;\;\;\;\;\;m'\Leftarrow C\in M\;\;\;\;\;\;x\leftarrow m\in C}{x\leftarrow m\in_M E}$$]
[$$\frac{  E\Leftarrow(m'.E')\in M\;\;\;\;\;\;m'\Leftarrow C\in M\;\;\;\;\;\;x\leftarrow m\notin C \;\;\;\;\;\;  x \leftarrow m \in_M E' }{ x\leftarrow m\in_M E }$$]
Las dos reglas de arriba son muy similares. Primero, en ambas reglas, se comprueba que la dirección de memoria [$E$] sea un par y que su primer campo [$m'$] apunte a un contexto [$C$]. Luego, si encontramos la variable en [$C$], ahí está (primera regla) y, si no la encontramos, buscamos en el resto de la lista [$E'$] que es el llamado entorno padre (segunda regla).

Otra operación muy simple, y que más que nada es una abreviatura, es la introducción de un nuevo contexto en un entorno.[$$\frac{m' \notin dom(M)\cup\{m\}}{M\triangleright E\Leftarrow C\mid E' \triangleright M,m'\Leftarrow C, E\Leftarrow (m',E')}$$] Para empezar, usaremos [$M\triangleright$] a la izquierda y [$\triangleright M'$] a la derecha de un juicio cuando quiera indicar que la memoria [$M$] se cambia y como resultado obtenemos la memoria [$M'$]. En este caso, leemos el consecuente como "dada la memoria [$M$], obtengo el entorno [$E$] al introducir un nuevo contexto [$C$] en el entorno padre [$E'$] y la memoria con estos cambios es todo lo que hay a la derecha del [$\triangleright$]".

Relaciones auxiliares de evaluación

En la primera parte introdujimos un par de relaciones auxiliares de evaluación: la desestructuración o ajuste de patrones y el envoltorio. Hemos de adaptar ambas a la introducción de la memoria. Ahora hemos de explorar la memoria en vez de explorar valores. Todo esto hace las reglas un poco más largas, pero en el fondo son exactamente las mismas.

El ajuste de patrones sigue teniendo tres reglas: para literales (la llamaremos P-LIT), para variables (P-VAR) y para pares (P-PAIR).
   
[$$\frac{m\Leftarrow l\in M\;\;\;\;\;\;m'\Leftarrow l\in M}{C\{m\mid m'\}_M=C}$$]
[$$\frac{m\Leftarrow x\in M\;\;\;\;\;\; x\notin dom(C)}{C\{m\mid m'\}_M=(C,x\leftarrow m')}$$]
[$$\frac{m\Leftarrow (m_1.m_2)\in M\;\;\;\;\;\;m'\Leftarrow (m'_1.m'_2)\in M}{C\{m\mid m'\}_M=  C\{m_1\mid m'_1\}_M   \{m_2\mid m'_2\}_M   }$$]


El envoltorio sigue teniendo sus dos reglas: para la lista vacía (la llamaremos W-EMPTY) y para el par (W-PAIR). Esta vez se complica un poco más porque hemos de acarrear las memorias de una evaluación a la siguiente. De esta forma los cambios en la primera evaluación afectan a la segunda evaluación. 
[$$\frac{m\Leftarrow ()\in M}{M\triangleright E \vdash m \Downarrow m \triangleright M}$$]
[$$\frac{m\Leftarrow (m_1.m_2)\in M\;\;\;\;\;\; M\triangleright E \vdash m_1 \downarrow m_1' \triangleright M_1 \;\;\;\;\;\;    M_1\triangleright E \vdash m_2 \Downarrow m_2' \triangleright M_2 \;\;\;\;\;\;\; m' \notin dom(M_2)  }{  M\triangleright E \vdash m \Downarrow m' \triangleright M_2,m'\Leftarrow(m'_1.m'_2) } $$]
 En definitiva, lo que hace el envoltorio es evaluar los operandos para obtener los argumentos. En el proceso crea una lista de argumentos.


La evaluación

Ya tenemos todo lo necesario para la evaluación. Es exactamente igual que la evaluación en la versión funcional sólo que acarreando memorias de una evaluación a la siguiente y usando entornos en vez de contextos.

 
[$$\frac{m\Leftarrow l\in M}{M\triangleright E\vdash m\downarrow m \triangleright M}$$]
La primera regla, que sigue siendo E-LIT, mira lo que hay en la dirección de memoria [$m$] y, si es un literal [$l$], devuelve la propia dirección de memoria como su resultado. Eso significa que el resultado de evaluar un literal es él mismo.
[$$  \frac{m\Leftarrow x\in M\;\;\;\;\;\; x\leftarrow m'\in_M E}{M\triangleright E \vdash m \downarrow m' \triangleright M}  $$]
Esta segunda regla, E-VAR, mira lo que hay en la dirección de memoria y, si es una variable [$x$], busca su vinculación [$m'$] en el entorno [$E$] y devuelve esa vinculación. En ninguna de estas dos reglas se modifica la memoria.
 
[$$  \frac{\begin{array}{c}m\Leftarrow(m_1.m_2)\in M\;\;\;\;\;\;M\triangleright E\vdash m_1 \downarrow m'_1 \triangleright M_1 \;\;\;\;\;\; m'_1 \Leftarrow |p|\in M_1 \\  M_1 \triangleright E \vdash |p|m_2 \rightarrow_\delta m'_2 \triangleright M' \end{array}}{  M\triangleright E \vdash m \downarrow m' \triangleright M'  }  $$]
La regla E-PRE, que trata con los valores predefinidos, es algo más compleja. Primero, la regla observa que [$m$] apunta a un par [$(m_1.m_2)$] en la memoria. Eso significa que hay una combinación y hemos de evaluarla. Evalúa el operador [$m_1$] y observa que su resultado [$m'_1$] apunta a un valor predefinido [$|p|$]. Además, hemos modificado la memoria al evaluar el operador y hemos de buscar en [$M_1$]. Una vez que sabemos que es un valor predefinido, delegamos toda evaluación a la relación delta [$\rightarrow_\delta$] que se encarga de los valores predefinidos. La especificaremos más adelante.
[$$ \frac{  \begin{array}{c}m\Leftarrow(m_1.m_2)\in M\;\;\;\;\;\;M\triangleright E\vdash m_1 \downarrow m'_1 \triangleright M_1 \;\;\;\;\;\; m'_1 \Leftarrow \lambda^{E_c}m_f m_b\in M_1 \\ M_1 \triangleright E \vdash m_2 \Downarrow m'_2 \triangleright M_2 \;\;\;\;\;\;  M_2 \triangleright E' \Leftarrow \emptyset\{m_f \mid m'_2 \}_{M_2} \mid E_c \triangleright M_3 \;\;\;\;\;\;  M_3 \triangleright E' \vdash m_b \downarrow m' \triangleright M' \end{array}}{ M\triangleright E \vdash m \downarrow m' \triangleright M' } $$]
 La última regla, E-APP, es la más compleja y usa prácticamente todas las relaciones auxiliares vistas hasta ahora. Explicaremos lo que hace paso a paso:
  1. Los tres primeros antecedentes son exactamente iguales que los de la regla E-PRE. Es decir, comprobamos que es un par, evaluamos el primer componente y descubrimos que es, en este caso, una clausura con entorno de clausura en la dirección de memoria [$E_c$] con parámetros formales en la dirección de memoria [$m_f$] y el código a ejecutar en la dirección de memoria [$m_b$].
  2. A continuación, evaluamos los operandos para obtener los argumentos. Esto es justamente lo que hace la relación de envoltorio. Es el primer antecedente de la segunda fila.
  3. Una vez que tenemos los argumentos, usamos ajuste de patrones para generar un contexto en el cual estén vinculadas las variables de los parámetros formales [$m_f$] a los argumentos [$m'_2$]. Esta parte es [$\emptyset\{m_f\mid m'_2\}_{M_2}$].
  4. Luego, ese contexto se introduce en un nuevo entorno [$E'$] usando como entorno padre el [$E_c$] para obtener la memoria [$M_3$]. Es lo que hace [$ M_2 \triangleright E' \Leftarrow \emptyset\{m_f \mid m'_2 \}_{M_2} \mid E_c \triangleright M_3 $]
  5. Entonces, tenemos en la dirección de memoria [$E'$] el entorno donde evaluar el cuerpo de la clausura y obtener el resultado [$m'$] junto con la memoria final [$M'$]. Es lo que hace el último antecedente.
Para ver cómo funciona todo esto, haremos un ejemplo de evaluación.

Ejemplo de evaluación

Aunque va a ser un ejemplo muy simple, la memoria va a estar bastante llena. Para no liarnos voy a usar como identificadores de memoria los valores de la semántica funcional entre corchetes. De esta forma entendemos mejor qué hay en la dirección de memoria [$m_4$] si en vez de escribir [$m_4$] escribo [$[\lambda^{C_0}((x.y))x]$].

Entonces, nuestra memoria [$M_0$] va a ser la siguiente.


[$[C_0]$][$\Leftarrow$][$list\leftarrow [\lambda^{(C_0)}xx], car\leftarrow [\lambda^{(C_0)}((x.y))x] $]
[$ [\lambda^{(C_0)}xx] $][$\Leftarrow$][$ \lambda^{[(C_0)]}[x][x]$]
[$ [x] $][$\Leftarrow$][$x$]
[$ [\lambda^{(C_0)}((x.y))x] $][$\Leftarrow$][$\lambda^{[(C_0)]}[((x.y))][x]$]
[$ [((x.y))] $][$\Leftarrow$][$([(x.y)].[()])$]
[$ [(x.y)] $][$\Leftarrow$][$([x].[y])$]
[$ [y] $][$\Leftarrow$][$y$]
[$ [(car\ (list\ 1\ 2))] $][$\Leftarrow$][$([car].[((list\ 1\ 2))])$]
[$ [car] $][$\Leftarrow$][$car$]
[$ [((list\ 1\ 2))] $][$\Leftarrow$][$([(list\ 1\ 2)].[()])$]
[$ [(list\ 1\ 2)] $][$\Leftarrow$][$([list].[(1\ 2)])$]
[$ [()] $][$\Leftarrow$][$()$]
[$ [list] $][$\Leftarrow$][$list$]
[$ [(1\ 2)] $][$\Leftarrow$][$([1].[(2)])$]
[$ [1] $][$\Leftarrow$][$1$]
[$ [(2)] $][$\Leftarrow$][$([2].[()])$]
[$ [2] $][$\Leftarrow$][$2$]
[$ [(C_0)] $][$\Leftarrow$][$([C_0].[()])$]

Ahora vamos a querer evaluar la dirección de memoria [$m=[(car\ (list\ 1\ 2))]$] en el entorno [$E_0=[(C_0)]$] y usando la memoria [$M_0$]. Necesitaremos hallar los interrogantes de [$$ M_0\triangleright E_0 \vdash m \downarrow\ ????\ \triangleright\ ????$$] Deberemos proceder con la regla E-APP en la cual encontramos que [$[(car\ (list\ 1\ 2))]\Leftarrow ([car].[((list\ 1\ 2))])\in M_0$] Entonces, [$m_1=[car]$] y hemos de evaluar [$$ M_0 \triangleright E_0 \vdash m_1 \downarrow\ ????\ \triangleright\ ????$$] Hay que aplicar la regla E-VAR en la cual obtenemos como resultado la dirección de memoria [$[\lambda^{(C_0)}((x.y))(x)]$].

A continuación hemos de realizar el envoltorio. Aparcamos E-APP(car). Ahora, como [$[((list\ 1\ 2))]\Leftarrow ([(list\ 1\ 2).[()]) \in M_0$] es un par, hay que entrar en W-PAIR. Nos dice que evaluemos el primer componente del par que es[$[(list\ 1\ 2)]$]. Tendremos que usar E-APP otra vez.

Aparcamos W-PAIR(car) y E-APP(car) para entrar en E-APP(list). Como [$[(list\ 1\ 2)]\Leftarrow ([list].[(1\ 2)]) \in M_0$], la regla E-APP me dice que evalúe el primer componente del par. En este caso [$[list]$]. Aplicando E-VAR obtenemos que el resultado es la celda [$\lambda^{[(C_0)]}[x][x]$] y tengo que entrar en envoltorio otra vez.

Tenemos en suspenso E-APP(list), W-PAIR(car) y E-APP(car). Y estamos trabajando con W-PAIR para envolver [$[(1\ 2)]\Leftarrow ([1].[(2)])\in M_0$]. Esta regla me dice que evalúe el primer componente que por E-LIT es él mismo [$[1]$] y que vuelva a aplicar el envoltorio sobre el segundo componente [$[(2)]$]. Aparco este W-PAIR(1) y voy con W-PAIR otra vez.

En este punto están en suspenso W-PAIR(1), E-APP(list), W-PAIR(car) y E-APP(car). Seguimos trabajando con la memoria [$M_0$] y hemos de aplicar W-PAIR a [$[(2)]\Leftarrow ([2].[()])\in M_0$]. El resultado es que [$[2]$] se evalúa por E-LIT a él mismo y W-EMPTY me devuelve el propio [$[()]$].

Ahora ocurre una cosa muy importante. La regla W-PAIR modifica la memoria. Añade un par en una nueva dirección. El primer componente del par es el resultado de la evaluación del primer componente, que era [$[2]$] y el segundo, el del envoltorio, que era [$[()]$]. Entonces, mi nueva memoria será [$$M_1=M_0,m_0\Leftarrow ([2].[()])$$] y el resultado de W-PAIR es [$$ M_0 \triangleright E_0 \vdash [(2)] \Downarrow m_0 \triangleright M_1$$] Este cambio de memoria es importante porque ahora recuperamos W-PAIR(1) y usa [$M_1$] en vez de [$M_0$].

Nota: Escribo [$m_0$] en vez de [$[(2)]$] porque [$[(2)]$] ya está usado en [$M_0$] y se confundiría. Tenemos dos celdas con el mismo contenido en memoria.

Retomamos W_PAIR(1) y sigue en suspenso E-APP(list), W-PAIR(car) y E-APP(car). La regla W_PAIR vuelve a modificar la memoria. En este caso [$$M_2=M_1,m_1\Leftarrow ([1].m_0)$$] y lo que hemos demostrado es [$$ M_0 \triangleright E_0 \vdash [(1\ 2)] \Downarrow m_1 \triangleright M_2$$].

Retomamos E-APP(list) y sigue en suspenso W-PAIR(car) y E-APP(car). El siguiente antecedente de la regla E-APP es el que realiza el ajuste de patrones. En este caso hemos de ajustar [$\emptyset\{[x]\mid m_2\}_{M_2}$]. Es sencillo usando la regla P-VAR. El ajuste devuelve el contexto [$C_1=x\leftarrow m_2$].

A continuación, la regla E-APP introduce el nuevo contexto [$C_1$] en la memoria. La nueva memoria es [$$M_3=M_2, [C_1]\Leftarrow C_1, [(C_1 C_0)]\Leftarrow ([C_1].[(C_0)]$$] y el nuevo entorno está en [$[(C_1 C_0)]$]. En este nuevo entorno y con esta nueva memoria evaluamos el cuerpo de la clausura que era [$[x]$]. Usamos para ello la regla E-VAR y encontramos que [$x\leftarrow m_2 \in_{M_3} [(C_1 C_2)]$] por lo que el resultado es [$m_2$] con la propia memoria [$M_3$]. Entonces lo que hemos demostrado hasta ahora es que [$$ M_0 \triangleright E_0 \vdash [(list\ 1\ 2)] \downarrow m_2 \triangleright M_3 $$]

Retomemos W-PAIR(car) y mantengamos en suspenso E-APP(car). La regla W-PAIR, tras evaluar el primer componente del par, envuelve el segundo. Usando la regla W-EMPTY obtenemos [$[()]$] como resultado de este envoltorio. A continuación, modifica la memoria incluyendo un nuevo par en [$m_3$] con ambos resultados. Es decir que [$M_4=M_2,m_3\Leftarrow (m_2.[()])$] y hemos demostrado que [$$ M_0 \triangleright E_0 \vdash [((list\ 1\ 2))] \Downarrow m_3 \triangleright M_4$$]

Retomamos, por fin, E-APP(car). Hemos de realizar primero el ajuste de patrones en el cual obtenemos el contexto [$C_2=x\leftarrow [1],y\leftarrow m_1$]. Luego, incluimos un nuevo entorno en la memoria con ese contexto y con entorno padre el de la clausura. [$$M_5=M_4, [C_2]\Leftarrow C_2, [(C_2 C_0)]\Leftarrow ([C_2].[(C_0)])$$] Y, finalmente, evaluamos el cuerpo de la clausura. Es sencillo porque consta únicamente de una variable y aplicamos E-VAR. Demostramos, por fin, que [$$M_0 \triangleright E_0 \vdash [(car\ (list\ 1\ 2))] \downarrow [1] \triangleright M_5$$]

Valores predefinidos y formas especiales

Especificaremos muy pocas formas predefinidas. La más usual en un lenguaje imperativo es la evaluación en secuencia. Usaremos el valor predefinido [$|begin|$] para esta evaluación. Necesitamos tres reglas. La primera dice que la evaluación en secuencia de la lista vacía es la propia lista vacía.[$$\frac{m\Leftarrow ()\in M}{M\triangleright E \vdash |begin|m \rightarrow_\delta m \triangleright M}$$] La segunda regla indica que si la lista a evaluar en secuencia sólo tiene un elemento, el resultado es la evaluación de ese elemento. [$$\frac{m\Leftarrow (m_1.m_2)\in M \;\;\;\;\;\; m_2\Leftarrow () \in M \;\;\;\;\;\; M \triangleright E \vdash m_1 \downarrow m' \triangleright M'}{M\triangleright E \vdash m \rightarrow_\delta m' \triangleright M'}$$]Finalmente, si hay más de un elemento, evaluamos el primero y evaluamos en secuencia el resto.[$$\frac{m\Leftarrow (m_1.m_2)\in M \;\;\;\;\;\; m_2\Leftarrow () \notin M \;\;\;\;\;\; M \triangleright E \vdash m_1 \downarrow m'_1 \triangleright M_1 \;\;\;\;\;\; M_1 \triangleright E \vdash |begin|m_2 \rightarrow_\delta m' \triangleright M'}{M\triangleright E \vdash m \rightarrow_\delta m' \triangleright M'}$$]

Para definir una vinculación usamos el valor predefinido [$|def!|$].[$$\frac{m\Leftarrow (m_1.m_2) \in M \;\;\;\;\;\; m_1 \Leftarrow x \in M \;\;\;\;\;\; M \triangleright E \vdash |begin|m_2 \rightarrow_\delta m' \triangleright M'}{ M\triangleright E \vdash |def!|m \rightarrow_\delta m' \triangleright M' \langle E \Leftarrow x \leftarrow m'\rangle}$$] La relación auxiliar [$M \langle E \Leftarrow x \leftarrow m\rangle$] es la que realmente modifica la memoria con la nueva definición.[$$\frac{E\Leftarrow (m_1.E_2)\in M \;\;\;\;\;\; m_1 \Leftarrow C \in M}{M \langle E \Leftarrow x \leftarrow m\rangle = M\langle M_1 \Leftarrow C \langle x \leftarrow m \rangle \rangle}$$]

Es posible definir el valor predefinido [$|set!|$] que modifica una vinculación preexistente. La dificultad de esta definición estriba en hacerla recursiva (hacia el entorno padre) si no se halla la variable a modificar en el contexto actual.

viernes, 28 de octubre de 2011

El combinador Y en C++ (y II)

La primera parte de esta serie está aquí.

Como se comentó en la primera parte, el combinador Y toma una función g que representa un paso de recursión y devuelve una función p que es el punto fijo de g. Esto del punto fijo no es más que la función recursiva obtenida aplicando g a sí misma infinitas veces. El problema con este planteamiento es que currificar en C++ es difícil. Por esta razón usaremos una versión de g que no esté currificada. El prototipo de esta función sería:
#include <functional>

int g(std::function<int(int)> f,int v);
El tipo de los objetos función en C++ es muy largo y escribir "std::function" cada vez va a emborronar el código. Usaré una macro para aligerar la notación.
#include <functional>

//F(X,Y) es X->Y
#define F(X,Y) std::function<Y(X)>

//F(X,Y,Z) es (X,Y)->Z
#define F2(X,Y,Z) std::function&lg;Z(X,Y)>

int g(F(int,int) f,int v);
Ahora vamos a tratar de definir el combinador Y. La mejor forma de hacerlo es, en vez de usar las funciones lambda de C++ que son muy tediosas, usando la ecuación recursiva que obtuvimos en la primera parte.

Y(g)=g(Y(g))

Como ahora tengo a g sin currificar, he de añadir un argumento extra. Queda así:

Y(g)=[](x){g(Y(g),x)}

Entonces, el código del combinador Y para los enteros sería

F(int,int) Y(  F2( F(int,int) ,int,int)  f)
{
    return [=](int x){return f(Y(f),x);};
}

Realmente la parte difícil es la de los tipos, aunque se pueden obtener poco a poco estudiando la expresión.

Cambiar los int por un tipo genérico nos da el combinador Y genérico en C++:

template<typename T>
F(T,T) Y(  F2( F(T,T) ,T,T)  f)
{
    return [=](T x){return f(Y(f),x);};
}

Ahora sólo tenemos que usarlo. Definimos para eso la función g del factorial y lo volcamos a la salida. El código final es el que sigue:

#include <functional>

#include <iostream>

//F(X,Y) es X->Y
#define F(X,Y) std::function<Y(X)>
 

//F(X,Y,Z) es (X,Y)->Z
#define F2(X,Y,Z) std::function&lg;Z(X,Y)>

int g(F(int,int) f,int v)
{
    return v==0 ? 1 : v * f(v-1);
}

template<typename T>
F(T,T) Y(  F2( F(T,T) ,T,T)  f)
{
    return [=](T x){return f(Y(f),x);};
}

int main(int argc,char** argv)
{
std::cout << Y<int>(g)(5) << std::endl;
    return 0;
}

En este punto sólo queda advertir al lector que es necesario usar un compilador compatible con el estándar de C++ de 2011.

jueves, 27 de octubre de 2011

Semántica natural de LISP - parte 1 - LISP funcional

Como homenaje a McCarthy, voy a dedicar una serie de posts a descubrir la semántica natural del LISP. Empezaremos por un LISP reducido que llamaré LISP funcional en el cual no hay mutaciones de las vinculaciones de variables. Cualquiera que haya leído el SICP reconocerá que ésto se corresponde a la primera parte del libro.

La semántica natural o semántica de paso grande no es más que una relación que a cada programa [$t$] en un contexto [$C$] le proporciona un valor [$v$]. Escribiremos esta relación así [$$C \vdash t \downarrow v$$] y se lee "[$t$] se evalúa a [$v$] bajo el contexto [$C$]". Aunque antes debemos especificar claramente cuáles son las estructuras sintácticas que forman [$t$], [$C$] y [$v$].

Sintaxis

La sintaxis de los programas son términos [$t$] que son a su vez, o bien una variable [$x$], o bien un literal [$l$], o bien un par de términos [$(t.t)$]. Esto se escribe así: [$$t ::= x \mid l \mid ( t . t )$$] Dentro de los literales incluimos la lista vacía [$()$] que permite, junto con el par, formar listas. Una lista [$(1 2 3)$] es realmente [$(1.(2.(3.())))$]. Es decir, el primer componente del par es el término que está en la cabeza de la lista y el segundo componente es otra lista que representa al resto de los términos. Es común llamar a estos componentes "head" y "tail"  (cabeza y cola en inglés) o "car" y "cdr". Estos dos últimos nombres tienen una historia más larga.

Los literales son símbolos como [$1, 53, "hola",$] etc. que tienen un valor en sí mismos. Las variables son símbolos como [$x, y, z,$] etc. que requieren un contexto para saber el valor que representan.

La sintaxis de los valores [$v$] es o bien un término [$t$], o bien una clausura [$\lambda ^C t t$], o bien una forma predefinida [$|p|$]. [$$v::=t\mid \lambda^C tt \mid |p|$$] Escribiremos las formas predefinidas entre barras para distinguirlas de las variables y literales, aunque el símbolo que sea [$p$] puede coincidir con ellos.

Los contextos no son más que una colección de vinculaciones de valores a variables.[$$ C::= \emptyset \mid C,x\leftarrow v$$] Construímos los contextos con el contexto vacío [$\emptyset$] al que le vamos agregando vinculaciones de la forma [$x\leftarrow v$]. Aunque la forma correcta de escribir un contexto sea [$\emptyset, x \leftarrow 5, y \leftarrow 8$], omitiremos el [$\emptyset$].

Operaciones sobre contextos

Vamos a necesitar un par de operaciones para trabajar con los contextos. Son muy simples. La primera es el dominio del contexto [$dom\ C$] que nos dice qué variables se han usado en un contexto. [$$ dom\ \emptyset = \emptyset $$][$$ dom(C,x\leftarrow v)=dom(C)\cup\{x\}$$]

La segunda operación busca una variable en un contexto. Lo escribiremos como una relación de pertenencia [$x\leftarrow v \in C$] para simplificar la lectura. [$$x\leftarrow v\in C,x\leftarrow v$$][$$\frac{x\ne x'\;\;\;\;\;\;x\leftarrow v\in C}{x\leftarrow v\in C,x'\leftarrow v'}$$]La primera línea es una regla tan obvia que lo mismo es difícil de entender: [$x\leftarrow v$] pertenece a [$C,x\leftarrow v$]. La segunda regla dice que [$x\leftarrow v$] pertenece a [$C,x'\leftarrow v'$] si [$x$] es distinta a [$x'$] y [$x\leftarrow v$] pertenece a [$C$]. Si llega un momento que [$C=\emptyset$], no podremos usar ninguna de las dos reglas (y por tanto [$x\leftarrow v$] no pertenecerá).

Ajuste de patrones

Llegará un momento en la evaluación en el cual tendremos que relacionar argumentos con parámetros. La forma más inteligente de hacerlo es usando el ajuste de patrones, también llamado asignación desestructurante. El ajuste de patrones que vamos a ver aquí es muy simple: toma un término y un valor, devolviendo las vinculaciones que deberían tener las variables del término para que se ajuste al valor proporcionado. Por ejemplo. Si quiero ajustar [$x$] y [$3$], lo escribiré así [$\{x\mid 3\}$] y el resultado será que la variable [$x$] ha de vincularse al valor [$3$]. Esta vinculación es la que hemos escrito [$x\leftarrow 3$] en los contextos. Como no tenemos contexto al que añadir la vinculación, lo incluiremos en nuestro ajsute de patrones. El resultado es que el ajuste de patrones es una relación [$C\{t\mid v\}=C$]. El ejemplo de arriba se podría completar entonces con [$$z\leftarrow 8\;\{x\mid 3\}=z\leftarrow 8,x\leftarrow 3$$]Más ejemplos serían [$$z\leftarrow 8\;\{(x\; y)\mid (3\;7)\}=  z\leftarrow 8,x\leftarrow 3,y\leftarrow 7$$][$$\emptyset\{(x y. z)\mid(1 \; (2 \; 3) \; 4 \; 5 \; 6)\}=x\leftarrow 1,y\leftarrow(2\;3), z\leftarrow(4  \;5  \; 6)$$][$$x\leftarrow 5\{x\mid 5\}=???$$] En el último ejemplo no es posible calcular el ajuste de patrones porque [$x$] ya está definida. ¡Incluso si le vamos a dar el mismo valor! De esta manera cada contexto sólo tendrá una única aparición de cada variable.

Las reglas del ajuste de patrones son muy sencillas. En primer lugar, la regla D-LIT dice que los literales han de coincidir.[$$C\{l\mid l\}=C$$] La regla D-VAR modifica el contexto vinculando la variable, que no está definida previamente, al valor.[$$\frac{x\notin C}{C\{x\mid v\}=C,x\leftarrow v}$$] Finalmente, la regla D-PAIR es meramente estructural.[$$C\{(t_1.t_2)\mid(v_1.v_2)\}=C\{t_1\mid v_1\}\{t_2\mid v_2\}$$]

La evaluación

Llega la hora de dar la relación de evaluación [$C \vdash t \downarrow v$] que antes mencionábamos. Son cuatro reglas. La primera, que llamaremos E-LIT, es para saber el valor de un literal. Es muy sencillo porque es él mismo. [$$C \vdash l \downarrow l$$] La segunda (E-VAR) es para saber el valor de una variable. Necesitamos consultar el contexto.[$$\frac{x\leftarrow v \in C}{C \vdash x\downarrow v}$$] La tercera la usaremos para pares cuya cabeza se evalúe a un valor por predefinido. La llamaremos E-PRE. [$$\frac{C\vdash t_0 \downarrow |p|  \;\;\;\;\;\; C\vdash (|p| t_1 \cdots t_n) \rightarrow_\delta v}{C\vdash (t_0 t_1 \cdots t_n)\downarrow v}$$] Aquí hemos usado una relación auxiliar [$C\vdash v\rightarrow_\delta v$] en la que introduciremos la semántica de los valores predefinidos (ver más abajo). Finalmente, la regla E-APP, formaliza el uso de una clausura.[$$\frac{C\vdash t_0 \downarrow \lambda^{C'}t't''  \;\;\;\;\;\; C\vdash (t_1 \cdots t_n) \Downarrow (v_1 \cdots v_n)   \;\;\;\;\;\;  C' \{ t' \mid (v_1 \cdots v_n) \}\vdash t''\downarrow v}{C\vdash (t_0 t_1 \cdots t_n) \downarrow v}$$] Hemos usado el ajuste de patrones en el último antecedente (a la derecha del todo.) También hemos usado una relación auxiliar [$ C\vdash (t_1 \cdots t_n) \Downarrow (v_1 \cdots v_n) $] que llamaremos de "envoltorio" que lo único que hace es evaluar una lista de términos, término a término, para obtener una lista de valores.

Las reglas de esta relación auxiliar de envoltorio son muy simples. Primero, la lista vacía se envuelve a sí misma. [$$C\vdash () \Downarrow ()$$] Y segundo, un par evalúa su cabeza y envuelve el resto. [$$\frac{C\vdash t_1 \downarrow v_1  \;\;\;\;\;\; C\vdash t_2 \Downarrow v_2}{C \vdash (t_1.t_2) \Downarrow (v_1.v_2)}$$] En general podemos ver la relación de envoltorio como una abreviatura de
[$$C\vdash t_1 \downarrow v_1   \;\;\;\;\;\;     C\vdash t_2 \downarrow v_2     \;\;\;\;\;\;  \cdots   \;\;\;\;\;\;   C\vdash t_n \downarrow v_n  $$]  que escribimos [$$ C\vdash (t_1t_2\cdots t_n) \Downarrow (v_1v_2\cdots v_n)$$]

Formas predefinidas

Las formas predefinidas nos pueden servir para trabajar con los literales. Por ejemplo, la suma se puede formalizar así (llamaremos a esta regla P-ADD): [$$\frac{C\vdash (t_1 \cdots t_n)\Downarrow (N_1 \cdots N_n) }{  C\vdash (|+| t_1 \cdots t_n)\rightarrow_\delta \sum_{k=1}^n{N_k}  }$$] Donde los [$N$] mayúsculas han de ser literales de número como el [$3$] o el [$75.82$].

Entre todas las formas es especialmente importante la que genera clausuras. Llamaremos a este valor predefinido[$|\lambda|$] y se define con la regla P-LAMBDA [$$C\vdash (|\lambda| t_1 t_2) \rightarrow_\delta \lambda^Ct_1 t_2 $$] Con esta forma especial podemos definir funciones.

Ejemplos de evaluación

Si usamos un contexto inicial [$$C_0 = lambda \leftarrow |\lambda|, +\leftarrow |+|$$] tenemos suficiente potencia expresiva para calcular el doble de [$3$] (realmente, con lambda y usando la codificación de Church, tenemos la potencia expresiva de un modelo computacional Turing completo). Me he tomado algunas libertades para simplificar la derivación (no he usado la abreviatura del envoltorio y le he dado nombres a los contextos). El resultado es el que sigue (clic para ampliar):


En el contexto inicial podemos incluir más definiciones. Algunas funciones típicas son:[$$car\leftarrow \lambda^{C_0}((x.y))x$$][$$cdr\leftarrow\lambda^{C_0}((x.y))y$$][$$list\leftarrow\lambda^{C_0}xx$$][$$cons\leftarrow\lambda^{C_0}(x y)(x.y)$$] Con este nuevo contexto inicial podemos calcular el segundo elemento de la lista [$(1 2 3)$]. La derivación (omitiendo ya nombres de reglas) es la que sigue:


Hasta aquí por hoy. En la siguiente parte de esta serie permitiremos mutaciones en la vinculación de las variables.

lunes, 26 de septiembre de 2011

Semántica formal para clausuras léxicas

El lambda cálculo es una herramienta asombrosa. En pocas líneas puedes definir un modelo de computación. Esta simplicidad permite transmitir ideas de manera formal con relativa facilidad. Por esa razón estuve pensando cómo explicar la clausura léxica de manera matemática.

El lambda cálculo con semántica natural

Empezaré por el lambda cálculo con semántica natural (también llamada operacional de paso grande). La sintaxis del lambda cálculo es muy sencilla. [$$t::=x\mid tt\mid \lambda x.t$$] Este tipo de definiciones sintácticas se leen así:

[$t::=$]Un término (o expresión) es
[$x$]o bien una variable
[$tt$]o bien una aplicación de un término sobre otro
[$\lambda x.t$]o bien una función que toma una variable y devuelve un valor calculado por un término. Esto es a lo que se llama una abstracción lambda o función anónima.


Nota: La aplicación se asocia por la izquierda. Entonces, en vez de escribir [$(((t_1 t_2) t_3) t_4)$] escribimos [$t_1 t_2 t_3 t_4$]. 

Lo que es la semántica es también muy fácil de expresar: un término se convierte en un valor mediante una relación binaria [$t\Downarrow v$]. Los valores [$v$] sólo son un tipo especial de término que se denominan formas normales (nosotros vamos a usar WNF). [$$v::= \lambda x.t \mid x v_1 \cdots v_n$$]  Estas formas normales no se pueden reducir más con las reglas de evaluación con las que vamos a expresar la semántica. Estas reglas son las siguientes:
   
Regla E-VAR[$$x\Downarrow x$$]Regla E-ABS[$$\lambda x.t \Downarrow \lambda x.t $$]
Regla E-APVAL[$$\frac{\begin{array}{c}t_1 \Downarrow x v_1 \cdots v_k\\t_2 \Downarrow v \end{array}}{t_1 t_2 \Downarrow x v_1 \cdots v_k v}$$] Regla E-APABS [$$\frac{\begin{array}{c}t_1 \Downarrow \lambda x.t\\t_2 \Downarrow v \\ [x\leftarrow v]t\Downarrow  v'\end{array}}{t_1 t_2 \Downarrow v'}$$]
Como se comprobará, las reglas E-VAR y E-ABS no son complicadas ya que tanto las variables como las abstracciones son valores. El núcleo de todo está en las aplicaciones.
Tanto la regla E-APVAL como la regla E-APABS tienen una forma que recuerda a las fracciones. Esta es una notación usual en lógica para especificar reglas de inferencia e indica que si lo de arriba, que es el antecedente, se cumple, entonces lo de abajo, el consecuente, se debe cumplir.

La regla E-APVAL toma dos términos aplicados el [$t_2$] al [$t_1$]. Si resulta que [$t_1$] tras evaluar tiene un valor que no es una abstracción, lo único que podemos hacer es poner el valor de [$t_2$] detrás de la forma normal, haciéndola un poco más larga. Esto tiene algo más de sentido si, por ejemplo, usamos una variable que se llame [$lista$] y evaluemos algo como [$(lista\ 1\ 7) (2+3)$]. El resultado es la propia [$lista\ 1\ 7$] con un añadido que es el valor de [$2+3$]. Es decir, que [$  (lista\ 1\ 7) (2+3) \Downarrow lista\ 1\ 7\ 5$].

La regla E-APABS también toma dos términos aplicados. Esta vez tiene que ocurrir que [$t_1$] se evalúa a una función [$\lambda x.t$]. Entonces, hay que aplicar el resultado de [$t_2$] que es [$v$] a la función. La forma de hacerlo es sustituir todas las apariciones de [$x$] en [$t$] por [$v$] y calcular el valor que nos da esto. La sustitución la hemos escrito como [$[x\leftarrow v]$].

Entonces, si queremos calcular el doble de 1+3, sería evaluar [$(\lambda x.x+x)(1+3)$]. Usando la regla E-APABS vemos que, efectivamente, [$t_1=  \lambda x.x+x$] y que [$t_1 \Downarrow   \lambda x.x+x $] gracias a la regla E-ABS. Entonces, [$t=x+x$]. Por otra parte, [$t_2=1+3$] y [$t_2 \Downarrow 4$]. Finalmente, la sustitución a realizar es [$[x\leftarrow  4]t = 4+4$]. La evaluación es [$4+4\Downarrow 8$] por lo que [$v'=8$] y podemos decir que ocho es el doble de cuatro: [$$(\lambda x.x+x)(1+3)\Downarrow 8$$]

Nota: ¿Cómo es que estamos usando sumas y números si no los hemos definido? Realmente, sí que lo están. El lambda cálculo permite codificar los números (y muchas más cosas) como funciones. Esta es la llamada codificación de Church.


El lambda cálculo sin sustituciones

El lambda cálculo es Turing completo. Esto quiere decir que cualquier función calculable se puede calcular en él. Esto, por otra parte, no significa que sea eficiente computacionalmente. De hecho, la sustitución es una operación muy costosa: hay que recorrer todo el término en el que queremos sustituir y comparar las variables y manipular grandes trozos de expresión. Las reglas exactas son estas:


[$$[x\leftarrow t]x=t$$][$$\frac{x\ne x'}{[x\leftarrow t]x'=x'}$$]
[$$[x\leftarrow t](t_1 t_2)=(  [x\leftarrow t] t_1 ) (   [x\leftarrow t]  t_2 )$$][$$[x\leftarrow t]\lambda x.t' =  \lambda x. t' $$]

La última regla está más abajo y es la más divertida porque tiene que evitar capturar las variables. Para hacer esto debe explorar además del término donde se sustituye el término a sustituir. Más coste.
[$$\frac{\begin{array}{c}x\ne x'\\x'\notin fv(t)\end{array}}{[x\leftarrow t]\lambda x'.t' =  \lambda x'. [x\leftarrow t] t' }$$] Todos los creadores de compiladores e intérpretes buscan los métodos más curiosos para evitar la sustitución. Uno de estos métodos es la evaluación por entornos, aunque hay más como las máquinas G, los supercombinadores, etc.

Nosotros vamos a usar la evaluación por entornos que es más simple. La idea es sencilla: no sustituimos, sólo apuntamos lo que hay que sustituir. Lo apuntamos en un entorno que es una colección de vinculaciones de ese tipo. [$$ E::= \emptyset \mid E, x=v $$] Añadimos el entorno a nuestra relación de evaluación de esta manera [$$ E \vdash t \Downarrow v$$] Se podría leer "bajo el entorno [$E$] el término [$t$] se evalúa a [$v$]".

La idea es sencilla, ahora hay que establecer las reglas de evaluación. Un primer intento podría ser éste:

   
Regla E-VAR[$$\frac{x=v \in E}{E\vdash x\Downarrow v}$$]Regla E-ABS[$$E\vdash\lambda x.t \Downarrow \lambda x.t $$]
Regla E-APVAL[$$\frac{\begin{array}{c}E \vdash t_1 \Downarrow x v_1 \cdots v_k\\ E \vdash t_2 \Downarrow v \end{array}}{E \vdash t_1 t_2 \Downarrow x v_1 \cdots v_k v}$$] Regla E-APABS [$$\frac{\begin{array}{c} E \vdash t_1 \Downarrow \lambda x.t\\ E \vdash t_2 \Downarrow v \\   E,x=v \vdash t\Downarrow  v'\end{array}}{ E \vdash t_1 t_2 \Downarrow v'}$$]
El truco está en la nueva regla E-VAR que mira en el entorno el valor de la variable encontrada y en la regla E-APABS que introduce en el entorno la vinculación.

Desafortunadamente estas reglas no funcionan.

El problema se observa en la siguiente evaluación [$$\emptyset \vdash (\lambda y.\lambda x.y) 3 \Downarrow v'$$] La regla a aplicar sería E-APABS que me diría que [$$ y=3 \vdash \lambda x.y \Downarrow v'$$] La regla E-ABS terminaría la evaluación incorrectamente [$$ y=3 \vdash \lambda x.y \Downarrow \lambda x.y$$] en vez de la correcta [$\lambda x.3$]. Hay que evitar que se pierda el entorno en la regla E-ABS. Al perder el entorno la expresión [$\lambda x.y$] queda abierta con la variable [$y$] libre. La solución es cerrarla con una clausura. La clausura será léxica porque hemos ido descendiendo por las estructuras sintácticas arrastrando los entornos hasta aquí.

Incluyamos entonces un nuevo término a nuestra sintaxis: las clausuras léxicas. Que son la combinación de una abstracción lambda y un entorno. [$$ t::= x\mid tt \mid \lambda x.t \mid \lambda^E x.t $$] Ahora los valores son [$$ v::= \lambda^E x.t \mid x v_1 \cdots v_k$$] y las reglas de evaluación correctas serían
   
Regla E-VAR[$$\frac{x=v \in E}{E\vdash x\Downarrow v}$$]Regla E-ABS[$$E\vdash\lambda x.t \Downarrow \lambda^E x.t $$]
Regla E-APVAL[$$\frac{\begin{array}{c}E \vdash t_1 \Downarrow x v_1 \cdots v_k\\ E \vdash t_2 \Downarrow v \end{array}}{E \vdash t_1 t_2 \Downarrow x v_1 \cdots v_k v}$$] Regla E-APABS [$$\frac{\begin{array}{c} E \vdash t_1 \Downarrow \lambda^{E'} x.t\\ E \vdash t_2 \Downarrow v \\   E',x=v \vdash t\Downarrow  v'\end{array}}{ E \vdash t_1 t_2 \Downarrow v'}$$]
He cambiado la regla E-ABS convirtiendo la abstracción (que es código) en la clausura léxica (que es un valor) y la regla E-APABS que ahora usa el entorno de la clausura en vez del entorno de llamada.

Si evaluamos otra vez   [$$\emptyset \vdash (\lambda y.\lambda x.y) 3 \Downarrow v'$$] obtenemos que [$ v'=\lambda^{y=3}x.y$]. Lo cual me dice que hay una sustitución pendiente de [$y$] por el valor [$3$]. Esta sustitución se hará cuando se aplique la función. No se perderá.

Nota: Hay un pequeñísimo detalle a tener en cuenta en estas nuevas reglas. Si queremos hacer una lista como hicimos antes [$lista\ 1\ (1+1)$] no podremos evaluarla. Eso es así porque la variable [$lista$] no está en el entorno y no podremos aplicar la regla E-VAR. Una solución a esto es añadir un entorno inicial donde [$lista=lista$] de manera que [$ lista=lista \vdash lista\ 1\ (1+1) \Downarrow   lista\ 1\ 2$]. Esto nos debe llevar a pensar que hay dos tipos de variables las de código ([$lista$][$=lista$]) y las de valor ([$lista=$][$lista$]). Haciendo que las variables de valor tengan también entorno ([$x^E$]) abrimos la puerta a las macros higiénicas.

miércoles, 11 de mayo de 2011

El punto de la pereza

Hace unos días Bob Harper, que defiende SML con uñas y dientes, se dedicó a atacar a los elitistas del Haskell. Su idea era muy sencilla: los tipos de Haskell no son inductivos. Voy a intentar explicar esto de forma sencilla.

Tipos inductivos

Son los tipos cuyos valores se construyen con unos valores bases y unos constructores. El caso arquetípico son los números naturales.
  • El 0 es un valor base.
  • El siguiente número natural S(n), es un constructor que, dado un número, construye otro.
Con esto y la inducción estructural tenemos los números naturales (y podemos demostrar propiedades sobre ellos).
  • El cero es 0
  • El uno es S(0)
  • El dos es S(S(0))
  • Y así.
También es posible usar como argumento de un constructor el valor de otro tipo. Este otro tipo será un parámetro del nuevo tipo. De esa manera aterrizamos en los tipos algebraicos. Por ejemplo, las listas de valores de un tipo T que llamaremos L(T) será.
  • La lista vacía [] es un valor base.
  • El constructor de lista  cons(V,R) toma un valor V de un tipo T y el resto de la lista R de tipo L(T).
Con esto y la inducción estructural, obtenemos las listas que queramos (y podemos demostrar propiedades sobre ellas).
  • Tomamos la lista vacía [] como valor base de una lista de enteros L(int)
  • Añadimos  un entero  cons(-3, [])
  • Añadimos otro entero  cons(7, cons(-3, []) )
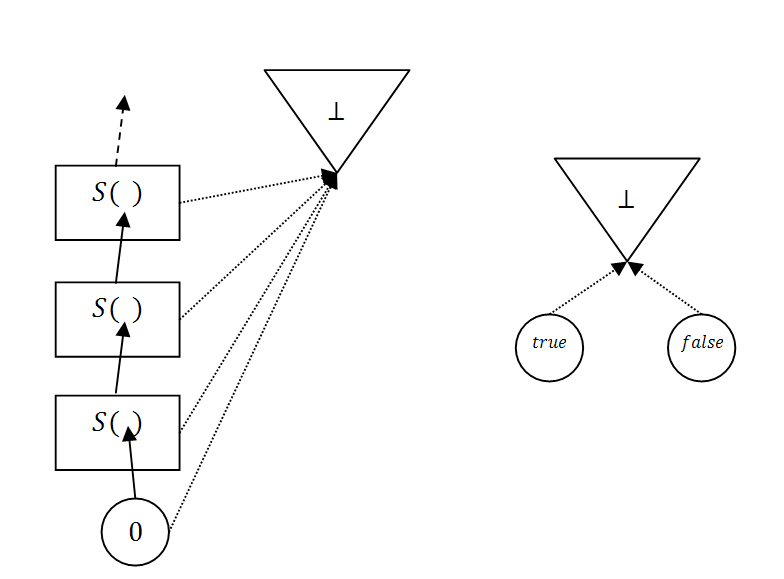
Todos estos tipos inductivos tienen una forma muy similar si se dibujan: son bosques de árboles (matemáticamente son órdenes parciales completos, también llamados dominios). En concreto, los números naturales son un árbol de una única rama.
Los números naturales son inductivos. El valor base es el 0, en un círculo, y el constructor es S(n), en rectángulos. De esta manera tenemos representados en la figura, de abajo arriba, los valores 0, S(0), S(S(0)), S(S(S(0))) y así sucesivamente.
Los booleanos son dos árboles sin ramas.
Los booleanos son dos valores base: true y false. No hay constructores. Estos tipos sin constructores suelen llamarse tipos enumerados.

Las listas de naturales son árboles con infinitas ramas ya que, cada vez que usamos un constructor con un natural distinto, generamos una nueva rama. Es difícil dibujar esto porque cada una de las infinitas ramas lleva a infinitos valores que, a su vez, vuelven a tener infinitas ramas. Con un poco de imaginación el diagrama sería algo así.
Lista de naturales. La lista vacía es el valor base [] que está abajo. A partir de él construimos infinitos valores, uno para cada natural. Serían las listas de un único natural. Asimismo, de cada uno de estos valores se obtienen otros infinitos valores. A este tipo de árboles infinitos pero con una estructura simple se los denomina árboles regulares.

Existen también los llamados tipos coinductivos en los cuales, en vez de tener una lista vacía (valores base) y usar constructores sobre ella, tenemos una lista llena (valores co-base) y usamos destructores (co-constructores) sobre ella. No hablaré mucho más de esto aquí.

Evaluación perezosa 

La evaluación perezosa, de la que hablamos alguna que otra vez, consiste básicamente en no evaluar hasta que no sea estrictamente necesario. Un caso clásico es la multiplicación por cero.

0*(7+5)

¿Para qué sumar siete y cinco si sabemos que al final la multiplicación va a ser cero? Bueno, existe un motivo por el que evaluar los argumentos y son los efectos laterales. Si en vez de sumar dos números imprimiésemos un mensaje, la cosa cambia.

0*(print "hola") 

Ahora sí que habría que imprimir "hola" aunque el resultado de esta multiplicación (si es que print devuelve un número, claro) sea cero. Pues bien, ocurre que en Haskell no hay efectos secundarios. Es un lenguaje funcional. En este lenguaje de programación sí que conviene no perder tiempo evaluando cosas que, al final, no se van a usar.

La idea fundamental de la crítica de Harper es que siempre existen los efectos secundarios. En concreto existe un efecto secundario que jamás puedes quitarte de encima en un lenguaje de programación Turing completo. Ese efecto es... que la computación no termine.

Imaginemos el siguiente programa:

f(x) = 1+f(x)  //Esta computación no termina 
0*f(3) 

Si el lenguaje es estricto y evalúa f(3), nunca llega a ejecutar la multiplicación. Si el lenguaje es perezoso y no evalúa f(3), la multiplicación ha aceptado un valor que no es un número (de hecho ni siquiera es un valor, es no terminación) y lo ha tratado como si fuera un número. ¿Cuál es el tipo del argumento que ha aceptado la multiplicación?

Los lenguajes con evaluación perezosa cuelan entre los valores de sus tipos la no terminación. O mejor dicho, algo todavía sin evaluar que puede ser no terminación o puede ser un valor concreto. Este valor tan especial que se puede convertir en otro (o no) se corresponde con el mínimo de un orden parcial completo con mínimo. Este mínimo tiene el nombre de "punto" y se suele representar con el símbolo [$\bot$].

Si añadimos el punto a los tipos inductivos el resultado es que ¡no son inductivos! Los naturales y los booleanos quedan algo así.
Los naturales y booleanos con punto. El punto representa la no evaluación (con la no terminación como posibilidad). El punto está más allá de la inducción. No se pueden usar técnicas inductivas para demostrar propiedades de él.
Esto rompe la posibilidad de usar la inducción estructural porque el punto queda más allá, más arriba, del resto de valores. Así que, según Harper, usar la evaluación perezosa es equivalente a olvidarse de la inducción estructural y, con ella, poder demostrar con facilidad múltiples propiedades en nuestro programa.

Epílogo

Por supuesto, esto es todo cuestión de compromisos. Usar evaluación perezosa abre la puerta a tener tipos coinductivos con mucha facilidad. De hecho la "lista llena" de la que hablé antes es precisamente el punto [$\bot$]. Una computación que puede no terminar, una lista infinita, de la cual vamos extrayendo valores, como los iteradores. Esto permite cosas nuevas como el uso de la composición en estos tipos coinductivos, lo que abre la posibilidad a la reutilización de código.

viernes, 29 de abril de 2011

Transformación CPS

Hace algún tiempo hablamos de las continuaciones. Además, dimos una semántica operacional para ellas. Ahora vamos a describir cómo se transforma un programa para que use continuaciones en todas sus llamadas a función. Esto es el estilo de paso de continuaciones (CPS) que permite eliminar la necesidad de usar una pila de llamadas. Es decir, la cadena dinámica.

El estilo de paso de continuaciones (CPS)

Para empezar, veamos cómo es eso del CPS. Supongamos la siguiente expresión.
[$$ f(g(a)) $$]
Lo primero que calculamos es el valor de [$a$]. Luego, el valor de [$g(a)$] y, finalmente, el valor de [$f(g(a))$]. El estilo CPS añade un argumento adicional a cada función que es la continuación, a la que le pasaremos el resultado cuando la función termine.

¿A dónde pasábamos el resultado de [$g(a)$]? A [$f$]. Así que, al hacer [$g$] CPS, la expresión de arriba queda
[$$ g(f, a) $$]
y se leería algo así como "calcula [$g(a)$] y pásale el resultado a [$f$]. El problema es que también tenemos que hacer CPS a [$f$] por lo que ahora [$f$] no toma un argumento, toma dos: la continuación y su argumento propiamente dicho. La solución es añadir una función anónima. La expresión de arriba con tanto [$g$] como [$f$] puestas en CPS sería así:
[$$g(\lambda x.f(k,x), a)$$]
El detalle es que [$k$] es la continuación de la expresión, que no sabemos cuál es porque no he dicho qué vamos a hacer después de calcular [$f(g(a))$]. Para destacar claramente que [$k$] es la continuación, que [$f(g(a))$] es la expresión original y que [$g(\lambda x.f(k,x), a)$] es la expresión transformada a CPS, vamos a usar la siguiente notación:
[$$ T\ [\ f(g(a))\mid k\ ]\ = g(\lambda x.f(k,x), a) $$]

La transformación de Plotkin

Bastará conocer las reglas de la transformación [$ T\ [\ ]$] para poder realizarla. Esto es a lo que se dedicó Plotkin en 1975 en el artículo "Call-by-name, call-by-value and the [$\lambda$]-calculus", aunque ha llovido mucho y la versión que presento aquí es bastante distinta a la original.

Lo primero que necesitamos es definir el lenguaje que vamos a transformar. Vamos a usar una variante del lambda cálculo sin currificar. Es muy sencilla: un valor es o bien una variable o bien una función anónima.
[$$ v::= x \mid \lambda (x_1,...,x_n).e $$]
Una expresión es o bien un valor o bien una aplicación (llamo [$s$] a las aplicaciones).
[$$ e::= v \mid s $$]
También llamaremos, [$k$] a una expresión. Una aplicación no es más que una llamada a función.
[$$ s::= e_0 (e_1,...,e_n) $$]
Para transformar un programa escrito con esta sintaxis hemos de dar la transformación para cada una de estas construcciones sintácticas. Si lo que tengo un valor, ya está calculado, sólo he de pasarlo a la continuación. ¡Pero ojo! Si es una función he de transformarla antes en CPS. De esto se va a encargar la transformación auxiliar [$ M[\ ]$].
  • Regla P-TV: [$ T\ [\ v\mid k\ ]= k(M[\ v\ ])$]
La transformación auxiliar es bien sencilla: si no es una función no hace nada, si es una función le añade el argumento de la continuación y transforma su cuerpo.
  • Regla P-MX:  [$ M\ [\ x\ ]=x $]
  • Regla P-ML: [$ M\ [\ \lambda(x_1,...,x_n).e\ ]=\lambda(x,x_1,...,x_n).T[\ e\mid x\ ] $]
Finalmente, si lo que tenemos es una aplicación, vamos calculando su operador y argumentos hasta que, al final, podamos llamar a la función.
  • Regla P-TS: [$ T\ [\ e_0(e_1,...,e_n) \mid k\ ]=T[\ e_0 \mid \lambda x_0.T[\ e_1 \mid \lambda x_1.\ ...T[\ e_n \mid \lambda x_n. x_0(k, x_1,...,x_n)\ ]\ ...\ ]\ ] $]
Va a ser muy habitual encontrarnos con transformaciones anidadas del tipo [$...T[\ e\mid\lambda x.T[...$] ya que representan una secuencia de operaciones. El resultado de [$e$] se pasa a la continuación que empieza por [$\lambda x...$] lo que hace guardar el resultado de [$e$] en [$x$] y proseguir con la ejecución de la secuencia. Para facilitar la comprensión de una expresión en CPS vamos a poner como subíndice de una variable la expresión cuyo valor guarda.

Bien, ahora que tenemos las cuatro reglas de Plotkin vamos a probar a ver cómo transforma a [$f(g(a))$]. Vamos a hacerlo paso a paso.
  1. Inicial: [$T[\ f(g(a)) \mid k\ ]$]
  2. Regla P-TS: [$ T[\ f \mid \lambda x_f.T[\ g(a) \mid \lambda x_{g(a)}. x_f(k, x_{g(a)})\ ]\ ] $]
  3. Regla P-TV: [$ (\lambda x_f.T[\ g(a) \mid \lambda x_{g(a)}. x_f(k, x_{g(a)})\ ]\ )(M[\ f\ ]) $]
  4. Regla P-MV: [$ (\lambda x_f.T[\ g(a) \mid \lambda x_{g(a)}  . x_f(k, x_{g(a)})\ ]\ )(f) $]  
  5. Regla P-TS: [$ (\lambda x_f.T[g \mid \lambda x_g.T[\ a \mid \lambda x_a. x_g( \lambda x_1. x_f(k, x_{g(a)}) , x_a)\ ]\ ]\ )(f) $]  
  6. Regla P-TV: [$ (\lambda x_f. (\lambda x_g.T[\ a \mid \lambda x_a. x_g( \lambda x_{g(a)}. x_f(k, x_{g(a)}) , x_a)\ ]\ )(M[\ g\ ]) )(f) $]
  7. Regla P-MV: [$ (\lambda x_f. (\lambda x_g.T[\ a \mid \lambda x_a. x_g( \lambda x_{g(a)}. x_f(k, x_{g(a)}) , x_a)\ ]\ )(g) )(f) $]
  8. Regla P-TV: [$ (\lambda x_f. (\lambda x_g.  (\lambda x_a. x_g( \lambda x_{g(a)}. x_f(k, x_{g(a)}) , x_a) )(M[\ a\ ]\ ) )(g) )(f) $]
  9. Regla P-MV: [$ (\lambda x_f. (\lambda x_g.  (\lambda x_a. x_g( \lambda x_{g(a)}. x_f(k, x_{g(a)}) , x_a) )(a) )(g) )(f) $]
 El resultado de esta expresión es sorprendentemente complejo. Además, parece que podríamos usar varias veces la regla beta para reducir un poco más la expresión.
  1. Del anterior: [$ (\lambda x_f. (\lambda x_g.  (\lambda x_a. x_g( \lambda x_{g(a)}. x_f(k, x_{g(a)}) , x_a) )(a) )(g) )(f) $]
  2. Regla beta: [$ (\lambda x_g.  (\lambda x_a. x_g( \lambda x_{g(a)}. f(k, x_{g(a)}) , x_a) )(a) )(g) $]
  3. Regla beta: [$ (\lambda x_a. g( \lambda x_{g(a)}. f(k, x_{g(a)}) , x_a) )(a) $]
  4. Regla beta: [$ g( \lambda x_{g(a)}. f(k, x_{g(a)}) , a) $]
Esto sí se parece a lo que teníamos inicialmente, el problema es que no podemos realizar reglas beta ya que estamos transformando código y ¿cómo sabemos qué lambdas son del código y qué lambdas son las introducidas por la transformación?

¡Ah!... Se me ocurre una idea. Podríamos etiquetarlas...

Nota: ¿Por qué no podemos realizar reglas beta en el código? Imaginemos la siguiente expresión [$(\lambda x.3)(f(x))$]. Si [$f(x)$] tiene efectos secundarios, al realizar la regla beta obtendríamos [$3$] y habríamos perdido los efectos secundarios.

 La tranformación de alto nivel de Appel

Esta fue la idea que se le ocurrió a Appel en 1992 para su libro "Compiling with Continuations", pero no es tan sencilla. En primer lugar estaríamos tentados a etiquetar (con una rayita encima) las lambda que fueran introducidas por la transformación a CPS. Empecemos por la regla que las introduce: la P-TS que renombraremos a A-TS.

  • Regla A-TS: [$ T\ [\ e_0(e_1,...,e_n) \mid k\ ]=$][$T[\ e_0 \mid \bar\lambda x_0.T[\ e_1 \mid \bar\lambda x_1.\ ...T[\ e_n \mid \bar\lambda x_n. x_0(k, x_1,...,x_n)\ ]\ ...\ ]\ ] $]
El problema es que las [$\bar\lambda$] no son código, son funciones sobre el código (de ahí lo de alto nivel). Si dejáramos las cosas así obtendríamos
[$$ T[\ f(a)(b)\ ]=f(\bar\lambda x_{f(a)}.x_{f(a)}(k,b), a) $$]
Y eso no es código. No es código porque contiene un [$\bar\lambda$] que es una función sobre el código. No está en la sintaxis que pusimos al inicio.

La solución se obtiene forzando que las continuaciones se especifiquen siempre de forma indirecta, como una función sobre el código. En ese aspecto, cambiamos la regla P-ML de la siguiente forma (la nueva regla es la A-ML):
  • Regla P-ML: [$ M\ [\ \lambda(x_1,...,x_n).e\ ]=\lambda(x,x_1,...,x_n).T[\ e\mid x\ ] $]  
  • Regla A-ML: [$ M\ [\ \lambda(x_1,...,x_n).e\ ]=\lambda(x,x_1,...,x_n).T[\ e\mid \bar\lambda x_0.x x_0\ ] $]  
El truco está en que [$\bar\lambda x_0.x x_0$] convierte el código [$x$] en una función que toma código [$x_0$] y devuelve código [$x x_0$]. Como [$x$] va a ser la continuación, el efecto es pasarle [$x_0$] a la continuación. Justo lo que teníamos antes pero, esta vez, el [$\bar\lambda$] significa que estoy trabajando con funciones sobre código y no sobre código. Podré usar la regla beta para simplificarlas. Lo que buscábamos a la hora de etiquetar.

También hay que trastear la regla A-TS porque [$k$] no es código.
  • Regla P-TS: [$ T\ [\ e_0(e_1,...,e_n) \mid k\ ]= $][$ T[\ e_0 \mid \lambda x_0.T[\ e_1 \mid \lambda x_1.\ ...T[\ e_n \mid \lambda x_n. x_0(k, x_1,...,x_n)\ ]\ ...\ ]\ ] $] 
  •  Regla A-TS antigua (etiqueto lambdas): [$ T\ [\ e_0(e_1,...,e_n) \mid k\ ]= $][$ T[\ e_0 \mid \bar\lambda x_0.T[\ e_1 \mid \bar\lambda x_1.\ ...T[\ e_n \mid \bar \lambda x_n. x_0(k, x_1,...,x_n)\ ]\ ...\ ]\ ] $] 
  • Regla A-TS nueva (arreglo [$k$]): [$ T\ [\ e_0(e_1,...,e_n) \mid k\ ]= $][$ T[\ e_0 \mid \bar\lambda x_0.T[\ e_1 \mid \bar\lambda x_1.\ ...T[\ e_n \mid \bar \lambda x_n. x_0(\lambda x.k x, x_1,...,x_n)\ ]\ ...\ ]\ ] $]
El truco de [$\lambda x.kx$] es que [$k$] es una función de código que tomará el código [$x$] y generará otro código que permanece dentro del cuerpo de [$\lambda x$]. El resultado es, por tanto, código. Para dejar claro qué variables son de código y qué variables son funciones sobre el código, también etiquetaremos estas últimas que incluirán ahora todas las continuaciones también.

Entonces, las reglas de transformación de alto nivel definitivas son las siguientes:

  • Regla A-MX:  [$ M\ [\ x\ ]=x $]
  • Regla A-ML: [$ M\ [\ \lambda(x_1,...,x_n).e\ ]=\lambda(x,x_1,...,x_n).T[\ e\mid   \bar\lambda x_0.x x_0  \ ] $]
  • Regla A-TV: [$ T\ [\ v\mid \bar k\ ]= k(M[\ v\ ])$]
  • Regla A-TS: [$ T\ [\ e_0(e_1,...,e_n) \mid \bar k\ ]=$][$T[\ e_0 \mid \bar\lambda x_0.T[\ e_1 \mid \bar\lambda x_1.\ ...T[\ e_n \mid \bar\lambda x_n. x_0(\lambda x.\bar k x, x_1,...,x_n)\ ]\ ...\ ]\ ] $]
  •  Regla beta: [$ (\bar\lambda (x_1,...x_n). e) (v_1,...,v_n) = [x_1 \rightarrow v_1,...,  x_n \rightarrow v_n  ]e $]
Mejoran mucho el resultado de la transformación a CPS. El único inconveniente es que debemos trabajar con funciones sobre código (de alto nivel). Así que, si [$k$] sin etiquetar es código, no puedo escribir
[$$ T[\ f(a)\mid k\ ]$$]
Tengo que escribir
[$$ T[\ f(a)\mid \bar\lambda x.k x\ ]$$]
y el resultado de esto no es todo lo perfecto que quisiéramos:
[$$ f( \lambda x.k x, a) $$]
Se me ocurre otra idea... ¿Y no podemos mezclar las reglas de Plotkin y de Appel para usar código o funciones sobre código cuando queramos?

La tranformación CPS híbrida

Separemos entonces [$T\ [\ ]$] en dos: una sin etiqueta y otra con etiqueta [$\bar T\ [\ ]$]. La versión sin etiqueta requiere que la continuación sea código [$T\ [\ e\mid k\ ]$] y la etiquetada requiere que sea una función sobre código [$\bar T\ [\ e\mid \bar k\ ]$]. La mezcla es sencilla. 
  • Regla H-MX:  [$ M\ [\ x\ ]=x $]
  • Regla H-ML: [$ M\ [\ \lambda(x_1,...,x_n).e\ ]=\lambda(x,x_1,...,x_n).T[\ e\mid x \ ] $]
  • Regla H-TV: [$ T\ [\ v\mid k\ ]= k(M[\ v\ ])$]
  • Regla H-TS: [$ T\ [\ e_0(e_1,...,e_n) \mid k\ ]=$][$\bar T[\ e_0 \mid \bar\lambda x_0. \bar T[\ e_1 \mid \bar\lambda x_1.\ ... \bar T[\ e_n \mid \bar\lambda x_n. x_0(k, x_1,...,x_n)\ ]\ ...\ ]\ ] $]  
  • Regla H-FV: [$ \bar T\ [\ v\mid \bar k\ ]= \bar k(M[\ v\ ])$]
  • Regla H-FS: [$ \bar T\ [\ e_0(e_1,...,e_n) \mid \bar k\ ]=$] [$\bar T[\ e_0 \mid \bar\lambda x_0. \bar T[\ e_1 \mid \bar\lambda x_1.\ ... \bar T[\ e_n \mid \bar\lambda x_n. x_0(\lambda x.\bar k x, x_1,...,x_n)\ ]\ ...\ ]\ ] $]
  • Regla beta: [$ (\bar\lambda (x_1,...x_n). e) (v_1,...,v_n) = [x_1 \rightarrow v_1,...,  x_n \rightarrow v_n  ]e $]


Con estas reglas sí que conseguimos el objetivo deseado.
[$$ T\ [\ f(a)\mid k\ ]\ = f(k,a)$$]
[$$ T\ [\ f(g(a))\mid k\ ]\ = g(\lambda x.f(k,x), a) $$]
El único problemilla que tenemos es que trabajamos como en dos fases. En la primera fase quitamos las [$T$] (y [$\bar T$]) de en medio y en la segunda fase quitamos las [$\bar \lambda$] con la regla beta. Es posible hacerlo todo a la vez, pero aumenta lo suficiente la complejidad como para no explicarlo aquí (se basa en separar las [$e$] en [$v$] y en [$s$] y tratar cada caso con una regla distinta, específica).

Transformación CPS para lenguajes reales

Para finalizar vamos a apuntar brevemente cómo son las reglas de transformación CPS para un lenguaje de programación real, con asignación, selección, secuencia y demás primitivas.
  • AsignaciónT: [$ T\ [\ \mathrm{set}\ x\ e \mid k\ ]=\bar T[ e \mid \bar\lambda x_0. k (  \mathrm{set}\   x\ e)\ ] $]
  • AsignaciónF: [$ \bar T\ [\ \mathrm{set}\  x\ e \mid \bar k\ ]=\bar T[ e \mid \bar\lambda x_0. \bar k (  \mathrm{set}\   x\ e)\ ] $]
  • SelecciónT: [$ T\ [\ \mathrm{if}\ e_1\ e_2\ e_3 \mid k\ ]=\bar T[\ e_1 \mid \bar\lambda x_1. (  \mathrm{if}\ x_1\ T[\ e_2 \mid k\ ]\ T[\ e_3 \mid k\ ]\ ] $]
  • SelecciónF: [$ \bar T\ [\   \mathrm{if}\ e_1\ e_2\ e_3 \mid \bar k\ ]=\bar T[\ e_1 \mid \bar\lambda x_1. (  \mathrm{if}\ x_1\ \bar T[\ e_2 \mid \bar k\ ]\ \bar T[\ e_3 \mid \bar k\ ]\ ] $]
  • SecuenciaT: [$ T\ [\ e_1 ; e_2 \mid k \ ]= \bar T[\ e_1 \mid \bar\lambda x.T[\ e_2 \mid k\ ]\ ] $]
  • SecuenciaF: [$ \bar T\ [\ e_1 ; e_2 \mid \bar k \ ]= \bar T[\ e_1 \mid \bar\lambda x. \bar T[\ e_2 \mid \bar k\ ]\ ] $]
La selección duplica el código que hay en la continuación porque lo usa en dos sitios. Esto puede dar lugar a un código final más grande de lo deseable. La solución es postergar a tiempo de ejecución el paso de la continuación de la siguiente forma:
  • SelecciónT2: [$ T\ [\ \mathrm{if}\ e_1\ e_2\ e_3 \mid k\ ]=(\lambda x. \bar T[\ e_1 \mid \bar\lambda x_1. (  \mathrm{if}\ x_1\ T[\ e_2 \mid k\ ]\ T[\ e_3 \mid x\ ]\ ])(k) $]   
  • SelecciónF2: [$ \bar T\ [\   \mathrm{if}\ e_1\ e_2\ e_3 \mid \bar k\ ]=(\lambda x. \bar T[\ e_1 \mid \bar\lambda x_1. (  \mathrm{if}\ x_1\ \bar T[\ e_2 \mid \bar x\ ]\ \bar T[\ e_3 \mid \bar k\ ]\ ])(\lambda x_0.\bar k x_0) $]  
La clásica función call/cc se implementa así.
  • CallCCT: [$ T\ [\ \mathrm{calcc}\ | k\ ] = k (\lambda(x_0,x_1).x_1(x_0,\lambda(x_2,x_3).x_0(x_3))) $]
  • CallCCF: [$ \bar T\ [\ \mathrm{calcc} \ | \bar k\ ] =  \bar k (\lambda(x_0,x_1).x_1(x_0,\lambda(x_2,x_3).x_0(x_3))) $]
Los let se pueden implementar como lambdas aplicados inmediatamente, pero los letrec, no. Asumimos que los letrec sólo pueden vincular valores. Entonces:
  • LetRecT: [$ T\ [\ \mathrm{letrec}\ x_1=v_1,...,x_n=v_n\ \mathrm{in}\ e \mid k\ ]=$][$\mathrm{letrec}\ x_1=M[\ v_1\ ],...,x_n=M[\ v_n\ ]\ \mathrm{in}\ T[\ e \mid k\ ] $]
  • LetRecF: [$ \bar T\ [\ \mathrm{letrec}\ x_1=v_1,...,x_n=v_n\ \mathrm{in}\ e \mid \bar k\ ]=$][$\mathrm{letrec}\ x_1=M[\ v_1\ ],...,x_n=M[\ v_n\ ]\ \mathrm{in}\ \bar T[\ e \mid \bar k\ ] $]
Referencias

Matt Might - How to compile with continuations
Mark Feeley - The 90 minute Scheme to C compiler 

miércoles, 27 de abril de 2011

Modelos de memoria compartida

Orden de programa

Un programa se compone de instrucciones.

1 x=A //Lee el valor de A
2 B=2 //Escribe un valor en B
3 y=B //Lee el valor de B

Usaré las letras mayúsculas (A,B,C) para las localizaciones de memoria y las minúsculas (a,b,c) para registros o valores que no estén en memoria. Como nos interesa el modelo de memoria, ignoraremos las operaciones que no trabajen con memoria. Para mayor facilidad usaremos números para cada instrucción.

Cuando se ejecuta un programa las instrucciones que se van ejecutando conforman una secuencia que se denomina traza. Se llama orden de programa a la relación de orden estricto que encadena las instrucciones según se ejecutan en una traza. Si escribimos esta relación como [$ \rightarrow_p $] entonces, el programa de arriba tiene la siguiente traza

[$$ 1 \rightarrow_p 2 \rightarrow_p 3 $$]

Nada extraño. Esta relación es un orden estricto y, en principio, total.


Modelo secuencialmente consistente (SC)

Cuando tenemos varios procesadores, cada uno de ellos ejecutando una hebra distinta, ¿cómo se reparten las instrucciones? ¿Y qué instrucciones se ejecutan antes que otras? Un modelo de memoria compartida responde a estas preguntas.

El modelo más simple es el secuencialmente consistente (SC) de Lamport. En este modelo las instrucciones de todos los procesadores se intercalan y el orden resultante de las mismas ha de ser un orden total que llamaremos de ocurrencia [$ \rightarrow_o $].

Si no pusiéramos más condiciones, este orden podría ser cualquiera, incluso sin respetar el orden de programa.

Por ejemplo, este programa con dos hebras

INICIALMENTE: A=B=0
HEBRA 1   HEBRA 2
1 x=A     11 y=B
2 B=1     12 A=1


Tiene el siguiente orden de programa

[$$ 1 \rightarrow_p 2 $$]
[$$ 11 \rightarrow_p 12 $$]

Sin condiciones adicionales, el orden de ocurrencia podría ser, por ejemplo

[$$ 2 \rightarrow_o 12 \rightarrow_o 1 \rightarrow_o 11 $$]

Nota: Tanto el orden [$ \rightarrow_p $] como el orden [$ \rightarrow_o $] son transitivos por lo que con el ejemplo de arriba también tendríamos [$ 2 \rightarrow_o 1, 2 \rightarrow_o 11, 12 \rightarrow_o 11 $]. Es usual no listar estas relaciones que se pueden derivar fácilmente de la primera.

Este orden daría como resultado x=y=1 lo cual es bastante contraintuitivo. El modelo SC tiene la siguiente restricción: si [$N$] y [$M$] son dos instrucciones y [$ N \rightarrow_p M $] entonces debe darse que [$ N \rightarrow_o M $]. Esta condición se expresa de la siguiente manera.

[$$ \frac{N \rightarrow_p M}{N \rightarrow_o M} $$]

Esto quiere decir que si en una hebra se ejecuta una instrucción antes que otra por el orden de programa (por ejemplo, la 11 antes de la 12) entonces ese mismo orden aparece en el orden de ocurrencia. Como en el ejemplo anterior teníamos que 12 ocurría antes que 11, excluimos este posible orden del modelo SC.

[$ 2 \rightarrow_o 12 \rightarrow_o 1 \rightarrow_o 11$] no es SC porque [$2 \rightarrow_o 1$] pero [$1 \rightarrow_p 2$]
[$ 11 \rightarrow_o 1 \rightarrow_o 2 \rightarrow_o 12 $] sí es SC y el resultado es un intuitivo x=y=0
[$ 1 \rightarrow_o 2 \rightarrow_o 11 \rightarrow_o 12 $] sí es SC y el resultado es otro intuitivo x=0, y=1

El dibujo típico del modelo secuencialmente consistente es una memoria compartida asignada únicamente a un procesador en cada momento.


Optimizaciones en compiladores y procesadores

Desafortunadamente las cosas no son tan sencillas. Generalmente el orden de programa es excesivamente restrictivo para realizar optimizaciones. Una optimización típica es la siguiente.

1 A=5
2 x=A
3 B=1

En el anterior programa, la instrucción 2 ha de esperar a que la instrucción 1 escriba el valor 5 en A. Un compilador o un procesador astuto reordena el programa de la siguiente forma.

11 A=5
12 B=1
13 x=A

En este programa transformado, la instrucción 12 se ejecuta mientras la instrucción 11 se está terminando. Esto evita que tengamos que esperar en la instrucción 13 tanto como hacíamos en la instrucción 2.

El problema es que el programador ha escrito las instrucciones 1,2,3 y no las 11,12,13. ¿Qué pasa si ejecutamos esto con otra hebra?

HEBRA 1   HEBRA 2
1 A=5     21 if(B=1)
2 x=A     22   A=7
3 B=1

Pensando en SC de ninguna manera podría ocurrir que x=7 ya que para cuando B=1, x ya tiene el valor 5 y por mucho que modifiquemos A=7, x ya no va a cambiar. Esto no es así si el procesador o el compilador reordena el programa de la hebra 1 sin que lo sepamos.

HEBRA 1   HEBRA 2
11 A=5    21 if(B=1)
12 B=1    22   A=7
13 x=A

Aunque el programador ha escrito 1,2,3, el compilador o el procesador lo reordena a 11,12,13 para optimizar la espera de la instrucción 2 tras la 1. Ahora bien, ¡esto ahora permite que x=7! El orden de ocurrencia para este bug sería

[$$ 11 \rightarrow_o 12 \rightarrow_o 21 \rightarrow_o 22 \rightarrow_o 13 $$]

Si el pobre programador intenta razonar sobre el orden del programa original 1,2,3 lo que vería sería

[$$ 1 \rightarrow_o 3 \rightarrow_o 21 \rightarrow_o 22 \rightarrow_o 2 $$]

que no es SC porque la instrucción 3 se ejecuta antes que la 2.

Relajando el modelo SC

Por esta razón el modelo SC no es útil: no permite al compilador o al procesador optimizar los programas sin dejar al programador con un difícil bug a resolver. La solución es exponer al programador un modelo más débil que se denomina un modelo relajado.

¿Cómo vamos a relajar ese modelo? Hay varias formas.

La primera es permitir reordenar las instrucciones de un programa y proporcionar al programador herramientas para decirle al compilador y al procesador cuándo no se pueden reordenar. Una de estas herramientas es una instrucción llamada barrera de memoria (memory fence) y lo único que significa es que es una barrera que las instrucciones no se la pueden saltar al ser reordenadas.

Con una barrera, el programa anterior quedaría así

HEBRA 1   HEBRA 2
1 A=5     21 if(B=1)
2 x=A     22 A=7
3 FENCE
4 B=1


Y ni el compilador ni el procesador podrían reordenar la instrucción 4 sobre la 3 o la 1 o la 2 bajo la 3. De esta manera, el programador se asegura de que leemos A antes de modificar B. Por otra parte, el compilador o el procesador son libres de realizar otras optimizaciones en otros sitios.

¿Pero en qué sitios? ¿Podría reordenar la instrucción 2 sobre la 1? Realmente no, porque necesitamos conocer A en la instrucción 2 y eso depende de la instrucción 1. A esta relación se la llama una dependencia y la escribiremos [$\rightarrow_d$]. Básicamente indica que un valor no se puede usar antes de que haya sido calculado. En un modelo de memoria relajado al menos se debe conservar la dependencia. Es decir,

[$$\frac{N \rightarrow_d M}{N \rightarrow_o M}$$]

Además, las barreras de memorias ordenan lo que ocurre antes y después de ellas.

[$$\frac{N \rightarrow_p M,  N\ es\ FENCE}{N \rightarrow_o M},\ \ \frac{N \rightarrow_p M,  M\ es\ FENCE}{N \rightarrow_o M}$$]

Entonces, en el programa anterior teníamos.

[$$1\rightarrow_p 2\rightarrow_p 3\rightarrow_p 4,11\rightarrow_p 12$$]
[$$1\rightarrow_d 2,11\rightarrow_d 12$$]
[$$3\ es\ FENCE$$]

Por la dependencia debe cumplirse que

[$$1\rightarrow_o 2,11\rightarrow_o 12$$]

y por barrera debe cumplirse que

[$$1\rightarrow_o 3,2\rightarrow_o 3,3\rightarrow_o 4$$]

Entonces, está claro que

[$1\rightarrow_o 11\rightarrow_o 2\rightarrow_o 12\rightarrow_o 3\rightarrow_o 4$] sí cumple con el modelo relajado
[$1\rightarrow_o 11\rightarrow_o 2\rightarrow_o 12\rightarrow_o 4\rightarrow_o 3$] no cumple con el modelo relajado porque [$4\rightarrow_o 3$]

Nota: La instrucción 12 no se ejecuta, pero de ejecutarse lo haría en la posición arriba puesta.
Nota: Sabemos que si [$4\rightarrow_o 3$] entonces no se da [$3\rightarrow_o 4$] porque estamos tratando con órdenes.


Otras barreras, otros modelos, otras instrucciones

Algunos compiladores y procesadores se restringen a reordenar instrucciones que son de cierto tipo. Los más usuales son
  • Reordena una escritura seguida de otra escritura (WW)
  • Reordena una lectura seguida de una escritura (RW)
  • Reordena una escritura seguida de una lectura (WR)
  • Reordena una lectura seguida de otra lectura (RR) 
Eso permite además tener barreras de memoria selectivas que
  • Impida reordenar escrituras anteriores a la barrera con escrituras posteriores (WW)
  • Impida reordenar lecturas anteriores a la barrera con escrituras posteriores (RW)
  • Impida reordenar escrituras anteriores a la barrera con lecturas posteriores (WR)
  • Impida reordenar lecturas anteriores a la barrera con lecturas posteriores (RR) 
Esto lleva permitirle al compilador y al procesador más optimizaciones. Existen más métodos de restringir la reordenación como instrucciones atómicas, sincronizaciones, bloqueos, etc. Eso sí, empieza a crearnos un zoológico de modelos de memoria que, sin embargo, se dan en la vida real. Por ejemplo,

Procesador o 
Modelo de memoria  Relaja WR  Relaja WW  Relaja RW  Relaja RR
SC
IBM 360            Sí
TSO                Sí
PC                 Sí
PSO                Sí         Sí
WO                 Sí         Sí         Sí         Sí
RCsc               Sí         Sí         Sí         Sí
RCpc               Sí         Sí         Sí         Sí
Alpha              Sí         Sí         Sí         Sí
RMO                Sí         Sí         Sí         Sí
PowerPC            Sí         Sí         Sí         Sí


Para más información http://citeseerx.ist.psu.edu/viewdoc/summary?doi=10.1.1.106.5742&rank=1

miércoles, 16 de marzo de 2011

Mónadas en un plis-plás

Como no hay blog de informática teórica que se precie sin un tutorial de mónadas, y aprovechando que Milewski está dedicándole unos posts a esto, voy a explicar cómo entendí lo de las mónadas (si es que lo entendí, claro).


De los efectos secundarios y de cómo evitarlos

Supongamos esta función.

int f(int x)
{
  a=x+2;
  return x*3;
}

Realmente, está haciendo dos cosas: retornar el triple y asignar el argumento más dos a una variable externa “a”. Esta segunda acción es lo que se llama un efecto secundario porque modifica el estado global del programa. En este caso, el valor de “a”.


Muchas veces no es conveniente tener efectos secundarios: se simplifica la concurrencia, se permite la transparencia referencial, se permiten más optimizaciones, facilita la comprensión del programa, etc. Si queremos evitar que la función “f” tenga efectos secundarios la única solución es forzar a que éstos sean devueltos también por el retorno. Llamaremos a esta nueva función “F” para distinguirla de la original “f” con efectos secundarios.


El problema ahora es que tenemos que devolver dos tipos. Además, no hemos dicho nada de que la función “f” pueda hacer más de una asignación. Tampoco hemos hablado de cómo cambia este nuevo retorno el estado global. Lo mejor es abstraernos de todos estos detalles y decir que “F” devuelve asignaciones y un entero. Inventaremos el tipo “A<int>” para eso usando un constructor de tipos "A".


Así que “F” vuelve a ser una función normal y corriente con un tipo a devolver exótico que engloba tanto el retorno normal (el entero) como los efectos secundarios (las asignaciones).

¡Pero hemos perdido una operación fundamental en la programación! ¿Cómo hacemos composiciones? ¿Cómo hacemos cosas como “f(f(5))”? Ahora que los tipos no coinciden, ¡no es posible escribir “F(F(5))”!


La solución pasa por hacer explícita la aplicación. ¿Pero qué es una aplicación explícita?


De la aplicación explícita y las restricciones que la composición le impone

En esta sección sólo hablaremos de cosas conocidas: funciones puras sin efectos secundarios. Llamaremos “g” y “h” a estas funciones puras. Nos olvidaremos por ahora del tipo “A<int>” y de las funciones “f” y “F” con efectos secundarios.

La aplicación explícita es sencillamente escribir “apply(x, g)” en vez de escribir “g(x)”.


Es únicamente un cambio en la notación, pero nos permite estudiar las propiedades de “apply” y realizar cosas tan potentes como la defuncionalización (de la que no hablaremos aquí). En concreto, para que “apply” sea coherente con la composición, debe mantener sus dos propiedades: elemento neutro y asociativa.

Para el elemento neutro hemos de introducir una función identidad. La llamaremos “id” y devuelve su argumento sin hacer nada de nada.

int id(int v) {return v;} //Función identidad de los enteros

Obviamente, componer esta función no debe hacer nada.

apply(x, id) == x
apply(id(x), g) == g(x)

Para la asociativa introduciremos una función compuesta “h” que aplique consecutivamente dos funciones “g1” y “g2”. En notación matemática escribiríamos [$h=g_2 \circ g_1$].

int h(int v) { return apply(g1(v), g2); }

Entonces, aplicar esta función compuesta “h” es igual que aplicar consecutivamente “g1” y “g2”.

apply(v, h) == apply(apply(v, g1), g2)

Con esto estamos seguros de que “apply” se comporta correctamente para la composición y podemos volver a pensar cómo solucionar el problema de la composición de la función “F”.

Nota: La propiedad asociativa aquí expuesta no parece ser la propiedad asociativa de toda la vida, pero si usamos “@” como operador infijo para el “apply” y la composición, entonces la propiedad queda algo así como “v@(g1@g2) = (v@g1)@g2” lo cual sí que se parece ya a la propiedad asociativa usual.

De la mezcla de efectos secundarios con aplicaciones explícitas

Lo interesante de hacer explícita la aplicación es que podemos adaptar el tipo de la misma a nuestros requisitos. Llamaremos “bind” a la aplicación con el tipo “A<int>” sobre funciones de tipo “int -> A<int>”, para no confundirla con “apply” que funciona sobre “int” y funciones “int -> int” únicamente.

apply: int -> (int->int) -> int
bind: A<int> -> (int -> A<int> ) -> A<int>


El truco está en que “bind(xx, F)” toma los efectos secundarios de “xx” y los mezcla con los efectos secundarios del resultado de “F” para luego devolverlos en su resultado.


Pero queda el asunto de la composición que nos forzó a introducir el “bind”: debe cumplir exactamente las mismas propiedades que “apply”.

La única salvedad es que “id” no debe ser la función identidad de los enteros. Tenemos que mantener el tipo “int -> A<int>” en las funciones. Así que se ha de convertir en una función que toma un entero y devuelve un “A<int>” de la manera más neutra posible. Es decir, sin efectos secundarios. También vamos a cambiar el nombre de esta función para no confundirla con la “id” original y la vamos a llamar “unit”.


Pues bien. Estas tres cosas son una mónada:
  • Un constructor de tipo como “A” que dado un tipo de retorno como “int” devuelve un tipo “A<int>” que engloba tanto ese tipo de retorno como los efectos secundarios.
  • Un par de funciones “bind” y “unit” que tienen los tipos antes mencionados.
  • Que se cumplan las propiedades de elemento neutro y asociativa.
Nota: El lector con conocimientos de álgebra habrá pensado “¿Elemento neutro y asociativa? ¿No era esto lo que definía un monoide? ¿Tiene que ver con el nombre de mónada?”. La respuesta es sí. Un monoide es lo que se forma con “int->int” donde el tipo de entrada es igual al tipo de salida. Una mónada es la generalización donde los tipos no son siempre iguales.

De los lugares en los que habitan las mónadas

La parquedad de los requisitos de las mónadas hace que aparezcan por todos los lados y no únicamente como modelo de efectos secundarios. Son en general un modelo de computación (ver ejemplo 1.1 en el articulo original de Moggi para una lista de cosas que puede modelar una mónada).

Por ejemplo, los punteros con NULL se usan generalmente como mónadas. El constructor de tipo está claro que es el de los punteros. De “int” pasamos a “int*”. La función “unit” es simplemente obtener la dirección de un entero.

int a;
int* p=&a; // p=unit(a)

La función “bind” consiste en comprobar que el puntero no es NULL.

return p==NULL ? NULL : p->OperaYDevuelvePuntero() ;
// return bind(p, OperaYDevuelvePuntero);

Es fácil comprobar las propiedades correspondientes con estas operaciones, pero aún hay más. Cualquier colección iterable es una mónada. Sí, así a lo bestia: vectores, conjuntos, listas, mapas, tablas hash, etc. Todos son mónadas. El constructor de tipo es el de la colección que queramos. Por ejemplo, “vector<int>”.

La función “unit” es bien sencilla: la colección con un único elemento.

vector<int> v;
v.push_back(3);
// v=unit(3)

La función “bind” es equivalente a iterar y mezclar.

vector<int> r;
foreach (x in v) r.append(Procesa(x));
// r=bind(v, Procesa)

Ojo que “Procesa” devuelve un vector y “append” mezcla vectores. Si “Procesa” fuera obtener la lista de divisores, entonces

bind([1, 6, 21], Procesa) = [1, 1, 2, 3, 6, 1, 3, 7, 21]

Esta propiedad del “bind” de separar, iterar y combinar es la que le da tanta utilidad. De hecho, debido a esto, “Procesa” también serviría para filtrar, transformar, unir y casi cualquier otra operación que se quiera realizar con la colección. Lo que no quita para que también la colección tenga sus operaciones propias no monádicas.


Pero con todo esto habría ya material para otra entrega en la que tendríamos que hablar de comprensiones monádicas, la notación “do” y empezar a usar muchas funciones anónimas.