Mostrando entradas con la etiqueta miniSL. Mostrar todas las entradas

sábado, 11 de julio de 2015

miniSL parte 27 - Funciones nativas sobre enteros (II)

En la última entrada mencionamos que la división debía realizarse de otra forma ya que no debemos permitir una división por cero. La misma restricción aparece en la operación resto.

Realmente tenemos que cambiar poco en comparación con la macro NATIVE_INTEGER_BINARY. Un if antes de la división que lance una excepción si intentamos dividir por cero y otro if que impida dividir sin argumentos. Esto es así porque la división no tiene un elemento neutro.
#define NATIVE_INTEGER_BINARY_DIVISION(name, op) \
CELL& Native_##name(Script& script, CELL& args, CELL& envir) \
{ CELL* a=&script.Evaluate(args, envir); \
 int r=0; \
 if(a->type!=CONS_CTOR) throw L"Division arity must not be zero"; \
 r=a->head->GetInteger(); \
 for(a=a->tail; a->type==CONS_CTOR; a=a->tail) \
 { int d=a->head->GetInteger(); \
  if(d==0) throw L"Division by zero"; \
  r=r op d; \
 } \
 return script.CreateInteger(r); \
}
Esto que hemos hecho hasta ahora es una macro. Con esta macro, generamos las funciones para la división y para el resto.
NATIVE_INTEGER_BINARY_DIVISION(Div, /)
NATIVE_INTEGER_BINARY_DIVISION(Mod, %)
En el siguiente post, veremos los operadores relacionales. Estos operadores son distintos a los aritméticos ya que siempre devuelven un booleano. Por eso requieren un tratamiento especial.

jueves, 30 de abril de 2015

miniSL parte 26 - Funciones Nativas sobre Enteros (I)

En esta entrada del lenguaje MiniSL vamos a empezar a definir las funciones predefinidas. Empezaremos por las operaciones básicas para enteros.

Todas las funciones predefinidas se almacenan en celdas NATIVE_VAL. Estas celdas almacenan un puntero a la función que vamos a definir. Al evaluarlas se ejecuta el siguiente código en la función Evaluate()

case NATIVE_VAL: return aux->native(*this, *c.operands, envir);

El primer argumento de una función nativa es el propio objeto Script. Usamos este objeto para crear nuevas celdas en el montículo o evaluar subexpresiones. El segundo argumento es la celda con la lista de operandos. Es importante aquí distinguir entre un operando y un argumento. Un operando es una expresión que todavía no se ha evaluado, mientras que un argumento es el valor obtenido de evaluar esa expresión en el entorno dinámico. Finalmente, ese entorno dinámico es el que se pasa en el tercer argumento.

Supongamos que queremos sumar dos números. Lo que tendríamos que hacer para hacer eso es evaluar los operandos para obtener los argumentos (recordemos que la evaluación de una lista es la lista de los resultados de la evaluación, ver en la parte 14 el caso  CONS_CTOR), sumarlos y crear una nueva celda con el resultado. Lo más tedioso es comprobar que los argumentos existen y navegar por la lista para obtenerlos. Sería algo como esta función:

CELL& Native_Add2(Script& script, CELL& args, CELL& envir)
{ 
 CELL* a=&script.Evaluate(args, envir);
 if(a->type==CONS_CTOR) 
 {
  int l=a->head->GetInteger();
  a=a->tail;
  if(a->type==CONS_CTOR)
   return script.CreateInteger(l + a->head->GetInteger()); 
 } 
 throw L"Argument missing";
}

Realmente, podemos definir las operaciones básicas para cero, uno o múltiples argumentos. Bastaría usar un bucle. Tomamos como resultado de sumar ningún argumento el elemento neutro de la suma que es el cero.

CELL& Native_AddN(Script& script, CELL& args, CELL& envir) 
{
 CELL* a=&script.Evaluate(args, envir); 
 int r=0;
 if(a->type==CONS_CTOR) 
 {
  r=a->head->GetInteger(); 
  for(a=a->tail; a->type==CONS_CTOR; a=a->tail)
   r=r + a->head->GetInteger();
 }
 return script.CreateInteger(r);
}

Y fácilmente podemos hacer una macro que cambie el + por lo que sea y el 0 por lo que sea. El único truco es usar el operador de concatenación de tokens ## para generar cada vez un nombre distinto.

#define NATIVE_INTEGER_BINARY(name, emptyval, op) \
CELL& Native_##name(Script& script, CELL& args, CELL& envir) \
{ CELL* a=&script.Evaluate(args, envir); \
 int r=emptyval; \
 if(a->type==CONS_CTOR) \
 { r=a->head->GetInteger(); \
  for(a=a->tail; a->type==CONS_CTOR; a=a->tail) \
   r=r op a->head->GetInteger(); \
 } \
 return script.CreateInteger(r); \
}

Y usamos esta macro para definir la suma, resta, multiplicación, and bit a bit, or bit a bit y xor bit a bit.

NATIVE_INTEGER_BINARY(Add, 0, +)
NATIVE_INTEGER_BINARY(Sub, 0, -)
NATIVE_INTEGER_BINARY(Mul, 1, *)
NATIVE_INTEGER_BINARY(BAnd, -1, &)
NATIVE_INTEGER_BINARY(BOr, 0, |)
NATIVE_INTEGER_BINARY(BXor, 0, ^)

No hemos definido ni la división ni el módulo ya que requieren la comprobación de que el denominador se distinto a cero. Lo dejamos para la siguiente entrada de esta serie.

lunes, 30 de marzo de 2015

miniSL parte 25 - Lectura de listas


Bienvenidos de nuevo a la serie de artículos sobre la implementación de MiniSL, un pequeño lenguaje de programación. Esta vez vamos a analizar la función que lee la sintaxis de las listas. Una lista no es más que una serie de expresiones separadas por un separador y que finaliza con un finalizador. Generalmente el separador será una coma o un punto y coma, mientras que el finalizador será un paréntesis que se cierra.

CELL& Script::ReadList(ISTREAM& i, ISTREAM::int_type separator, ISTREAM::int_type finalizer)
{

Para crear la lista necesitamos construirla de derecha a izquierda con las celdas de tipo CONS_CTOR que no son más que pares. Así, la lista (1,2,3,4) se almacena como (1, (2, (3, (4, EMPTY_LIT)))). Como leemos la lista de izquierda a derecha, hemos de guardarlas en una pila. Usaremos la variable seq para ese fin.

 std::vector<CELL*> seq;

Continuamos leyendo mientras no nos encontremos con el finalizador o el fin del fichero. Es importante ver aquí que podemos encontrarnos con una lista vacía y no entrar en el bucle. Eso deja la pila vacía.

 TOKEN t;
 while((t=PeekToken(i)).type!=T_RAW || (t.raw!=finalizer && t.raw!=ISTREAM::traits_type::eof()) )
 {

Siempre leemos una expresión y la guardamos en nuestra pila.

  seq.push_back(&ReadExpression(i));

Tras la expresión comprobamos que o bien viene un separador o un finalizador. Cualquier otra cosa es un error. Nos saltamos el separador y continuamos el bucle.

  t=PeekToken(i);
  if( t.type==T_RAW && t.raw==separator )
   ReadToken(i);
  else if( t.type!=T_RAW || t.raw!=finalizer )
   throw L"Expecting a separator or a finalizer after expression";
 }

Una vez leída la lista, lanzamos un error si nos detuvimos porque encontramos un EOF.

 if(t.type==T_RAW && t.raw==ISTREAM::traits_type::eof())
  throw L"Expecting finalizer but found EOF";

Consumimos el finalizador que nos ha detenido.

 ReadToken(i); //Skip finalizer

Ahora vamos a ir sacando las celdas de la pila para construir la lista mediante pares. La lista vacía es EMPTY_LIT.

 CELL* s=&CreateCell(EMPTY_LIT);

Mientras la pila tenga algo, lo vamos sacando y lo vamos incorporando a la lista. No hay otra forma de hacerlo que de derecha a izquierda, por eso usábamos la pila.

 while(!seq.empty())
 {
  s=&CreateCell(CONS_CTOR, seq.back(), s);
  seq.pop_back();
 }

Y ya está la lista. Incluso en el caso de que no hubiera ningún dato en la lista, la variable s apuntaría a EMPTY_LIT, la lista vacía, de forma correcta.

 return *s;
}

De esta manera hemos construido una lista usando celdas CONS_CTOR y EMPTY_LIT.
Con esta función hemos acabado el análisis sintáctico. A partir de ahora sólo nos queda introducir las funciones de nuestro lenguaje MiniSL para que podamos computar algo. Empezaremos en la siguiente entrega.

sábado, 13 de diciembre de 2014

miniSL parte 24 - Expresiones infijas

Seguimos estudiando el analizador sintáctico de miniSL. Hemos empezado con las expresiones de mayor precedencia. Primarias en la parte 22. Postfijas en la 23. Prefijas también en la 23. Ahora vamos a ver las infijas.

Si bien hasta ahora cada tipo de expresión tenía una única precedencia, con las infijas esto no es así. Una expresión infija puede tener una precedencia distinta a la de otra expresión infija. La precedencia de cada expresión infija viene dada por los operadores que la componen. De hecho, hemos visto ya el algoritmo para analizar las expresiones infijas en este blog. Es el algoritmo de playa de agujas.

En miniSL la función que implementa este algoritmo es ReadInfixExpression(). En esta versión del algoritmo usamos la recursividad. No es la versión más eficiente, pero sí es la más sencilla de entender. La idea es mantener siempre la precedencia de la expresión que estamos analizando. Si el siguiente operador es de menor precedencia, no lo analizamos y dejamos que sea la función que nos ha llamado la que se encargue. Obviamente, la primera llamada deberá ser con la precedencia más baja posible.

CELL& Script::ReadInfixExpression(ISTREAM& i, int precedence)
{

En la variable a vamos a mantener la expresión analizada hasta ahora que tendrá la precedencia dada en precedence o una mayor. Empezamos con una expresión prefija que es justo la de mayor precedencia tras las infijas, por lo que aseguramos esta condición.

CELL* a=&ReadPrefixExpression(i);

Ahora vemos que el siguiente token de la entrada sea un operador. Es decir, un T_SYMBOL. Si no es un operador, el análisis de la expresión no puede continuar y finalizamos. En este bucle continuaremos mientras vayamos encontrando operadores. También debemos tener en cuenta que si lo que nos encontramos no es un operador, no debemos consumir ese token ya que otra función podría necesitarlo para continuar el análisis léxico. Por eso usamos peek().

TOKEN t;
while((t=PeekToken(i)).type==T_SYMBOL)
{

En este punto sabemos que estamos tratando con un operador. Obtengamos qué operador es, qué precedencia tiene y qué asociatividad.

STRING const& s=*t.data->string_val;
int prec=SymbolPrecedenceAndAssoc(s);
bool right_assoc=(prec&1)!=0;

Ahora viene la decisión comentada anteriormente y núcleo del algoritmo. Si la precedencia del operador es menor que la de la expresión actual (precedencia que tenemos almacenada en el parámetro precedence), retornamos lo que hayamos analizado hasta ahora y la función que nos ha llamado deberá hacerse cargo de ese operador con una precedencia tan baja. En el caso de que el operador sea exactamente de la misma precedencia que la expresión que estoy analizando, deberemos decidir si lo aglutinamos en esta expresión (por lo que continuamos el algoritmo aquí) o en la expresión superior (por lo que retornamos a la función llamante). Esto depende de la asociatividad del operador como veremos algo más abajo.

if(right_assoc ? prec<precedence : prec<=precedence)
return *a;

Una vez que hemos decidido que debemos procesar este operador, lo consumimos de la entrada.

ReadToken(i);

A continuación leemos el resto de la expresión con precedencia mayor (o igual en el caso de asociatividad por la derecha) que el operador recién leído. Cuando se encuentre con una precedencia menor, volverá a esta función y seguiremos comparando con la precedencia de precedence.

CELL& b=ReadInfixExpression(i, prec);

Llegados a este punto, tenemos dos expresiones y un operador. Construimos las celdas correspondientes. La celda a se aglutina por la izquierda y la celda b por la derecha. El resultado se vuelve a almacenar en a. Esto significa que siempre asociamos por la izquierda en este bucle. Por esto mismo retornábamos en caso de precedencias iguales si queríamos asociar por la derecha.

CELL& operands=CreateCell(CONS_CTOR, a, &CreateCell(CONS_CTOR, &b, &CreateCell(EMPTY_LIT)));
a=&CreateCell(COMBINE_CODE, t.data, &operands );
}

Este retorno es la salida cuando encontramos un token que no es un operador y salíamos del bucle.

return *a;
}

Con esta función completada sólo nos falta implementar la función que lee listas. Esta función ReadList() ha aparecido ya varias veces usada en las expresiones primarias y postfijas. La describiremos en la siguiente parte de esta serie.

domingo, 15 de junio de 2014

miniSL Parte 23 - Expresiones postfijas y prefijas

Esta es otra parte de la serie dedicada al mini-lenguaje MiniSL. Tal como veníamos haciendo en las partes anteriores, vamos a seguir ascendiendo por las reglas de analizador descendente recursivo. La regla que usa las expresiones primarias es la de las expresiones postfijas. Esta regla está implementada por la función ReadPostfixExpression().

CELL& Script::ReadPostfixExpression(ISTREAM& i)
{

Siguiendo nuestra sintaxis, una expresión postfija es una expresión primaria.

 CELL* p=&ReadPrimaryExpression(i);

Seguida de ninguna, una o varias llamadas de función. Estas llamadas deben empezar forzosamente por el carácter “(”. No podemos consumirlo porque si no es una llamada a función, podría ser otra cosa importante como un operador infijo. Así que sólo ojeamos el siguiente token con PeekToken(). Este procedimiento de mirar por adelantado es muy usual en el reconocimiento sintáctico y se denomina lookahead (mira hacia delante). Se detalló el funcionamiento de PeekToken() en la parte 17 de esta serie.

 TOKEN t=PeekToken(i);
 while(t.type==T_RAW && t.raw=='(')
 {

Una vez que estamos seguros de que lo que tenemos es una llamada a función, la consumimos. Primero el paréntesis de apertura. Luego leemos la lista de argumentos en una celda especial de combinación (como se explicó en la parte sexta de esta serie). Finalmente, consumimos el paréntesis de cierre.

  t=ReadToken(i);
  p=&CreateCell(COMBINE_CODE, p, &ReadList(i, ',', ')'));
  t=PeekToken(i);
 }

 return *p;
}

Lo que generamos es un árbol en el cual cada nodo es una celda de combinación (COMBINE_CODE) que representa una llamada a función y en sus argumentos añadimos una lista. Veremos las listas en la sección 25, pero ya sabemos que las listas se construyen con celdas del tipo CONS_CTOR y EMPTY_LIT.


Para la función ReadPrefixExpression(), lo que haremos será lo siguiente.

CELL& Script::ReadPrefixExpression(ISTREAM& i)
{
 if(PeekToken(i).type==T_SYMBOL)
 {

Si encontramos un símbolo, lo consumimos y llamamos recursivamente a esta función para el argumento de la función prefija.
  TOKEN t=ReadToken(i);
  CELL& expr=ReadPrefixExpression(i);

El resultado lo guardamos como un único argumento (una única celda CONS_CTOR) en una llamada (celda COMBINE_CODE).

  return CreateCell(COMBINE_CODE, t.data, &CreateCell(CONS_CTOR, &expr, &CreateCell(EMPTY_LIT)));
 }

Si no empezábamos por un símbolo es que hemos llegado a la expresión postfija.

 return ReadPostfixExpression(i);
}

Estas funciones son simples y lo único que hacen es seguir la gramática. De hecho, estas funciones son la parte más representativa de lo que es un reconocedor sintáctico descendiente recursivo. En la siguiente parte veremos algo un poco distinto y usaremos el algoritmo de playa de agujas para leer expresiones infijas.

domingo, 2 de febrero de 2014

miniSL parte 22 - Expresiones primarias

En esta entrada de la serie dedicada al mini-lenguaje de programación MiniSL vamos a ver las expresiones primarias. Las expresiones primarias son las expresiones que no están formadas por otras expresiones o no hay ambigüedad en su análisis porque están parentizadas. En el caso de MiniSL eso incluye los siguientes casos:
  • Una expresión entre paréntesis.
  • Una lista entre corchetes. 
  • Un nombre.
  • Un literal (cadena o entero).
La función que lee una expresión primaria es ReadPrimaryExpression(). Lo primero que hace esta función es leer el siguiente token y, según sea su tipo, procede de una forma u otra.

CELL& Script::ReadPrimaryExpression(ISTREAM& i)
{
 TOKEN t=ReadToken(i);
 switch(t.type)
 {

Los tokens T_RAW consistían en un único carácter. Este carácter podrá ser o bien un paréntesis de apertura “(” o un corchete de apertura “[”. En el primer caso estamos en una expresión entre paréntesis y en el segundo caso una lista. Como vemos, no hay ambigüedad posible.

 case T_RAW:
  switch(t.raw)
  {

En el caso de expresión entre paréntesis, leemos la expresión. Comprobamos que el paréntesis se cierra usando ConsumeRawToken() que ya vimos en las funciones de ayuda. Finalmente, retornamos la celda leída en la expresión interna como la correspondiente a la parentización.

  case '(':
   {
    CELL& x=ReadExpression(i);
    ConsumeRawToken(i, ')', L"Expecting closing round bracket");
    return x;
   }

En el caso de una lista, usamos la función ReadList() indicando que la lista se separa por comas y termina en corchete “]”. Veremos la función ReadList() en la parte 25 de esta serie.

  case '[': return ReadList(i, ',', ']');
  default: throw L"Unexpected token";
  }

Tanto en el caso de nombres como de literales es muy fácil devolver la celda ya que el token la generaba y guardaba.

 case T_NAME: return *t.data;
 case T_LITERAL: return *t.data;
 default:  throw L"Expecting a primary expression";
 }
}

Como observamos, lo hecho no es más que una regla de un reconocedor descendente recursivo. En la siguiente parte de esta serie nos dedicaremos a las expresiones postfijas y prefijas.

sábado, 17 de agosto de 2013

miniSL parte 21 - Lectura de números

Como ya adelanté en la entrada anterior, hoy vamos a ver cómo leer números. La función responsable de esto es ReadNumber().

CELL& Script::ReadNumber(ISTREAM& i)
{

Lo primero es leer un número hasta donde podamos leer. Iremos metiendo lo leído en la cadena s.

 STRING s;
 while(unsigned(i.peek())<256 && isdigit(i.peek()) && i.good())
  s+=i.get();

Si hemos llegado hasta una “x” o “X”, probablemente sea un número hexadecimal. Comprobaremos que empiece por “0x” o “0X” y pasamos a incorporar los dígitos hexadecimales en la variable s.
 if(i.peek()=='x' || i.peek()=='X')
 {
  if(s.compare(L"0")!=0) throw L"Hexadecimal numbers must begin with 0x";

  s+=i.get();
  while(unsigned(i.peek())<256 && isxdigit(i.peek()) && i.good())
   s+=i.get();
 }

Ahora tenemos el número leído y, si no ha habido error, vamos a convertirlo en un valor. Para eso vamos a usar la función wcstoul() que detecta automáticamente si el número empieza por “0x” o es decimal.

 if(i.bad()) throw L"Error while reading a number";

 wchar_t* e;
 int value=wcstoul(s.c_str(), &e, 0);

La función wcstoul() devuelve en la variable e el puntero al primer carácter que no formaría parte del número. Este puntero deberá dirigirse al final de la cadena y si no es así, ha ocurrido algo raro.

 if(e!=s.c_str()+s.size())
  throw L"Invalid number";

Por otra parte, si todo va bien, usamos CreateInteger() para generar la celda con el entero correspondiente.

 return CreateInteger(value);
}
La función CreateInteger() es muy simple. Crea una celda de tipo INT_LIT usando la función CreateCell() y le asigna el valor designado para el entero.

CELL& CreateInteger(int val)
{
 CELL& c=CreateCell(INT_LIT);
 c.int_val=val;
 return c;
}

En la próxima parte de esta serie del lenguaje MiniSL vamos a ver cómo analizar sintácticamente las expresiones primarias. Estas expresiones son las que no están formadas por otras expresiones por lo que no hay ambigüedad posible en su análisis.

jueves, 27 de junio de 2013

miniSL parte 20 - Lectura de nombres y símbolos

En esta entrada vamos a describir cómo se analizan los tokens de nombres y símbolos. Los nombres son muy simples en su composición. Son caracteres alfanuméricos o un subrayado (guión bajo). Sólo llamaremos a ReadName() cuando el primer carácter sea alfabético, por lo que no haremos esta comprobación otra vez.

Script::TOKEN Script::ReadName(ISTREAM& i)
{
 STRING s;
 while(unsigned(i.peek())<256 && (isalnum(i.peek()) || i.peek()=='_') && i.good())
  s+=i.get();

 if(i.bad()) throw L"Error while reading an identifier or a keyword";

 return TOKEN(T_NAME, &CreateName(s));
}

La lectura de símbolos es algo más delicada. En definitiva, toda secuencia de caracteres simbólicos va a ser un símbolo; excepto cuando hay un igual. De esa manera podremos analizar cosas como “a=-3” de la manera correcta “a = -3”.

CELL& Script::ReadSymbol(ISTREAM& i)
{
 STRING s;
 while(CELL::IsSymbol(i.peek()) && i.good())
 {
  s+=i.get();

Aquí es donde comprobamos el igual. Como queremos heredar de C/C++ el símbolo “==” para la igualdad, hemos de asegurarnos que no se rompa este doble igual.

  if(i.peek()!='=' && *(s.end()-1)=='=')
   break;
 }

Internamente, un símbolo es un nombre así que usamos CreateName().

 return CreateName(s);
}

Finalmente, para que funcione el algoritmo de playa de agujas, hemos de establecer la precedencia y asociatividad de cada símbolo. Esto lo hace la siguiente función que asume que los símbolos serán similares a los del C/C++.

int Script::SymbolPrecedenceAndAssoc(STRING const& s)
{

Los símbolos que acaban en “=” como “+=” o “%=” son asignaciones (prioridad 11 muy baja) o relacionales (mayor igual o menor igual, prioridad 40).

 bool assign_end= s.at(s.size()-1)=='=';

 switch(s.at(0))
 {
 case '*': case '/': case '%':   return assign_end ? 11 : 100;
 case '+': case '-':      return assign_end ? 11 : 90;

Como comentamos antes, el caso de los relacionales es algo especial ya que tenemos que distinguir “<<” (desplazamiento) de “<=” (relacional) y de “<<=” (asignación).

 case '>': case '<':
  if(s.size()>1 && s.at(0)==s.at(1)) return assign_end ? 11 : 80;
  else        return 40;

Los símbolos que empiezan por “&” también tienen un tratamiento especial ya que debemos distinguir “&&” (lógico) de “&” (operación de bits) y “&=” (asignación).

 case '&':
  if(s.size()>1 && s.at(0)==s.at(1)) return assign_end? 11 : 30 ;
  else        return assign_end? 11 : 70 ;

Los que empiezan por “|” son similares a los que empiezan con “&”, pero con una prioridad algo menor.

 case '|': case '^':
  if(s.size()>1 && s.at(0)==s.at(1)) return assign_end? 11 : 20;
  else        return assign_end? 11 : 60;

Finalmente, los símbolos “!=”, “==”, “~=” y “?=” vamos a tratarlos como relacionales con prioridad 50. El “=” es asignación y tendrá prioridad 11. Finalmente, si no acaba en “=”, será operación con prioridad 54.

 case '!': case '=': case '~': case '?':
  if(assign_end)      return s.size()==1 ? 11 : 50;
  else        return 54;

Si no conocemos el símbolo, error.

 default:
  throw L"Unknown symbol";
 }
}

En la próxima entrada veremos la lectura de números. Es algo más compleja porque vamos a leer números enteros en base decimal o hexadecimal, pero veremos algunos trucos para simplificar el código.

martes, 12 de febrero de 2013

miniSL parte 19 - Lectura de cadenas

Continuamos con la implementación de un mini lenguaje de script. En esta entrada vamos a hablar de la función que lee cadenas. Hemos mezclado en una misma función la lectura de cadenas y la creación de nombres.

Esta función es de las más complejas ya que tenemos que tratar con el escape de símbolos, incluyendo símbolos hexadecimales.

Empecemos por el principio y continuemos poco a poco.

La función devolverá una celda. Debido a que, según sea un nombre o no, la celda será STRING_LIT o NAME_CODE y no lo sabríamos por adelantado; hemos de añadir un flag create_name que indique a la función si quiere una cosa u otra.

CELL& Script::ReadString(ISTREAM& i, bool create_name)
{

Lo primero es quitar las dobles comillas con las que empieza la cadena.

i.get();

Y vamos a ir leyendo mientras no encontremos el cierre de las comillas o haya habido un error. Usaremos la varible s para ir guardando lo que vayamos leyendo.

STRING s;
while(i.peek()!='"' && i.good())
{

Aquí empiezan las complicaciones, si encontramos una barra de escape, debemos leer el siguiente carácter y actuar en consecuencia.

if(i.peek()=='\\')
{
i.get();
switch(i.get())
{

Los primeros casos son los códigos de control que se traducen directamente al C/C++. Para los curiosos, los códigos de control se listan en esta página.

case 'a': s+=L"\a"; break;
case 'b': s+=L"\b"; break;
case 'f': s+=L"\f"; break;
case 'n': s+=L"\n"; break;
case 'r': s+=L"\r"; break;
case 't': s+=L"\t"; break;
case 'v': s+=L"\v"; break;
case '\'': s+=L"'"; break;
case '"': s+=L"\""; break;
case '\\': s+=L"\\"; break;

En nuestro lenguaje vamos a variar algunas cosas. Por ejemplo, no usamos la comilla simple, pero sí quiero escapar la interrogación.

case '?': s+=L"?"; break;

Si empieza por una equis, entramos en la descripción hexadecimal del carácter escapado. Vamos a ir leyendo dígitos hexadecimales y guardarlos en la variable x.

case 'x':
{
STRING x;
while(unsigned(i.peek())&lt;256 && isxdigit(i.peek()) && i.good())
x.push_back(i.get());
if(x.empty()) throw L"Expecting a hexadecimal digit after \\x";

Usamos la función wcstoul para convertir lo leído en un número hexadecimal. Sólo vamos a permitir hasta el primer plano del UNICODE.

int n=wcstoul(x.c_str(), NULL, 16);
if(n&gt;0xFFFF) throw L"Invalid hexadecimal character";

Metemos el carácter en la cadena que estamos construyendo y comprobamos que le sigue un punto y coma. Tampoco es usual tener esto en C, pero quita ambigüedades y añade robustez.

s.push_back(wchar_t(n));

if(i.get()!=';')
throw L"Expecting semicolon after hex escape sequence";
}
break; 

En otro caso, no conocemos la secuencia de escape.

default: throw L"Unknown escape sequence";
}
}

Si no era una secuencia de escape, lo introduce directamente en la cadena. Esto puede ser problemático porque copia directamente cualquier cosa, incluso las que no se ven, del código fuente a la cadena; pero como es un mini lenguaje, vamos a asumirlo.

else
s+=i.get();
}

Finalmente, comprobamos algunas cosas como que terminemos en unas comillas o que no haya habido algún error.

if(i.bad())   throw L"Error while reading a string";
if(i.get()!='"') throw L"Unexpected end of file inside a string";

A la hora de retornar la celda, según sea el flag pasado, creamos una cadena o un nombre. Realmente, ahora me doy cuenta que es un error haberlo hecho así y es mejor usar composición de funciones. Para la siguiente versión.

return create_name ? CreateName(s) : CreateString(s);
}

La siguiente parte de esta serie se va a dedicar a leer nombres y símbolos.

lunes, 13 de febrero de 2012

miniSL parte 18 - Funciones auxiliares del escaneador léxico

En la entrada anterior usamos SkipWhitespace() que automágicamente se saltaba todos los caracteres en blanco hasta el siguiente carácter. La función no es realmente complicada y se limita a ir observando con peek() el siguiente carácter para tirarlo con get() si es un espacio en blanco.

La única variación va a ser el reconocimiento de comentarios. Los comentarios empiezan con un # y terminan con el final de línea.

void Script::SkipWhitespace(ISTREAM& i)
{
 while(i.good() && unsigned(i.peek())<256 && (iswspace(i.peek()) || i.peek()=='#'))
 {
  if(i.peek()=='#')
  {
   i.get();
   while(i.good() && i.peek()!='\n')
    i.get();
  }
  else
   i.get();
 }
}

Es importante dejar claro aquí que no vamos a soportar UNICODE (ni siquiera el famoso "pila de caca") y cualquier carácter por encima del 255 será considerado extraño. De ahí la condición en la guarda del bucle.

Trabajar con iostreams es un poco pesadilla porque no usa excepciones para cosas que deberían ser excepciones (de hecho, los gurús del C++ se quejan a menudo de esta parte de la biblioteca estándar). Poco más podemos hacer para remediarlo que ir comprobando con i.good() cada vez.

Otra función que se usará de vez en cuando es la que espera consumir un token raw (un carácter) en concreto. Es muy simple.

void Script::ConsumeRawToken(ISTREAM& i, ISTREAM::int_type c, wchar_t const* msg)
{
 TOKEN t=ReadToken(i);
 if(t.type!=T_RAW || t.raw!=c)
  throw msg;
}

Si el carácter no es el esperado, lanzamos una excepción con el mensaje. Como hablamos de caracteres, el token ha de ser T_RAW.

Con esto acabamos las funciones auxiliares y pasamos a la lectura de cadenas en la siguiente entrada.

jueves, 1 de diciembre de 2011

miniSL parte 17 - El analizador léxico

Hasta aquí hemos visto la semántica de nuestro lenguaje script mínimo. A partir de ahora, empezamos con el reconocedor sintáctico. Debido a que nuestro lenguaje tiene una sintaxis no trivial, nos ocupará bastante tiempo describirlo. (Una sintaxis trivial es la del LISP)

Generalmente los reconocedores sintácticos se separan en dos partes (por ejemplo, el clásico LEX&YACC). La primera llamada analizador léxico (scanner o lexer) reconoce varios caracteres del fichero de entrada (por ejemplo 3, 5 y 6) y nos devuelve un elemento significativo llamado token (el número 356). La segunda parte es el analizador sintáctico propiamente dicho (llamado parser) que acepta los tokens y devuelve un AST. Veremos esta segunda parte más adelante y nos centramos en la generación de tokens.

En miniSL hay varios tipos de token que se listan en la enumeración TOKEN_TYPE.
enum TOKEN_TYPE { T_NONE, T_RAW, T_LITERAL, T_SYMBOL, T_NAME };
El tipo T_NONE indica que no se han reconocido los caracteres. Usamos T_RAW cuando el token es un único carácter (por ejemplo, una llave { o una coma , ). Es importante saber aquí que el final de fichero, un carácter llamado EOF, también se guarda en un token de tipo T_RAW. El tipo de token T_LITERAL indica o bien un número, o bien una cadena, en general una celda literal. Guardaremos el valor que corresponda en una celda del tipo adecuado. El token de tipo T_SYMBOL es un identificador formado por símbolos tales como +, <= o !=. Finalmente, T_NAME se usa para identificadores alfanuméricos como x, map o iterator. Tanto los tokens de tipo T_SYMBOL como los T_NAME guardan el identificador en una celda de tipo STRING_LIT.

La información del tipo de token y la información relativa al token se guardan en la estructura TOKEN que es la siguiente.
struct TOKEN
 {
  TOKEN() : type(T_NONE) {}
  TOKEN(TOKEN_TYPE t, CELL* d) : type(t), data(d) {}
  TOKEN(ISTREAM::int_type r) : type(T_RAW), raw(r) {}

  TOKEN_TYPE type;
  union
  {
   CELL* data;
   ISTREAM::int_type raw;
  };
 };
Los constructores fuerzan que cuando el TOKEN sea de tipo T_RAW, la información relacionada es un único carácter guardado en la variable miembro raw. En los otros tipos lo guardaremos en la celda apuntada por la variable miembro data. Esta estructura no es muy segura porque podríamos colar un T_RAW en el constructor que toma una celda. Vigilaremos que eso no ocurra.

Ahora queda leer los caracteres y generar el token correspondiente. De eso se encarga la función ReadToken(). La función ReadToken() devuelve el siguiente token leído y lo consume. De esta forma, cada vez que llamemos a ReadToken() avanzaremos por el fichero hasta obtener el carácter de fin de fichero EOF. Sin embargo, muchas veces no querremos avanzar por el fichero. Querremos únicamente saber cuál es el siguiente token, sin consumirlo. De esto se encarga la función PeekToken().

Nota: “Peek” en inglés significa “ojear” en el sentido de mirar a hurtadillas.

Script::TOKEN Script::PeekToken(ISTREAM& i)
{
 if(m_Ahead.type!=T_NONE)
  return m_Ahead;

 m_Ahead=ReadToken(i);
 return m_Ahead;
}
El funcionamiento de PeekToken() es muy simple porque se basa en ReadToken(). Primero, comprueba si ya hemos leído el siguiente token que se ha guardado en m_Ahead. Esta no es más que una variable miembro en la clase Script (para los que no recuerden la clase Script, ver la parte séptima).
TOKEN m_Ahead;
Si m_Ahead guarda ya el token leído, lo devuelve. Si m_Ahead no contiene el token leído, lo lee con ReadToken() y lo guarda en m_Ahead para siguientes PeekToken()s. De esta manera, llamar a PeekToken() varias veces, sólo llama a ReadToken() la primera vez y usa m_Ahead el resto.

¿Por qué es importante saber cómo funciona PeekToken() antes de saber cómo funciona ReadToken()? Muy sencillo. Si m_Ahead contiene un token y llamamos a ReadToken(), hay que vaciar m_Ahead. De esta forma se consume.
Script::TOKEN Script::ReadToken(ISTREAM& i)
{
 if(m_Ahead.type!=T_NONE)
 {
  TOKEN t=m_Ahead;
  m_Ahead.type=T_NONE;
  return t;
 }
A partir de este momento empieza, realmente la lectura de caracteres dentro de ReadToken(). La primera acción es saltarse el espacio en blanco. Nuestra sintaxis va a ignorar los espacios en blanco.
SkipWhitespace(i);
Luego, vamos a ojear el siguiente carácter. Podréis comprobar que no he inventado nada nuevo al llamar PeekToken() a mi función ya que la biblioteca estándar de C++ llama a esta función peek().
ISTREAM::int_type c=i.peek();
Según sea ese carácter, decidiremos leer un token de un tipo o de otro. Si es una doble comilla, será una cadena.
if(c=='"')     return TOKEN(T_LITERAL, &ReadString(i, false));
Si es un símbolo ASCII extendido, lo examinaremos. Para eso usamos la comparación c<256.
if(c<256)
 {
  if(isalpha(c) || c=='_') return ReadName(i);
  if(isdigit(c))    return TOKEN(T_LITERAL, &ReadNumber(i));
  if(CELL::IsSymbol(c))  return TOKEN(T_SYMBOL, &ReadSymbol(i));
Hasta aquí todo sencillo. Si es un carácter alfanumérico, lo leemos como un nombre. Si es un dígito, como un número. Si es un símbolo, como símbolo.

Pero ahora vamos a añadir una puerta trasera que ya ha sido muy útil. De hecho, nos ha permitido imprimir de manera uniforme los identificadores. Básicamente consiste en poner una arroba delante de una cadena. Entonces, en vez de cadena tomamos ese token como un identificador. Será lo mismo escribir mi_variable que @”mi_variable”. También añadiremos la sintaxis de arroba seguido de símbolo con la misma idea. Será lo mismo escribir 3+5 que @+(3,5).
if(c=='@') //Symbol or string as name
  {
   i.get();
   if(i.peek()=='"')    return TOKEN(T_NAME, &ReadString(i, true));
   if(CELL::IsSymbol(i.peek())) return TOKEN(T_NAME, &ReadSymbol(i));
   throw L"Expecting a symbol or a string after @";
  }
 }
Si el carácter no es ASCII extendido, será probablemente el carácter EOF así que lo guardamos como un token T_RAW. Además, si ninguna de las condiciones anteriores se dio, será un carácter ASCII extendido no usado por otro tipo de token. Deberá ser T_RAW también.
//Raw one-character token
 return TOKEN(i.get());
} 
Nota: Esto no funciona con UTF-8 que sería lo suyo. Introduciríamos una complejidad que sobrepasa los objetivos de este pequeño lenguaje de script.

Y ya hemos leído el token. Ahora queda examinar todas esas funciones de ayuda que hemos utilizado. Empezaremos con SkipWhitespace() en la siguiente parte y seguiremos con ReadString() y demás más adelante.

domingo, 9 de octubre de 2011

miniSL parte 16 - El código hasta ahora

Como prometí en la última entrada de esta serie, aquí está el código que tenemos desarrollado hasta ahora. Ya llevamos 425 líneas de código. Más o menos la mitad de toda la implementación. Faltan por desarrollar el reconocimiento sintáctico, las funciones nativas y el REPL. Empezaremos en la siguiente entrada con el reconocimiento sintáctico.

//Standard includes
#include <string>
#include <map>
#include <deque>
#include <fstream>
#include <sstream>
#include <iostream>
#include <vector>

//Forward declarations
class Script;
struct CELL;

//
// Type declarations
//

typedef std::wstring STRING;
typedef std::wistream ISTREAM;
typedef std::wostream OSTREAM;
typedef std::map<STRING, CELL*> STRING_MAP;
typedef std::map<CELL*, CELL*> ENVIR_TABLE;
typedef std::deque<CELL> CELL_STORAGE;
typedef CELL& (*NATIVE) (Script& script, CELL& args, CELL& envir);


//
// CELL STRUCTURE
//

enum CELL_TYPE
{
 UNUSED, 

 //Literals
 EMPTY_LIT, INT_LIT, STRING_LIT,

 //Value constructors
 LAMBDA_VAL, NATIVE_VAL, ENVIR_VAL, BOOL_VAL, 

 //Code constructors
 NAME_CODE, COMBINE_CODE,

 //Value and code constructors
 CONS_CTOR
};

struct CELL
{
 CELL_TYPE type;
 bool mark;      //Garbage collection mark
 union
 {
  CELL* next_unused;   //UNUSED
  int int_val;    //INT_LIT
  bool bool_val;    //BOOL_VAL
  STRING const* string_val; //STRING_LIT
  CELL* head;     //CONS.
  CELL* code;     //LAMBDA_VAL. The cell must be a CONS_CTOR with parameters and body
  NATIVE native;    //NATIVE_VAL
  ENVIR_TABLE* envir_table; //ENVIR_VAL
  CELL* op;     //COMBINE_CODE. The cell must be code (Any *_CODE type or CONS or EMPTY)
 };

 union
 {
  CELL* tail;   //CONS. Must be CONS or EMPTY.
  CELL* closure;  //LAMBDA_VAL. The cell must be an environment (ENVIR_VAL)
  CELL* parent_envir; //ENVIR_VAL. The pointer may be NULL or an environment cell (ENVIR_VAL)
  CELL* operands;  //COMBINE_CODE. The cell must be a list of code.
 };

 void Print(OSTREAM& o)const;
 void PrintList(OSTREAM& o, STRING const& separator)const;
 static void PrintEscapedString(OSTREAM& o, STRING const& s);

 int GetInteger()const   { if(type==INT_LIT) return int_val; else throw L"Integer expected"; }
 bool GetBoolean()const   { if(type==BOOL_VAL) return bool_val; else throw L"Boolean expected"; }
 STRING const& GetString()const { if(type==STRING_LIT) return *string_val; else throw L"String expected"; }
};

//
// SCRIPT CLASS
//

class Script
{
public:
 Script() : m_FirstUnused(NULL) { m_GlobalEnvir=&CreateEnvir(NULL); }
 ~Script() { GCSweep(); GCSweep(); } //Sweep twice to delete everything

 CELL& CreateCell(CELL_TYPE ct, CELL* first=NULL, CELL* second=NULL);
 CELL& CreateInteger(int val){ CELL& c=CreateCell(INT_LIT); c.int_val=val; return c; }
 CELL& CreateBool(bool val) { CELL& c=CreateCell(BOOL_VAL); c.bool_val=val; return c; }
 CELL& CreateString(STRING const& val);
 CELL& CreateName(STRING const& val);
 CELL& CreateEnvir(CELL* parent);
 CELL& CreateNative(NATIVE native);

 ENVIR_TABLE& GlobalEnvirTable()const { return *m_GlobalEnvir->envir_table; }
 void DefineUsualSymbols();

 void DefineGlobalNative(STRING const& name, NATIVE nat)
 {
  (*m_GlobalEnvir->envir_table)[&CreateName(name)]=&CreateNative(nat);
 }

 CELL& Evaluate(CELL& c, CELL& envir);
 CELL& EvaluateInSequence(CELL& listc, CELL& envir);
 CELL& Evaluate(CELL& c)     { return Evaluate(c, *m_GlobalEnvir); }

 int GarbageCollect();
 static void GCMark(CELL* c);

 static CELL* FindName(CELL& name, CELL& envir);
 static void ChangeName(CELL& name, CELL& envir, CELL& value);

 void* m_User;
private:
 enum TOKEN_TYPE { T_NONE, T_RAW, T_LITERAL, T_SYMBOL, T_NAME };

 struct TOKEN
 {
  TOKEN() : type(T_NONE) {}
  TOKEN(TOKEN_TYPE t, CELL* d) : type(t), data(d) {}
  TOKEN(ISTREAM::int_type r) : type(T_RAW), raw(r) {}

  TOKEN_TYPE type;
  union
  {
   CELL* data;
   ISTREAM::int_type raw;
  };
 };

private:
 int GCSweep();

 CELL& ApplyLambda(CELL& code, CELL& args, CELL& closure, CELL& envir);
private:
 CELL* m_FirstUnused;
 CELL* m_GlobalEnvir;
 CELL_STORAGE m_Cells;
 STRING_MAP m_InternedStrings;
 TOKEN m_Ahead;
};

//
// (CELL) PRINTING
//

void CELL::Print(OSTREAM& o)const
{
 switch(type)
 {
 default:  o << L"{{**UNKNOWN**}}"; break;
 case UNUSED: o << L"{{**UNUSED**}}"; break;
 case INT_LIT: o << std::dec << int_val; break;
 case BOOL_VAL: o << (bool_val ? L"true" : L"false"); break;
 case LAMBDA_VAL:o << L"{{ "; code->Print(o); o << L" }}"; break;
 case NATIVE_VAL:o << L"{{NATIVE}}"; break;
 case STRING_LIT:PrintEscapedString(o, *string_val); break;
 case NAME_CODE: o << L"@"; PrintEscapedString(o, *string_val); break;

 case CONS_CTOR: case EMPTY_LIT:
  o << L"[";
  PrintList(o, L", ");
  o << L"]";
  break;

 case ENVIR_VAL: o << L"{{ENVIR ";
  for(ENVIR_TABLE::const_iterator i=envir_table->begin(); i!=envir_table->end(); ++i)
  {
   o << *i->first->string_val << L"= ";
   i->second->Print(o);
  }
  o << L"}}";
  break;

 case COMBINE_CODE:
  op->Print(o);
  o << L"(";
  operands->PrintList(o, L", ");
  o << L")";
  break;
 }
}

void CELL::PrintList(OSTREAM& o, STRING const& separator)const
{
 for(CELL const* c=this; c->type==CONS_CTOR; c=c->tail)
 {
  if(c!=this)
   o << separator;
  c->head->Print(o);
 }
}

void CELL::PrintEscapedString(OSTREAM& o, STRING const& s)
{
 o << L"\"";
 for(STRING::const_iterator i=s.begin(); i!=s.end(); ++i)
 {
  if(*i<32) o << L"\\x" << std::hex << (unsigned int)(unsigned)*i << L";";
  else  o << *i;
 }
 o << L"\"";
}


//
// ALLOCATION AND GARBAGE COLLECTION
//

CELL& Script::CreateCell(CELL_TYPE ct, CELL* first, CELL* second)
{
 CELL* p;
 if(m_FirstUnused==NULL)
 {
  CELL c;
  m_Cells.push_back(c);
  p=&m_Cells.back();
 }
 else
 {
  p=m_FirstUnused;
  m_FirstUnused=p->next_unused;
 }
 p->mark=false;
 p->type=ct;
 p->head=first;
 p->tail=second;
 return *p;
}

CELL& Script::CreateString(STRING const& val)
{
 CELL& c=CreateCell(STRING_LIT);
 c.string_val=new STRING(val);
 return c;
}

CELL& Script::CreateName(STRING const& val)
{
 STRING_MAP::const_iterator i=m_InternedStrings.find(val);
 if(i==m_InternedStrings.end())
 {
  CELL& c=CreateCell(NAME_CODE);
  i=m_InternedStrings.insert(std::make_pair(val, &c)).first;
  c.string_val=&i->first;
 }
 return *i->second;
}

CELL& Script::CreateEnvir(CELL* parent)
{
 CELL& c=CreateCell(ENVIR_VAL);
 c.envir_table=new ENVIR_TABLE;
 c.parent_envir=parent;
 return c;
}

CELL& Script::CreateNative(NATIVE native)
{
 CELL& c=CreateCell(NATIVE_VAL);
 c.native=native;
 return c;
}

int Script::GarbageCollect()
{
 GCMark(m_GlobalEnvir);
 return GCSweep();
}

void Script::GCMark(CELL* c)
{
 if(c==NULL || c->mark)
  return;

 c->mark=true;

 switch(c->type)
 {
 case UNUSED:  throw L"Marking unused cell";
 case CONS_CTOR:  GCMark(c->head); GCMark(c->tail);  break;
 case LAMBDA_VAL: GCMark(c->code); GCMark(c->closure);  break;
 case COMBINE_CODE: GCMark(c->op);  GCMark(c->operands); break;

 case ENVIR_VAL:
  GCMark(c->parent_envir);
  for(ENVIR_TABLE::const_iterator i=c->envir_table->begin(); i!=c->envir_table->end(); ++i)
  {
   GCMark(i->first);
   GCMark(i->second);
  }
  break;
 }
}

int Script::GCSweep()
{
 int count=0;
 for(CELL_STORAGE::iterator i=m_Cells.begin(); i!=m_Cells.end(); ++i)
 {
  if(i->mark)
  {
   i->mark=false;
   continue;
  }

  if(i->type==UNUSED)
   continue;

  ++count;

  switch(i->type)
  {
  case STRING_LIT: delete i->string_val;      break;
  case ENVIR_VAL:  delete i->envir_table;      break;
  case NAME_CODE:  m_InternedStrings.erase(*i->string_val); break;
  }

  i->type=UNUSED;
  i->next_unused=m_FirstUnused;
  m_FirstUnused=&*i;
 }
 return count;
}

//
// EVALUATION
//

CELL& Script::Evaluate(CELL& c, CELL& envir)
{
 CELL* aux;
 switch(c.type)
 {
  //Non evaluable
 case UNUSED: throw L"Evaluating an unused cell";
 default:  throw L"Evaluating an unknown cell";
 case LAMBDA_VAL:throw L"Evaluating a lambda value";
 case NATIVE_VAL:throw L"Evaluating a native";
 case ENVIR_VAL: throw L"Evaluating an environment";

  //Literals
 case INT_LIT: case BOOL_VAL: case STRING_LIT: case EMPTY_LIT:
  return c;

  //Code constructors
 case CONS_CTOR:  return CreateCell(CONS_CTOR, &Evaluate(*c.head, envir), &Evaluate(*c.tail, envir));

 case NAME_CODE: 
  if((aux=FindName(c, envir))==NULL)
   throw L"Unknown name";
  return *aux;

 case COMBINE_CODE:
  switch((aux=&Evaluate(*c.op, envir))->type)
  {
  case LAMBDA_VAL: return ApplyLambda(*aux->code, *c.operands, *aux->closure, envir);
  case NATIVE_VAL: return aux->native(*this, *c.operands, envir);
  default:   throw L"Non-combinable value";
  }
 }
}

CELL& Script::EvaluateInSequence(CELL& c, CELL& envir)
{
 CELL* aux=&CreateCell(EMPTY_LIT);
 for(CELL* p=&c; p->type==CONS_CTOR; p=p->tail)
  aux=&Evaluate(*p->head, envir);
 return *aux;
}

CELL* Script::FindName(CELL& name, CELL& envir)
{
 //Try to find the name in current environment
 ENVIR_TABLE::const_iterator i=envir.envir_table->find(&name);
 if(i!=envir.envir_table->end())
  return i->second;

 //Failed, try parent
 if(envir.parent_envir!=NULL)
  return FindName(name, *envir.parent_envir);

 //Failed also, not found
 return NULL;
}

void Script::ChangeName(CELL& name, CELL& envir, CELL& value)
{
 //Try to find the name in current environment
 ENVIR_TABLE::iterator i=envir.envir_table->find(&name);
 if(i!=envir.envir_table->end())
 {
  (*envir.envir_table)[&name]=&value;
  return;
 }

 //Failed, try parent
 if(envir.parent_envir!=NULL)
  return ChangeName(name, *envir.parent_envir, value);

 //Failed also, not found
 throw L"Name to be changed is undefined";
}

CELL& Script::ApplyLambda(CELL& code, CELL& args, CELL& closure, CELL& envir)
{
 CELL& new_envir=CreateEnvir(&closure);
 CELL* params=code.head;
 CELL* arguments=&args;
 while(params->type==CONS_CTOR && arguments->type==CONS_CTOR)
 {
  (*new_envir.envir_table)[params->head]=&Evaluate(*arguments->head, envir);
  params=params->tail, arguments=arguments->tail;
 }

 if((params->type!=CONS_CTOR) != (arguments->type!=CONS_CTOR))
  throw L"Invalid arity";

 return EvaluateInSequence(*code.tail->head, new_envir);
}

sábado, 24 de septiembre de 2011

miniSL parte 15 - Funciones auxiliares de evaluación

En la última entrada sobre miniSL estuvimos estudiando la evaluación. La evaluación es directa en casi todos los casos. Únicamente cuando tenemos que ejecutar una función definida por el usuario (celda de tipo LAMBDA_VAL) necesitamos una función auxiliar.

Esta función es ApplyLambda() y lo que hace es tomar
  • El código del usuario que hay que ejecutar (esto está en la celda LAMBDA_VAL) que contiene también el nombre de los parámetros. 
  • El código de los argumentos que se le pasa a la función (esto está en el código, en la celda COMBINE_CODE) 
  • El entorno de clausura donde queremos que se evalúe el código del usuario (también está en la celda LAMBDA_VAL)
  • El entorno donde hay que evaluar los argumentos, ya que estos se evalúan en el entorno de llamada y no en el local.

CELL& Script::ApplyLambda(CELL& code, CELL& args, CELL& closure, CELL& envir)
{

Con estos valores, la función ApplyLambda() crea un entorno nuevo. El entorno local.
CELL& new_envir=CreateEnvir(&closure);

Luego, evalúa los argumentos en el entorno de llamada y los va introduciendo en este entorno local con los nombres de los parámetros que se declararon en el código. Si la función era f(a,b,c) y se llama con f(1+2,3+4,5+6), lo que ApplyLambda() hace es evaluar 1+2, obteniendo el valor 3, y vincular la variable a al valor 3 recién obtenido. Luego hace lo mismo vinculando b a 7 y c a 11. Esto se hace con este bucle.

CELL* params=code.head;
 CELL* arguments=&args;
 while(params->type==CONS_CTOR && arguments->type==CONS_CTOR)
 {
  (*new_envir.envir_table)[params->head]=&Evaluate(*arguments->head, envir);
  params=params->tail, arguments=arguments->tail;
 }

Bien podría ocurrir que nos sobren argumentos o parámetros. Es decir, que la aridad de la función no coincida con la de la llamada. Eso es un error.

if((params->type!=CONS_CTOR) != (arguments->type!=CONS_CTOR))
  throw L"Invalid arity";

Finalmente, evaluamos el código. El código es una secuencia y se debe evaluar como tal usando otra función auxiliar.

return EvaluateInSequence(*code.tail->head, new_envir);
}

La función auxiliar EvaluateInSequence() es sumamente sencilla. Evalúa una lista en secuencia y retorna el valor de la última expresión evaluada.

CELL& Script::EvaluateInSequence(CELL& c, CELL& envir)
{
 CELL* aux=&CreateCell(EMPTY_LIT);
 for(CELL* p=&c; p->type==CONS_CTOR; p=p->tail)
  aux=&Evaluate(*p->head, envir);
 return *aux;
}

Como se observa, lo más complicado (y lento) es ir vinculando en el entorno local los valores de los argumentos a los parámetros. De hecho, en los lenguajes de programación reales, se buscan convenios de llamada que eviten esto. Por ejemplo, introduciendo los valores de los argumentos en pila con cierto orden. De esta manera, la función llamada no tiene que buscar las variables por su nombre, que también es lento, sino por su posición en memoria que es mucho más rápido.

Con esto acabamos el núcleo del lenguaje. En la siguiente entrada pondré el código escrito hasta ahora y, a partir de entonces, empezaremos con el reconocimiento sintáctico del programa.

lunes, 1 de agosto de 2011

miniSL parte 14 - La Evaluación

Retomamos el lenguaje de script miniSL. Hasta ahora hemos definido los datos sobre los que vamos a tratar (las celdas) y hemos implementado las operaciones básicas sobre ellos: creación y destrucción. También hemos destacado algunos datos como el entorno global.

Ahora vamos a implementar la principal operación a realizar sobre los datos: tomar una celda que represente una expresión y calcular su valor (que será otra celda). Esto es lo que se llama la evaluación.

Existen varios modelos de evaluación. Aquí nos centraremos en la evaluación por entornos (se explica aquí y aquí). Este tipo de evaluación es realmente sencilla: si queremos saber el valor de una variable, hemos de buscarla en el entorno actual. Si no, buscamos en el entorno padre y así sucesivamente. Esto lo hace la función FindName() que se vio en la parte 10.

La evaluación de literales es inmediata: representan su propio valor (el 5 es el 5, la cadena “hola” es la cadena “hola”). La evaluación de combinaciones (aplicaciones de una función a argumentos) procede de la siguiente manera.
  1. Se evalúa el operador (la función).
  2. Se envían los operandos sin evaluar a la función.
Como hay dos tipos de funciones: la definida por el usuario y la nativa, tendremos que contemplar ambos casos. En principio, la definida por el usuario evaluará los operandos; pero veremos que las nativas necesitan sus operandos sin evaluar (en las partes 29,30 y siguientes).

La evaluación de una lista es la lista de sus miembros evaluados. Así, [1+2,5] es la lista [3,5]. La lista vacía es precisamente un literal porque no hay que evaluar nada para calcular su valor.

Cualquier otra celda no es considerada expresión y genera un error de ejecución.

El código de la función de evaluación es el siguiente:

CELL& Script::Evaluate(CELL& c, CELL& envir)
{
 CELL* aux;
 switch(c.type)
 {
  //Non evaluable
 case UNUSED: throw L"Evaluating an unused cell";
 default:  throw L"Evaluating an unknown cell";
 case LAMBDA_VAL:throw L"Evaluating a lambda value";
 case NATIVE_VAL:throw L"Evaluating a native";
 case ENVIR_VAL: throw L"Evaluating an environment";

  //Literals
 case INT_LIT: case BOOL_VAL: case STRING_LIT: case EMPTY_LIT:
  return c;

  //Code constructors
 case CONS_CTOR:  return CreateCell(CONS_CTOR, &Evaluate(*c.head, envir), &Evaluate(*c.tail, envir));

 case NAME_CODE: 
  if((aux=FindName(c, envir))==NULL)
   throw L"Unknown name";
  return *aux;

 case COMBINE_CODE:
  switch((aux=&Evaluate(*c.op, envir))->type)
  {
  case LAMBDA_VAL: return ApplyLambda(*aux->code, *c.operands, *aux->closure, envir);
  case NATIVE_VAL: return aux->native(*this, *c.operands, envir);
  default:   throw L"Non-combinable value";
  }
 }
}

Lo más complejo es la evaluación de la combinación. Esto es debido a los casos antes mencionados. Cuando tenemos una operación nativa, directamente llamamos a la función que la implementa. Si tenemos una operación definida por el usuario (lambda) usaremos una función auxiliar ApplyLambda() que veremos en la siguiente parte de esta serie.

lunes, 23 de mayo de 2011

miniSL parte 13 - El entorno global

En la parte anterior de esta serie hablamos del entorno global como conjunto raíz del recolector de basura. El código relacionado está en la parte octava de esta serie, en la función GarbageCollect(). También dijimos que el entorno global no es más que una celda destacada.
CELL* m_GlobalEnvir;
La creación de esa celda se va a realizar cuando iniciemos todo el sistema del lenguaje script. En el constructor de la clase Script.
Script() : m_FirstUnused(NULL) { m_GlobalEnvir=&CreateEnvir(NULL); }
Recordemos que m_FirstUnused se usaba para reutilizar las celdas recicladas por el recolector de basura.

Lo importante es que m_GlobalEnvir no va a cambiar y siempre va a ser un entorno. Vimos la función CreateEnvir() en la parte 11. En la parte 6 explicamos que una celda de entorno (de tipo ENVIR_VAL) sólo tiene un puntero a una tabla hash o árbol de búsqueda así que, como lo que vamos a hacer con este entorno es definir símbolos en él, sera muy útil obtener directamente la tabla del entorno global.
ENVIR_TABLE& GlobalEnvirTable()const { return *m_GlobalEnvir->envir_table; }
La mayor parte de símbolos que vamos a definir en la tabla del entorno global son operaciones nativas. La función DefineGlobalNative() nos ahorra tener que llamar a CreateName() y CreateNative() cada vez.
void DefineGlobalNative(STRING const& name, NATIVE nat)
 {
  (*m_GlobalEnvir->envir_table)[&CreateName(name)]=&CreateNative(nat);
 }
Finalmente, poblaremos la tabla del entorno global con la función DefineUsualSymbols(). Se declara así en la clase Script.
void DefineUsualSymbols();
Y se define así.
void Script::DefineUsualSymbols()
{
 DefineGlobalNative(L"=", &Native_Set);

 DefineGlobalNative(L"+", &Native_Add);
 DefineGlobalNative(L"-", &Native_Sub);
 DefineGlobalNative(L"*", &Native_Mul);
 DefineGlobalNative(L"&", &Native_BAnd);
 DefineGlobalNative(L"|", &Native_BOr);
 DefineGlobalNative(L"^", &Native_BXor);

 DefineGlobalNative(L"/", &Native_Div);
 DefineGlobalNative(L"%", &Native_Mod);

 DefineGlobalNative(L"==", &Native_Eq);
 DefineGlobalNative(L"!=", &Native_Ne);
 DefineGlobalNative(L"<", &Native_Lt);
 DefineGlobalNative(L"<=", &Native_Le);
 DefineGlobalNative(L">", &Native_Gt);
 DefineGlobalNative(L">=", &Native_Ge);

 DefineGlobalNative(L"if", &Native_If);
 DefineGlobalNative(L"let", &Native_Let);
 DefineGlobalNative(L"while", &Native_While);
 DefineGlobalNative(L"begin", &Native_Begin);
 DefineGlobalNative(L"define", &Native_Define);
 DefineGlobalNative(L"set", &Native_Set);
 DefineGlobalNative(L"lambda", &Native_Lambda);

 (*m_GlobalEnvir->envir_table)[&CreateName(L"true")]=&CreateBool(true);
 (*m_GlobalEnvir->envir_table)[&CreateName(L"false")]=&CreateBool(false);
}
La mayoría de estas funciones nativas (hemos prefijado el nombre con Native_ para distinguirlas claramente) todavía no están definidas. Lo haremos en las partes de la 26 a la 31.
Antes nos vamos a dedicar a la evaluación, puesto que tenemos ya especificado todo lo que hace falta para explicarla.

martes, 19 de abril de 2011

miniSL parte 12 - Limitaciones y uso del recolector de basura

Hasta ahora hemos hablado del montículo, las celdas y  cómo crearlas. Sin embargo, no hemos visto cómo se usa la recolección de basura implementada y, tampoco, sus limitaciones.

La recolección de basura sirve para detectar celdas no usadas y marcarlas como tales. La forma de hacerlo es muy sencilla. Tenemos un conjunto raíz que son celdas que sabemos a ciencia cierta que son usadas de forma. A partir de ese conjunto exploramos qué otras celdas usan. El resto son celdas sin usar. Este algoritmo se denomina mark and sweep (marca y barre). El código para esto se adelantó en la parte 8, pero queda por saber cómo se usa exactamente.

Lo importante son las limitaciones del algoritmo de recolección de basura implementado en miniSL. Son las siguientes.

  • El algoritmo de mark and sweep usado detiene la ejecución. Aunque este es el menor de nuestros problemas como veremos más adelante.
  • El algoritmo usado sólo usa el entorno global (lo veremos con más detalle en la siguiente parte) como el conjunto raíz. Esto quiere decir que no podemos llamar el algoritmo en medio de la ejecución del código porque la celda que contiene el entorno local de la función no forma parte del conjunto raíz.
  • En concreto, no podríamos lanzar el recolector de basura cuando notemos que nos hemos quedado sin memoria. Por ejemplo, en el caso de entrar en la línea 6 de la función Script::CreateCell(). Por esa razón, hemos de reservar una nueva celda y no reutilizar una antigua.
  • La estructura del recolector de basura no es incremental. El algoritmo mark and sweep usa dos conjuntos de celdas: las marcadas (usadas) y las no marcadas (no usadas). Para poder hacer un recolector de basura incremental hacen falta tres conjuntos llamados de celdas blancas, grises y negras.
  • Debido a todo esto, el propio miniSL no puede llamar al recolector de basura. Lo tiene que hacer la aplicación que use el script.

Ni que decir tiene que estas limitaciones hacen el lenguaje miniSL inútil en la vida real, pero simplifican muchísimo el código. Nosotros lo que haremos será llamar al recolector de basura en cada ciclo del bucle de lectura-evaluación-impresión o (REPL).
Este bucle será ahora:

  • Lectura de una expresión.
  • Evaluación de la expresión.
  • Impresión del resultado.
  • Recolección de basura.

Veremos el REPL en la parte 32, ya que antes hemos de definir cómo evaluamos y cómo leemos una expresión. Hasta ahora sólo sabemos imprimir las celdas.

En la siguiente entrada nos centraremos en el conjunto raíz de nuestro recolector de basura. Es decir, en el entorno global que contiene los símbolos definidos más generales.

domingo, 13 de marzo de 2011

miniSL parte 11 - Operaciones sobre el montículo

Ya hemos descrito el montículo en la parte octava. Ahora vamos a realizar dos tipos de operaciones sobre él. El primer grupo es el de las operaciones de reserva de memoria, mientras que el segundo grupo son las operaciones de liberado de memoria. En este post veremos las del primer grupo.
Inicialmente tenemos la creación de una celda genérica con dos referencias.

CELL& Script::CreateCell(CELL_TYPE ct, CELL* first, CELL* second)
{
 CELL* p;
 if(m_FirstUnused==NULL)
 {
  CELL c;
  m_Cells.push_back(c);
  p=&m_Cells.back();
 }
 else
 {
  p=m_FirstUnused;
  m_FirstUnused=p->next_unused;
 }
 p->mark=false;
 p->type=ct;
 p->head=first;
 p->tail=second;
 return *p;
}

Somos astutos y antes de reservar memoria (con el push_back) vemos si tenemos alguna celda libre ya reservada. Esto es algo ineficiente porque la celda que reservemos no vuelve a liberarse realmente, sólo se apunta como liberada. Todo sea por ser simples en la implementación.
Para crear celdas de otros tipos, primero creamos una celda genérica con Script::CreateCell y luego cambiamos sus campos específicos. Por ejemplo, para una cadena no interna.

CELL& Script::CreateString(STRING const& val)
{
 CELL& c=CreateCell(STRING_LIT);
 c.string_val=new STRING(val);
 return c;
}

En el caso de una cadena interna hemos de recurrir a las técnicas comentadas en la parte séptima. En concreto, usaremos el mapa m_InternedStrings para comprobar si ya tenemos o no la cadena internada. Si es así, la usamos. Si no, la creamos y la guardamos en el m_InternedStrings.

CELL& Script::CreateName(STRING const& val)
{
 STRING_MAP::const_iterator i=m_InternedStrings.find(val);
 if(i==m_InternedStrings.end())
 {
  CELL& c=CreateCell(NAME_CODE);
  i=m_InternedStrings.insert(std::make_pair(val, &c)).first;
  c.string_val=&i->first;
 }
 return *i->second;
}

Aquí se ve el truco comentado en la parte séptima: se usa la propia clave del mapa como la cadena interna. Esto nos fuerza a realizar la inserción en dos partes. Primero la celda de tipo NAME_CODE sin ningún puntero iniciado y, luego, se inicia el puntero string_val a la dirección de la clave i->first.

Para crear un entorno necesitamos crear adicionalmente su tabla de símbolos.

CELL& Script::CreateEnvir(CELL* parent)
{
 CELL& c=CreateCell(ENVIR_VAL);
 c.envir_table=new ENVIR_TABLE;
 c.parent_envir=parent;
 return c;
}

Y más sencillo aún son las funciones nativas porque son trozos de código que no se elimina nunca. En este caso necesitamos una función especial meramente porque el tipo es NATIVE y no CELL.

CELL& Script::CreateNative(NATIVE native)
{
 CELL& c=CreateCell(NATIVE_VAL);
 c.native=native;
 return c;
}

Con esto está la creación de celdas completada. En el siguiente apartado veremos cómo se usa el recolector de basura (garbage collector) del cual ya adelantamos algo en la parte octava.

miércoles, 23 de febrero de 2011

miniSL parte 10 - Extracción de valores

Si imprimir los valores de una celda fue fácil, obtenerlos va a ser aún más fácil. Podríamos leer directamente los campos de una celda, pero es más conveniente encapsular las operaciones más comunes en una única función miembro de CELL que lance una excepción si algo va mal.
int GetInteger()const
{
 if(type==INT_LIT)
  return int_val;
 throw L"Integer expected";
}

bool GetBoolean()const
{
 if(type==BOOL_VAL)
  return bool_val;
 throw L"Boolean expected";
}

STRING const& GetString()const
{
 if(type==STRING_LIT)
  return *string_val;
 throw L"String expected";
}

El único caso no trivial aparece cuando queremos explorar o modificar los entornos. Recordemos que cada celda de entorno tiene una tabla de símbolos (un ENVIR_TABLE que era un typedef de std::map<CELL*, CELL*&gt;) en el campo envir_table y un entorno padre en el campo parent_envir. Estas complejidades son necesarias para código con una forma similar a esta:
> define(a, 5)
[]
> define(f, lambda([x],[x+a]))
[]
> f(3)
8

Cuando se definen a y f, se hace en el entorno global. Cuando se llama a f(3) se crea un nuevo entorno local donde x se vincula a 3. ¿Pero cuánto vale a en el entorno local? ¡No está definida en el entorno local, está definida en el entorno global! La solución es crear un enlace, el del entorno padre, de la forma indicada en el diagrama de abajo.


De esta manera están disponibles tanto la a como la propia f dentro del cuerpo de la f. De todo esto, lo único que necesitamos por ahora son dos funciones en la clase Script. La primera hace la búsqueda de un nombre que se realiza siempre de la misma forma. Primero, buscamos en el entorno actual y, si no se encuentra, repetimos recursivamente buscando en el entorno padre.
CELL* Script::FindName(CELL& name, CELL& envir)
{
 //Try to find the name in current environment
 ENVIR_TABLE::const_iterator i=envir.envir_table->find(&name);
 if(i!=envir.envir_table->end())
  return i->second;

 //Failed, try parent
 if(envir.parent_envir!=NULL)
  return FindName(name, *envir.parent_envir);

 //Failed also, not found
 return NULL;
}

La segunda, para cambiar un nombre, hace casi lo mismo: buscamos el nombre en el entorno actual cambiándolo si lo encontramos y, si no lo encontramos, llamamos recursivamente la función en el entorno padre. Si no hay entorno padre es que el nombre no estaba definido.
void Script::ChangeName(CELL& name, CELL& envir, CELL& value)
{
 //Try to find the name in current environment
 ENVIR_TABLE::iterator i=envir.envir_table->find(&name);
 if(i!=envir.envir_table->end())
 {
  (*envir.envir_table)[&name]=&value;
  return;
 }

 //Failed, try parent
 if(envir.parent_envir!=NULL)
  return ChangeName(name, *envir.parent_envir, value);

 //Failed also, not found
 throw L"Name to be changed is undefined";
}

También necesitaremos la operación de definición de un nombre en el entorno actual como hace define, sin buscar en los entornos padre, pero coincide exactamente con la operación básica de inserción en std::map así que, aunque sea algo incorrecto al romper la abstracción sobre la implementación, usaremos directamente la clase std::map.

Hasta ahora sólo hemos explicado cómo leer una celda. En la siguiente entrada hablaremos de la creación de celdas.

miércoles, 2 de febrero de 2011

miniSL parte 9 - Imprimiendo celdas

La impresión de celdas en miniSL es relativamente sencilla usando un algoritmo recursivo. Según el tipo de celda, imprimimos su contenido tal y como se describió en la quinta parte de esta serie.

void CELL::Print(OSTREAM& o)const
{
 switch(type)
 {
 default:  o << L"{{**UNKNOWN**}}"; break;
 case UNUSED: o << L"{{**UNUSED**}}"; break;
 case INT_LIT: o << std::dec << int_val; break;
 case BOOL_VAL: o << (bool_val ? L"true" : L"false"); break;
 case LAMBDA_VAL:o << L"{{ "; code->Print(o); o << L" }}"; break;
 case NATIVE_VAL:o << L"{{NATIVE}}"; break;

Hasta aquí ningún extraño aparte de usar una llamada recursiva para imprimir el contenido del código en las funciones lambda. Para imprimir las cadenas debemos tener cuidado ya que pueden contener caracteres de control que no son imprimibles y hay que escaparlos.

case STRING_LIT:PrintEscapedString(o, *string_val); break;
 case NAME_CODE: o << L"@"; PrintEscapedString(o, *string_val); break;

Es importante notar que los nombres no son únicamente cadenas. Las cadenas se evalúan a sí mismas mientras que los nombres se evalúan buscándolos en el entorno actual. Para distinguirlos bien, pondremos el prefijo @ delante de ellos. De esta manera permitimos usar nombres con espacios o símbolos en ellos. Veremos que será muy útil para extender la sintaxis.

La impresión de las listas la vamos a hacer en la función CELL::PrintList() para así poder reutilizar el código a la hora de imprimir celdas COMBINE_CODE.

case CONS_CTOR: case EMPTY_LIT:
  o << L"[";
  PrintList(o, L", ");
  o << L"]";
  break;
 case COMBINE_CODE:
  op->Print(o);
  o << L"(";
  operands->PrintList(o, L", ");
  o << L")";
  break;

Finalmente, la impresión de un entorno se realiza iterando sobre él.

case ENVIR_VAL: o << L"{{ENVIR ";
  for(ENVIR_TABLE::const_iterator i=envir_table->begin(); i!=envir_table->end(); ++i)
  {
   o << *i->first->string_val << L"= ";
   i->second->Print(o);
  }
  o << L"}}";
  break;
 }
}

Nos queda por implementar entonces, la impresión de listas y de cadenas escapadas. Ambas funciones son relativamente directas.

void CELL::PrintList(OSTREAM& o, STRING const& separator)const
{
 for(CELL const* c=this; c->type==CONS_CTOR; c=c->tail)
 {
  if(c!=this)
   o << separator;
  c->head->Print(o);
 }
}

void CELL::PrintEscapedString(OSTREAM& o, STRING const& s)
{
 o << L"\"";
 for(STRING::const_iterator i=s.begin(); i!=s.end(); ++i)
 {
  if(*i<32) o << L"\\x" << std::hex << (unsigned int)(unsigned)*i << L";";
  else  o << *i;
 }
 o << L"\"";
}

Por ejemplo, la impresión de una lista, una función lambda y un booleano se ve así:

[1, 2, 3]
{{ [[@"x"], [@"+"(@"x", @"x")]] }}
true

Se observa que tanto la lista como el booleano es directamente código, pero la función lambda es un valor que no es representable directamente en código. Por eso lo vamos a escribir entre dobles llaves. Estos valores deben obtenerse como el resultado de una llamada. De hecho, también se pueden imprimir celdas del tipo COMBINE_CODE que son precisamente esas llamadas. Así, f(x,y) se imprimiría así:

@"f"(@"x", @"y")

De esta manera podemos ver los valores y el código que tenemos en el montículo, pero no nos basta con verlos. Debemos también poder utilizarlos. Para eso vamos a introducir una serie de funciones que nos permita extraer valores. Estas funciones van a ser también muy sencillas. Las dejaremos para la siguiente entrada.

sábado, 15 de enero de 2011

miniSL parte 8 - El montículo

Llega el momento de pensar dónde y cómo almacenar las celdas en memoria. La forma en la que vamos a hacerlo es la siguiente. Usaremos un std::deque para reservar memoria. Los deques permiten ir añadiendo memoria conforme se necesite y no mueven los bloques de memoria una vez reservados.

De todas las celdas que hayamos reservado, usaremos unas y tendremos otras libres, sin usar. Utilizaremos la recolección de basura para pasar celdas antes usadas pero ahora ociosas a celdas sin usar y libres para su reciclado.

La recolección de basura es un procedimiento que puede ser o bien muy complejo o bien muy simple. En este caso, y teniendo en cuenta que miniSL intenta implementarlo todo de la forma más simple y reducida, nos inclinaremos por el algoritmo más simple de recolección de basura. El llamado mark and sweep (marca y barre).

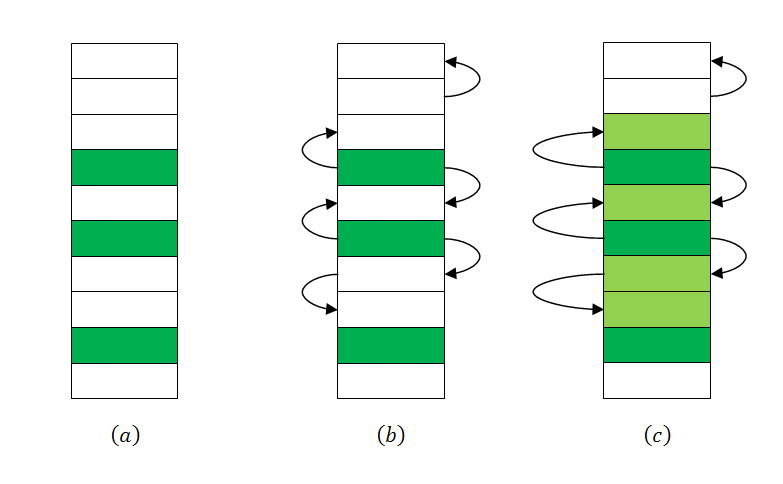
El mark and sweep funciona en dos pasos. El primer paso detecta las celdas en uso. ¿Cómo hace eso? Muy simple. O bien es una celda raíz (que siempre está en uso) o bien nos referencian desde otra celda en uso. Estas celdas en uso son marcadas. El segundo paso es barrer (=reciclar) todas las celdas que no están marcadas y limpiar la marca en las que sí.


La siguiente figura muestra a) el conjunto raíz, b) los punteros entre celdas y c) las marcas. Las celdas que en c) no estén marcadas (las blancas) serán las reclamadas por el recolector de basura y pasarán a estar libres para un posterior uso.

En la implementación lo primero que tenemos es el std::deque de almacenamiento de celdas.

CELL_STORAGE m_Cells;

Recordemos que definíamos CELL_STORAGE así:

typedef std::deque<CELL> CELL_STORAGE;

También necesitamos saber si hay celdas libres. Las pondremos todas en una lista simplemente enlazada que empieza en el campo m_FirstUnused.

CELL* m_FirstUnused;

Para reservar una celda primero vemos si hay alguna libre. Si no, aumentamos el std::deque reservando memoria para una celda más. Esto no es muy económico ya que lo interesante habría sido devolver la memoria usada por las celdas libres. Estamos actuando más bien como un pool que como un gestor de memoria.

CELL& Script::CreateCell(CELL_TYPE ct, CELL* first, CELL* second)
{
 CELL* p;
 if(m_FirstUnused==NULL)
 {
  CELL c;
  m_Cells.push_back(c);
  p=&m_Cells.back();
 }
 else
 {
  p=m_FirstUnused;
  m_FirstUnused=p->next_unused;
 }
 p->mark=false;
 p->type=ct;
 p->head=first;
 p->tail=second;
 return *p;
}

El algoritmo de marcado es recursivo de manera que explora todo el grafo de referencias (punteros entre celdas) en profundidad. Dependiendo del tipo de celda, alguno o ninguno de sus campos serán referencias que hay que explorar. Evitamos los posibles ciclos no volviendo a marcar las celdas ya marcadas.

void Script::GCMark(CELL* c)
{
 if(c==NULL || c->mark)
 return;

 c->mark=true;

 switch(c->type)
 {
 case UNUSED:  throw L"Marking unused cell";
 case CONS_CTOR:  GCMark(c->head); GCMark(c->tail);  break;
 case LAMBDA_VAL: GCMark(c->code); GCMark(c->closure);  break;
 case COMBINE_CODE: GCMark(c->op);  GCMark(c->operands); break;

 case ENVIR_VAL:
  GCMark(c->parent_envir);
  for(ENVIR_TABLE::const_iterator i=c->envir_table->begin(); i!=c->envir_table->end(); ++i)
  {
   GCMark(i->first);
   GCMark(i->second);
  }
  break;
 }
}

El caso más laborioso es el de los entornos. En ellos hay que iterar su contenido y explorarlo para el marcado.
El borrado ocurre en la rutina de barrido. Es simple y su única dificultad radica en las celdas especiales que contienen algún dato externo. Ya vimos uno de estos casos en las cadenas internas. Las cadenas normales y los entornos son otros casos similares. Cada uno de ellos ha de tener un borrado específico.

int Script::GCSweep()
{
 int count=0;
 for(CELL_STORAGE::iterator i=m_Cells.begin(); i!=m_Cells.end(); ++i)
 {
  if(i->mark)
  {
   i->mark=false;
   continue;
  }

  if(i->type==UNUSED)
   continue;

  ++count;

  switch(i->type)
  {
  case STRING_LIT: delete i->string_val;      break;
  case ENVIR_VAL:  delete i->envir_table;      break;
  case NAME_CODE:  m_InternedStrings.erase(*i->string_val); break;
  }

  i->type=UNUSED;
  i->next_unused=m_FirstUnused;
  m_FirstUnused=&*i;
 }
 return count;
}

Como conjunto raíz vamos a tener únicamente el entorno global. Añadimos una referencia a la celda de entorno de que lo contenga y lo marcamos en la recolección de basura.

int Script::GarbageCollect()
{
 GCMark(m_GlobalEnvir);
 return GCSweep();
}

A partir de aquí hemos de recordar que el entorno global es una celda destacada. De hecho, estará referenciada en la clase Script.

CELL* m_GlobalEnvir;

El lector atento habrá visto que hemos retornado el número de celdas barridas en el recolector de basura. El retorno del número de celdas es un buen sistema para depurar el recolector de basura, pero no es el único. De hecho, nos ofrece poca información. Otro sistema que va a ser útil no sólo para el recolector de basura sino también para observar los resultados de las evaluaciones es la impresión de celdas. En la siguiente entrada nos dedicaremos a esta tarea.