Mostrando entradas con la etiqueta calculabilidad. Mostrar todas las entradas

lunes, 26 de septiembre de 2011

Semántica formal para clausuras léxicas

El lambda cálculo es una herramienta asombrosa. En pocas líneas puedes definir un modelo de computación. Esta simplicidad permite transmitir ideas de manera formal con relativa facilidad. Por esa razón estuve pensando cómo explicar la clausura léxica de manera matemática.

El lambda cálculo con semántica natural

Empezaré por el lambda cálculo con semántica natural (también llamada operacional de paso grande). La sintaxis del lambda cálculo es muy sencilla. [$$t::=x\mid tt\mid \lambda x.t$$] Este tipo de definiciones sintácticas se leen así:

[$t::=$]Un término (o expresión) es
[$x$]o bien una variable
[$tt$]o bien una aplicación de un término sobre otro
[$\lambda x.t$]o bien una función que toma una variable y devuelve un valor calculado por un término. Esto es a lo que se llama una abstracción lambda o función anónima.


Nota: La aplicación se asocia por la izquierda. Entonces, en vez de escribir [$(((t_1 t_2) t_3) t_4)$] escribimos [$t_1 t_2 t_3 t_4$]. 

Lo que es la semántica es también muy fácil de expresar: un término se convierte en un valor mediante una relación binaria [$t\Downarrow v$]. Los valores [$v$] sólo son un tipo especial de término que se denominan formas normales (nosotros vamos a usar WNF). [$$v::= \lambda x.t \mid x v_1 \cdots v_n$$]  Estas formas normales no se pueden reducir más con las reglas de evaluación con las que vamos a expresar la semántica. Estas reglas son las siguientes:
   
Regla E-VAR[$$x\Downarrow x$$]Regla E-ABS[$$\lambda x.t \Downarrow \lambda x.t $$]
Regla E-APVAL[$$\frac{\begin{array}{c}t_1 \Downarrow x v_1 \cdots v_k\\t_2 \Downarrow v \end{array}}{t_1 t_2 \Downarrow x v_1 \cdots v_k v}$$] Regla E-APABS [$$\frac{\begin{array}{c}t_1 \Downarrow \lambda x.t\\t_2 \Downarrow v \\ [x\leftarrow v]t\Downarrow  v'\end{array}}{t_1 t_2 \Downarrow v'}$$]
Como se comprobará, las reglas E-VAR y E-ABS no son complicadas ya que tanto las variables como las abstracciones son valores. El núcleo de todo está en las aplicaciones.
Tanto la regla E-APVAL como la regla E-APABS tienen una forma que recuerda a las fracciones. Esta es una notación usual en lógica para especificar reglas de inferencia e indica que si lo de arriba, que es el antecedente, se cumple, entonces lo de abajo, el consecuente, se debe cumplir.

La regla E-APVAL toma dos términos aplicados el [$t_2$] al [$t_1$]. Si resulta que [$t_1$] tras evaluar tiene un valor que no es una abstracción, lo único que podemos hacer es poner el valor de [$t_2$] detrás de la forma normal, haciéndola un poco más larga. Esto tiene algo más de sentido si, por ejemplo, usamos una variable que se llame [$lista$] y evaluemos algo como [$(lista\ 1\ 7) (2+3)$]. El resultado es la propia [$lista\ 1\ 7$] con un añadido que es el valor de [$2+3$]. Es decir, que [$  (lista\ 1\ 7) (2+3) \Downarrow lista\ 1\ 7\ 5$].

La regla E-APABS también toma dos términos aplicados. Esta vez tiene que ocurrir que [$t_1$] se evalúa a una función [$\lambda x.t$]. Entonces, hay que aplicar el resultado de [$t_2$] que es [$v$] a la función. La forma de hacerlo es sustituir todas las apariciones de [$x$] en [$t$] por [$v$] y calcular el valor que nos da esto. La sustitución la hemos escrito como [$[x\leftarrow v]$].

Entonces, si queremos calcular el doble de 1+3, sería evaluar [$(\lambda x.x+x)(1+3)$]. Usando la regla E-APABS vemos que, efectivamente, [$t_1=  \lambda x.x+x$] y que [$t_1 \Downarrow   \lambda x.x+x $] gracias a la regla E-ABS. Entonces, [$t=x+x$]. Por otra parte, [$t_2=1+3$] y [$t_2 \Downarrow 4$]. Finalmente, la sustitución a realizar es [$[x\leftarrow  4]t = 4+4$]. La evaluación es [$4+4\Downarrow 8$] por lo que [$v'=8$] y podemos decir que ocho es el doble de cuatro: [$$(\lambda x.x+x)(1+3)\Downarrow 8$$]

Nota: ¿Cómo es que estamos usando sumas y números si no los hemos definido? Realmente, sí que lo están. El lambda cálculo permite codificar los números (y muchas más cosas) como funciones. Esta es la llamada codificación de Church.


El lambda cálculo sin sustituciones

El lambda cálculo es Turing completo. Esto quiere decir que cualquier función calculable se puede calcular en él. Esto, por otra parte, no significa que sea eficiente computacionalmente. De hecho, la sustitución es una operación muy costosa: hay que recorrer todo el término en el que queremos sustituir y comparar las variables y manipular grandes trozos de expresión. Las reglas exactas son estas:


[$$[x\leftarrow t]x=t$$][$$\frac{x\ne x'}{[x\leftarrow t]x'=x'}$$]
[$$[x\leftarrow t](t_1 t_2)=(  [x\leftarrow t] t_1 ) (   [x\leftarrow t]  t_2 )$$][$$[x\leftarrow t]\lambda x.t' =  \lambda x. t' $$]

La última regla está más abajo y es la más divertida porque tiene que evitar capturar las variables. Para hacer esto debe explorar además del término donde se sustituye el término a sustituir. Más coste.
[$$\frac{\begin{array}{c}x\ne x'\\x'\notin fv(t)\end{array}}{[x\leftarrow t]\lambda x'.t' =  \lambda x'. [x\leftarrow t] t' }$$] Todos los creadores de compiladores e intérpretes buscan los métodos más curiosos para evitar la sustitución. Uno de estos métodos es la evaluación por entornos, aunque hay más como las máquinas G, los supercombinadores, etc.

Nosotros vamos a usar la evaluación por entornos que es más simple. La idea es sencilla: no sustituimos, sólo apuntamos lo que hay que sustituir. Lo apuntamos en un entorno que es una colección de vinculaciones de ese tipo. [$$ E::= \emptyset \mid E, x=v $$] Añadimos el entorno a nuestra relación de evaluación de esta manera [$$ E \vdash t \Downarrow v$$] Se podría leer "bajo el entorno [$E$] el término [$t$] se evalúa a [$v$]".

La idea es sencilla, ahora hay que establecer las reglas de evaluación. Un primer intento podría ser éste:

   
Regla E-VAR[$$\frac{x=v \in E}{E\vdash x\Downarrow v}$$]Regla E-ABS[$$E\vdash\lambda x.t \Downarrow \lambda x.t $$]
Regla E-APVAL[$$\frac{\begin{array}{c}E \vdash t_1 \Downarrow x v_1 \cdots v_k\\ E \vdash t_2 \Downarrow v \end{array}}{E \vdash t_1 t_2 \Downarrow x v_1 \cdots v_k v}$$] Regla E-APABS [$$\frac{\begin{array}{c} E \vdash t_1 \Downarrow \lambda x.t\\ E \vdash t_2 \Downarrow v \\   E,x=v \vdash t\Downarrow  v'\end{array}}{ E \vdash t_1 t_2 \Downarrow v'}$$]
El truco está en la nueva regla E-VAR que mira en el entorno el valor de la variable encontrada y en la regla E-APABS que introduce en el entorno la vinculación.

Desafortunadamente estas reglas no funcionan.

El problema se observa en la siguiente evaluación [$$\emptyset \vdash (\lambda y.\lambda x.y) 3 \Downarrow v'$$] La regla a aplicar sería E-APABS que me diría que [$$ y=3 \vdash \lambda x.y \Downarrow v'$$] La regla E-ABS terminaría la evaluación incorrectamente [$$ y=3 \vdash \lambda x.y \Downarrow \lambda x.y$$] en vez de la correcta [$\lambda x.3$]. Hay que evitar que se pierda el entorno en la regla E-ABS. Al perder el entorno la expresión [$\lambda x.y$] queda abierta con la variable [$y$] libre. La solución es cerrarla con una clausura. La clausura será léxica porque hemos ido descendiendo por las estructuras sintácticas arrastrando los entornos hasta aquí.

Incluyamos entonces un nuevo término a nuestra sintaxis: las clausuras léxicas. Que son la combinación de una abstracción lambda y un entorno. [$$ t::= x\mid tt \mid \lambda x.t \mid \lambda^E x.t $$] Ahora los valores son [$$ v::= \lambda^E x.t \mid x v_1 \cdots v_k$$] y las reglas de evaluación correctas serían
   
Regla E-VAR[$$\frac{x=v \in E}{E\vdash x\Downarrow v}$$]Regla E-ABS[$$E\vdash\lambda x.t \Downarrow \lambda^E x.t $$]
Regla E-APVAL[$$\frac{\begin{array}{c}E \vdash t_1 \Downarrow x v_1 \cdots v_k\\ E \vdash t_2 \Downarrow v \end{array}}{E \vdash t_1 t_2 \Downarrow x v_1 \cdots v_k v}$$] Regla E-APABS [$$\frac{\begin{array}{c} E \vdash t_1 \Downarrow \lambda^{E'} x.t\\ E \vdash t_2 \Downarrow v \\   E',x=v \vdash t\Downarrow  v'\end{array}}{ E \vdash t_1 t_2 \Downarrow v'}$$]
He cambiado la regla E-ABS convirtiendo la abstracción (que es código) en la clausura léxica (que es un valor) y la regla E-APABS que ahora usa el entorno de la clausura en vez del entorno de llamada.

Si evaluamos otra vez   [$$\emptyset \vdash (\lambda y.\lambda x.y) 3 \Downarrow v'$$] obtenemos que [$ v'=\lambda^{y=3}x.y$]. Lo cual me dice que hay una sustitución pendiente de [$y$] por el valor [$3$]. Esta sustitución se hará cuando se aplique la función. No se perderá.

Nota: Hay un pequeñísimo detalle a tener en cuenta en estas nuevas reglas. Si queremos hacer una lista como hicimos antes [$lista\ 1\ (1+1)$] no podremos evaluarla. Eso es así porque la variable [$lista$] no está en el entorno y no podremos aplicar la regla E-VAR. Una solución a esto es añadir un entorno inicial donde [$lista=lista$] de manera que [$ lista=lista \vdash lista\ 1\ (1+1) \Downarrow   lista\ 1\ 2$]. Esto nos debe llevar a pensar que hay dos tipos de variables las de código ([$lista$][$=lista$]) y las de valor ([$lista=$][$lista$]). Haciendo que las variables de valor tengan también entorno ([$x^E$]) abrimos la puerta a las macros higiénicas.

miércoles, 11 de mayo de 2011

El punto de la pereza

Hace unos días Bob Harper, que defiende SML con uñas y dientes, se dedicó a atacar a los elitistas del Haskell. Su idea era muy sencilla: los tipos de Haskell no son inductivos. Voy a intentar explicar esto de forma sencilla.

Tipos inductivos

Son los tipos cuyos valores se construyen con unos valores bases y unos constructores. El caso arquetípico son los números naturales.
  • El 0 es un valor base.
  • El siguiente número natural S(n), es un constructor que, dado un número, construye otro.
Con esto y la inducción estructural tenemos los números naturales (y podemos demostrar propiedades sobre ellos).
  • El cero es 0
  • El uno es S(0)
  • El dos es S(S(0))
  • Y así.
También es posible usar como argumento de un constructor el valor de otro tipo. Este otro tipo será un parámetro del nuevo tipo. De esa manera aterrizamos en los tipos algebraicos. Por ejemplo, las listas de valores de un tipo T que llamaremos L(T) será.
  • La lista vacía [] es un valor base.
  • El constructor de lista  cons(V,R) toma un valor V de un tipo T y el resto de la lista R de tipo L(T).
Con esto y la inducción estructural, obtenemos las listas que queramos (y podemos demostrar propiedades sobre ellas).
  • Tomamos la lista vacía [] como valor base de una lista de enteros L(int)
  • Añadimos  un entero  cons(-3, [])
  • Añadimos otro entero  cons(7, cons(-3, []) )
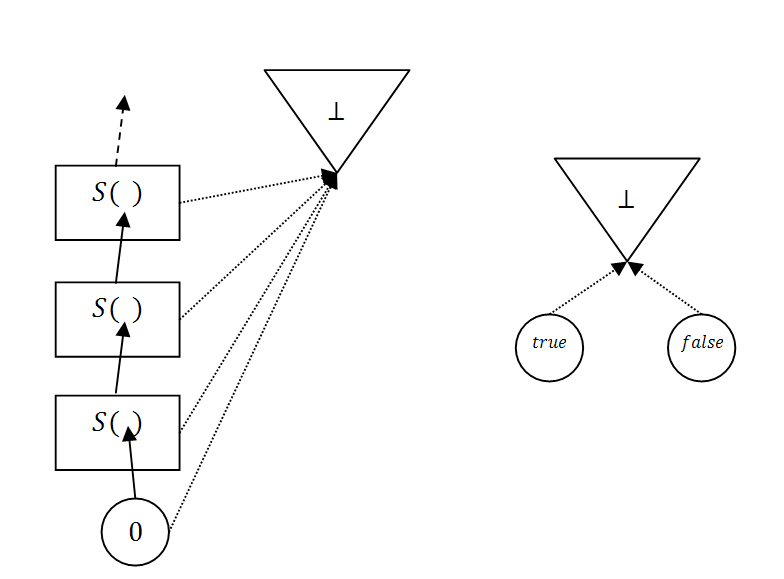
Todos estos tipos inductivos tienen una forma muy similar si se dibujan: son bosques de árboles (matemáticamente son órdenes parciales completos, también llamados dominios). En concreto, los números naturales son un árbol de una única rama.
Los números naturales son inductivos. El valor base es el 0, en un círculo, y el constructor es S(n), en rectángulos. De esta manera tenemos representados en la figura, de abajo arriba, los valores 0, S(0), S(S(0)), S(S(S(0))) y así sucesivamente.
Los booleanos son dos árboles sin ramas.
Los booleanos son dos valores base: true y false. No hay constructores. Estos tipos sin constructores suelen llamarse tipos enumerados.

Las listas de naturales son árboles con infinitas ramas ya que, cada vez que usamos un constructor con un natural distinto, generamos una nueva rama. Es difícil dibujar esto porque cada una de las infinitas ramas lleva a infinitos valores que, a su vez, vuelven a tener infinitas ramas. Con un poco de imaginación el diagrama sería algo así.
Lista de naturales. La lista vacía es el valor base [] que está abajo. A partir de él construimos infinitos valores, uno para cada natural. Serían las listas de un único natural. Asimismo, de cada uno de estos valores se obtienen otros infinitos valores. A este tipo de árboles infinitos pero con una estructura simple se los denomina árboles regulares.

Existen también los llamados tipos coinductivos en los cuales, en vez de tener una lista vacía (valores base) y usar constructores sobre ella, tenemos una lista llena (valores co-base) y usamos destructores (co-constructores) sobre ella. No hablaré mucho más de esto aquí.

Evaluación perezosa 

La evaluación perezosa, de la que hablamos alguna que otra vez, consiste básicamente en no evaluar hasta que no sea estrictamente necesario. Un caso clásico es la multiplicación por cero.

0*(7+5)

¿Para qué sumar siete y cinco si sabemos que al final la multiplicación va a ser cero? Bueno, existe un motivo por el que evaluar los argumentos y son los efectos laterales. Si en vez de sumar dos números imprimiésemos un mensaje, la cosa cambia.

0*(print "hola") 

Ahora sí que habría que imprimir "hola" aunque el resultado de esta multiplicación (si es que print devuelve un número, claro) sea cero. Pues bien, ocurre que en Haskell no hay efectos secundarios. Es un lenguaje funcional. En este lenguaje de programación sí que conviene no perder tiempo evaluando cosas que, al final, no se van a usar.

La idea fundamental de la crítica de Harper es que siempre existen los efectos secundarios. En concreto existe un efecto secundario que jamás puedes quitarte de encima en un lenguaje de programación Turing completo. Ese efecto es... que la computación no termine.

Imaginemos el siguiente programa:

f(x) = 1+f(x)  //Esta computación no termina 
0*f(3) 

Si el lenguaje es estricto y evalúa f(3), nunca llega a ejecutar la multiplicación. Si el lenguaje es perezoso y no evalúa f(3), la multiplicación ha aceptado un valor que no es un número (de hecho ni siquiera es un valor, es no terminación) y lo ha tratado como si fuera un número. ¿Cuál es el tipo del argumento que ha aceptado la multiplicación?

Los lenguajes con evaluación perezosa cuelan entre los valores de sus tipos la no terminación. O mejor dicho, algo todavía sin evaluar que puede ser no terminación o puede ser un valor concreto. Este valor tan especial que se puede convertir en otro (o no) se corresponde con el mínimo de un orden parcial completo con mínimo. Este mínimo tiene el nombre de "punto" y se suele representar con el símbolo [$\bot$].

Si añadimos el punto a los tipos inductivos el resultado es que ¡no son inductivos! Los naturales y los booleanos quedan algo así.
Los naturales y booleanos con punto. El punto representa la no evaluación (con la no terminación como posibilidad). El punto está más allá de la inducción. No se pueden usar técnicas inductivas para demostrar propiedades de él.
Esto rompe la posibilidad de usar la inducción estructural porque el punto queda más allá, más arriba, del resto de valores. Así que, según Harper, usar la evaluación perezosa es equivalente a olvidarse de la inducción estructural y, con ella, poder demostrar con facilidad múltiples propiedades en nuestro programa.

Epílogo

Por supuesto, esto es todo cuestión de compromisos. Usar evaluación perezosa abre la puerta a tener tipos coinductivos con mucha facilidad. De hecho la "lista llena" de la que hablé antes es precisamente el punto [$\bot$]. Una computación que puede no terminar, una lista infinita, de la cual vamos extrayendo valores, como los iteradores. Esto permite cosas nuevas como el uso de la composición en estos tipos coinductivos, lo que abre la posibilidad a la reutilización de código.

jueves, 20 de mayo de 2010

Tipos intersección

¿Qué son?

Supongamos que tenemos una función con el siguiente tipo

[$$ f: A \rightarrow B \rightarrow C $$]

¿Cuál es el tipo de esta nueva función?

[$$ \lambda x. f x x $$]

Esta claro que la x tendrá que ser de tipo A y de tipo B. Si tuviéramos subtipos, y asumiendo que el tipo de x es X, diríamos

[$$ X\le A,\quad X\le B $$]

Sería tarea del motor de inferencia buscar el tipo adecuado. Por otra parte, podríamos introducir una solución tramposa. Inventarnos el tipo

[$$ X=A\cap B $$]

con las  propiedades

[$$ T\cap S \le T $$]
[$$
T\cap S \le S $$]

Ni que decir tiene que esto recuerda mucho al concepto de intersección de conjuntos, de ahí el nombre.

El sistema de Coppo-Dezani

Si introducimos las reglas usuales de una intersección (es decir, las de un ínfimo) obtenemos el sistema de Coppo-Dezani (sistema CD). Este sistema tiene unas cualidades muy interesantes.

  • Cumple la reducción de sujeto. Es lo mínimo que se puede pedir a un sistema de tipos para una estrategia de evaluación por nombre: que si evaluamos en un paso nuestra expresión (sea el redex que sea), el tipo siga siendo el mismo.
  • Los términos tipables son los términos fuertemente normalizables. O sea, que sólo podremos darle un tipo a los términos cuya evaluación acabe.
  • Las formas normales son tipables ya que no tienen más pasos de evaluación.
  • Cumple la expansión de sujeto. Esto es interesante. Si damos un paso de evaluación marcha atrás, el tipo también se mantiene.
  • Estas propiedades nos llevan a la gran característica definitoria del sistema CD: Un término es tipable si y sólo si su evaluación acaba sea cual sea la estrategia de evaluación (es fuertemente normalizable).

Esta última propiedad no es buena. Y no lo es porque significa que no podemos darle un tipo a expresiones de la forma

[$$ K x y = x $$]
[$$ K\; 3\;((\lambda z. z z)(\lambda z. z z)) $$]

La función K (el combinador K) descarta su segundo parámetro, por lo que el término debería tener tipo entero (el resultado es 3). Sin embargo, no es tipable porque el segundo argumento nunca termina su evaluación. Este término no es fuertemente normalizable, es sólo normalizable de cabeza.

El sistema de Coppo-Dezani-Venneri

La solución es añadir una constante ? que significa "cualquier cosa". Sería vista como la intersección nula o como el elemento neutro de la intersección.

[$$ \omega \cap X = X $$]
[$$ X \cap \omega = X $$]

Al añadir las reglas apropiadas para introducir esta constante, los autores del sistema CDV se vieron forzados a separar los tipos en dos niveles. El nivel de tipo simple y el nivel de intersección (o secuencia) de tipos.

[$$ \tau ::= X\;\mid\;\omega\;\mid\;\sigma \rightarrow \tau $$]
[$$ \sigma ::= \tau_1 \cap \cdots \cap \tau_n\qquad (n>0) $$]

Con este sistema, las propiedad principal es que se puede asignar un tipo a los términos con forma normal de cabeza.

El sistema de Barendregt-Coppo-Dezani

El problema de los tipos restringidos del sistema CDV se soluciona introduciendo una relación de subtipo. Esto es así porque en posición covariante las intersecciones distribuyen.

[$$ A\rightarrow (B\cap C)=(A\rightarrow B)\cap(A\rightarrow C) $$]

Introduciendo una relación de subtipo que sea un preorden se puede derivar una clase de equivalencia y trabajar con el orden parcial generado en el conjunto cociente.

Este sistema es bastante más complejo. La relación de subtipo tiene hasta ocho reglas. La relación de tipado tiene seis reglas.

El sistema BCD tiene la misma potencia que el CDV. Sin embargo tiene un gran fallo: existen varias formas de demostrar que una expresión tiene un tipo. Las reglas no son dirigidas sintácticamente.

A pesar de todo esto, el sistema BCD es el más conocido y usado de los sistemas de tipos intersección.

sábado, 3 de abril de 2010

Las proyecciones de Futamura

Parcialización

En los lenguajes funcionales acostumbramos a escribir las funciones currificadas. No se escribe algo como

[$$ f(x,y) $$]

que sería una función con tipo

[$$ f :: X \times Y \rightarrow R $$]

Este tipo significa que f es una función que toma un par de árgumentos y devuelve un resultado. De hecho, se usa el tipo producto de X por Y (producto cartesiano).

Lo que se suele escribir es

[$$ f x y $$]

que significa realmente

[$$ f(x)(y) $$]

y cuyo tipo es

[$$ f :: X \rightarrow (Y \rightarrow R) $$]

Este tipo indica que f es una función que toma un argumento y devuelve otra función que toma el siguiente argumento y que, por fin, devuelve el resultado.

A pasar del primer caso al segundo se llama currificar la función.

Si en vez de escribir

[$$ f x y $$]

que nos da el resultado, escribimos

[$$ f x $$]

obtenemos una función que toma un argumento "y" y devuelve el resultado. El tipo de f x es

[$$ f x :: Y \rightarrow R $$]

A esta función se la llama una parcialización o una evaluación parcial de f. De cierta forma, lo que hacemos es calcular un caso particular de f para cuando sabemos el valor x.

Parcialización explícita

Generalmente parcializamos cuando no introducimos todos los argumentos que la función requiere. Esta parcialización se realiza de forma automática. En parte gracias a la nomenclatura. Sin embargo, esto no suele ser así a la hora de computar realmente. Lo que se suele hacer es usar una función auxiliar que llamaremos "mix" y que obtiene la parcialización de una función con su primer argumento.

En notación matemática:

[$$ f(x,y)=r $$]
[$$ mix(f,x)=p $$]
[$$ p(y)=r $$]
[$$ mix(f,x)(y)=r $$]

De esta forma hemos hecho explícita la parcialización de la función f.

Turing completitud

Una de las características de los modelos de computación tales como el lambda cálculo, la máquina de Turing o un ordenador, es que se pueden simular a sí mismos. Entonces decimos que ese modelo es Turing completo.

Antes de nada, empezaremos viendo cómo funciona un programa cuando queremos ejecutarlo. La idea es que tenemos el programa "prog" y se lo pasamos a otro programa "interp" para que lo interprete. Generalmente también le pasamos una entrada "entrada" y el resultado es una salida.

Todo esto se puede poner en notación metemática ya que, grancias a la Turing completitud, el intérprete no es más que un programa.

[$$ interp(prog, entrada)=salida $$]

Las proyecciones de Futamura

En este punto fue cuando a Futamura (por cierto, significa "dos villas") se le ocurrió parcializar. El resultado es que obtenemos una compilación del programa.

[$$ interp(prog,entrada)=mix(interp, prog)(entrada)=salida $$]
[$$ mix(interp, prog)=compilado $$]
[$$ compilado(entrada)=salida $$]

Esta es la primera proyección de Futamura: La parcialización de un intérprete y un programa es el programa compilado.

Pero este buen hombre no quedó ahí, vio que ¡mix también puede parcializarse!

[$$ mix(interp, prog)(entrada)=mix(mix, interp)(prog)(entrada)=salida $$]
[$$ mix(interp,prog)=mix(mix, interp)(prog)=compilado $$]
[$$ mix(mix, interp)=compilador $$]
[$$ compilador(prog)=compilado $$]
[$$ compilado(entrada)=salida $$]

Así que mix(mix, interp) no es más que el compilador relacionado con el intérprete "interp". Esta es la segunda proyección de Futamura.

Pero podemos seguir y obtener

[$$ mix(mix, interp)(prog)(entrada)
=mix(mix,mix)(interp)(prog)(entrada)=salida $$]
[$$ mix(mix, mix)(interp)=compilador $$]
[$$ compilador(prog)=compilado $$]
[$$ compilado(entrada)=salida $$]

Así que llegamos a la tercera y última proyección de futamura. Es un generador de compiladores que, dado un intérprete, obtiene el compilador correspondiente.

[$$ mix(mix, mix)=generador $$]
[$$ generador(interp)=compilador $$]

jueves, 11 de marzo de 2010

Polimorfismo paramétrico

El polimorfismo paramétrico aparece de forma natural en la programación. El caso más simple es la función identidad.

[$$ \lambda x.x $$]

¿Cuál es el tipo de esta función? Realmente, depende de lo que sea el tipo de su argumento. Si es un real, la función será Real->Real. Si es un natural, será Natural->Natural. Si es una cadena Cadena->Cadena.

Esto se puede agrupar con la idea de los tipos universales: Para todo tipo X el resultado es X->X. Lo que se escribe así.

[$$ \forall X.X\rightarrow X $$]

Obviamente, según el tipo que deseemos usar, especializamos. Así de 

[$$ \forall X.X\rightarrow X $$]

pasamos a

[$$ Real \rightarrow Real $$]

Cuando especializamos X a un real. Pero, ¿podemos especializar X a lo que queramos? ¿Incluso al propio tipo universal? La respuesta es que sí. Es un caso de impredicación en el cual cuantificamos la propia sentencia en la que está el cuantificador. Es decir, que podríamos pasar a especializar

[$$ \forall X.X\rightarrow X $$]
[$$ (\forall X.X\rightarrow X)\rightarrow (\forall X.X\rightarrow X) $$]
[$$ (((\forall X.X\rightarrow X)\rightarrow (\forall X.X\rightarrow X))\rightarrow

((\forall X.X\rightarrow X)\rightarrow (\forall X.X\rightarrow X)))\rightarrow
(((\forall X.X\rightarrow X)\rightarrow (\forall X.X\rightarrow X))\rightarrow
((\forall X.X\rightarrow X)\rightarrow (\forall X.X\rightarrow X))) $$]

Y así, infinitamente.

Las estructuras infinitas no son malas de por sí. A menos que quieras recorrerlas enteras. En ese caso vas a tardar un tiempo infinito. Esto es la indecibilidad. Una forma de evitarlo es dividir los tipos en dos. Los esquemas con los para todos y los tipos monomórficos sobre los que se predica.

Esta separación de los tipos en dos niveles es lo que hacen los sistemas de tipos al estilo ML o  de polimorfismo let. Aunque esa será historia para otro post.

miércoles, 21 de octubre de 2009

Lo que nunca me enseñaron: las PEGs

Introducción

Una de las asignaturas que más me gustó de la carrera de informática fue la de procesado de lenguajes. Se dividía más o menos en dos partes. La primera se centraba en los distintos algoritmos que hay de reconocimiento de lenguajes y la segunda en la semántica de ese lenguaje.

La primera parte era muy formal. Muchas matemáticas. La clasificación de los lenguajes de Chomsky. Los algoritmos para reconocer los lenguajes de contexto libre deterministas: expresiones regulares, LL(1), LL(k), LR(1), SLR, LALR, etc. La mayoría de estos algoritmos son complejos. Hay que calcular conjuntos, hacer grafos, transformarlos y aplicar métodos más o menos arduos.

Sin embargo, con el tiempo, he descubierto que no me enseñaron nada sobre las PEGs. Quizás únicamente una breve mención a los analizadores descendentes recursivos. Las PEGs son "gramáticas de expresiones reconocedoras" (Parsing Expression Grammars). La idea es muy simple: Probamos una cosa y, si no podemos, probamos con la siguiente.

La gran diferencia

Para reconocer una cadena como "a" en una entrada como "ac" se compara carácter a carácter. El resultado será que hay una parte reconocida "a" y sobra la "c". Una forma de asegurarnos que no sobran caracteres es añadiendo un indicador de fin de entrada. En este caso la cadena a reconocer sería "a#" y la entrada sería "ac#". Obviamente, no reconocería nada. Este truco permite centrarnos en reconocer sólo lo que se pueda reconocer y dejar sobrantes si fuera necesario.

Generalmente queremos reconocer varias cadenas. Aquí es donde las PEGs son distintas. En una gramática de contexto libre (GCL) las opciones no se ordenan. Las distintas opciones se separan con | en las GCL y se lee más o menos como "o". Es decir, "a" | "ab" sería reconoce "a" o reconoce "ab". Si introducimos la cadena "abc" reconocerá "ab" y sobra "c".

Con las PEGs no es así. Hay que reconocer ordenadamente. Las distintas opciones se separan con / en las PEG y se lee más o menos como "y si no, prueba con". Es decir "a" / "ab" sería prueba "a" y si no, prueba con "ab". Si introducimos la cadena "abc" probará primero con "a" y la reconocerá, descartando probar con "ab". Es decir que reconoce "a" y sobra "bc".

Las consecuencias de este cambio son dobles:

  • Dependiendo del orden obtenemos gramáticas distintas. Es decir, "a"/"ab" no es lo mismo que "ab"/"a".
  • Nunca hay ambigüegades. Esto es debido a que, si hay dos posibilidades, una estará delante de la otra.

Operadores

La restricción del orden puede parecer muy inconveniente, pero realmente no perdemos mucha expresividad respecto a una CFG. Por ejemplo, todos los operadores unarios de las expresiones regulares pueden expresarse con PEGs mediante estas transformaciones.

R = A*  ===> R = A R / ε

R = A+  ===> R = A R / A

R = A?  ===> R = A / ε

Donde ε es la cadena vacía.

Además, tenemos dos operadores más que surgen de la forma en las que las PEGs se implementan.

Cuando tenemos dos opciones la implementación de la PEG tiene que probar la primera. Si se reconoce, no hay problema. Se consume e ignoramos las otras opciones. Así que para reconocer "a" / "b" en "ac" sería:

"a" / "b"  en "ac"

Opción 1:

"a" en "ac". Coinciden las "a". Avanzo.

"" en "c". Nada más que comprobar. Éxito.

Si no se reconoce, hay que volver atrás (backtracking).

"ab" / "ac" en "acd"

Opción 1:

"ab" en "acd". Coinciden las "a". Avanzo.

"b" en "cd". No coinciden. Fallo.

Vuelvo atrás a "acd" y pruebo opción 2:

"ac" en "acd". Coinciden las "a". Avanzo.

"c" en "cd". Coinciden las "c". Avanzo.

"" en "d". Nada más que comprobar. Éxito.

Esta vuelta atrás tiene que usarse si utilizamos las opciones ordenadas /. Ya que la tenemos, podemos utilizarla en otros casos. Por ejemplo. Supongamos que queremos reconocer todas las palabras (no vacías) formadas por "a" y "b" excepto las que empiecen por "baba". Las palabras formadas por "a" y "b" son ("a" / "b")+. ¿Cómo le quitamos ahora "baba"?

La idea es simple. Intentemos reconocer "baba" y, si la encontramos, fallamos. Si no la encontramos, volvemos atrás y seguimos como si nada. Esta operación la notaremos con el operador prefijo ! La gramática sería:

!"baba" ("a" / "b")+

Si introducimos "babab" reconoceremos "baba" y por tanto, fallamos. No reconocemos la gramática. Si introducimos "babb" no reconocemos "baba" aunque habremos consumido "bab". No pasa nada, volvemos atrás a "babb" y seguimos como si nada.

La misma operación se podría realizar fallando si no reconocemos. En este caso se notaría "&". Por ejemplo, reconocer &"bxx" "b" en "bxxba" tiene éxito, pero sobra "xxba". Es una manera de requerir cierto contexto (las "xx" que siguen a la "b") antes de aceptar (sólo la "b").

Implementación

Existe una última característica de las PEG que las hace infinitamente mejores que las CFG: se pueden programar a mano. Nada de Lex/Yacc. Esto se debe a que las PEG son, ni más ni menos, que los reconocedores descendente recursivos.

Por ejemplo. En C++ una regla R = A B sería algo como:

bool R(POSICION& p)

{

return A(p) && B(p);

}

La regla R = A / B es:

bool R(POSICION& p)

{

POSICION q=p; //Prepara el backtracking

return A(p) || B(p=q);

}

Una regla R=A* es

bool R(POSICION& p)

{

POSICION q=p; //Prepara el backtracking

while(A(q)) p=q;

return true;

}

La regla R = &A B es

bool R(POSICION& p)

{

POSICION q=p; //Prepara el backtracking

return A(q) && B(p);

}

Como se ve, las reglas se programan más o menos directamente con un par de variables bien escogidas. En la realidad es algo más complejo porque queremos informar de errores, construir el AST, etc. Pero también es verdad que en la realidad podemos definir clases y abstraernos de más operaciones. El resultado es que la implementación suele ser directa.

El ataque de las ratas

Al leer la palabra "backtracking" deben haberse encendido todas las luces rojas de la complejidad. El backtracking (o vuelta atrás) es de complejidad exponencial. Esto quiere decir que si introduzco una cadena con un carácter más de longitud el resultado puede tardar el doble en calcularse. Esto es inmanejable en la práctica y el efecto es "se ha quedado colgado".

No hay que asustarse. En la realidad las PEGs se pueden calcular en tiempo lineal. Sí, sí. Lineal, O(n) para los amigos de la notación O de Landau. ¿Y cómo es posible esto? Mediante una técnica que se denomina memoización.

La memoización no es más que guardar en una tabla los resultados que ya conocemos de manera que, antes de calcularlos, busco en la tabla. ¿Que ya están? Pues tengo ya lo que buscaba. ¿Que no están? Pues los calculo y los guardo en la tabla para la próxima. El resultado es que sólo tengo que calcular cada regla en cada posición una única vez. Esto es lo que en diseño de algoritmos se denomina programación dinámica.

Como el número de reglas es fijo y las tablas hash son de complejidad amortizada constante el resultado es que la complejidad sólo depende linealmente de la longitud de la entrada. Es decir, O(n). Bien es verdad que también el consumo de espacio va a ser O(n), pero hoy en día la memoria disponible en los PCs normales permite usar las PEGs sobre ficheros de millones de caracteres.

¿Y lo de las ratas? Bueno, a este tipo de reconocedores descendentes recursivos con memoización se los denomina "packrat" que, aunque mis conocimientos de inglés me dicen lo contrario, me suena a "paquete de ratas".


Edit: Ya lo he descubierto. Podemos traducir "packrat" como "atesorador" ya que coincide la idea de memoizar con la definición de "packrat" que he encontrado en Babylon.

lunes, 24 de agosto de 2009

Estrategias de evaluación

Estrategias de evaluación

Una de las cosas interesantes en la computación es que un mismo cálculo se puede efectuar de muchas maneras ¡incluso cuando es el mismo programa!

Un ejemplo sería el siguiente:

f(x)= 2*x

g(x)= 3*x

g(f(4)) = ?

Hay dos maneras de proceder. La primera sería pensar "como no conozco f(4), voy a calcularla y luego la sustituyo".

f(4)=2*4=8

g(f(4))=g(8)

Otra manera de pensar sería "como sé cómo funciona g, voy a usar esa receta haya lo que haya en su argumento".

g(f(4))=3*f(4)

Esto, que parece una tontería, tiene hasta varios nombres. La primera forma de proceder es lo que se llama el orden aplicativo, evaluación estricta o paso por valor de los argumentos. La segunda forma de proceder es lo que se llama el orden normal o paso por nombre de los argumentos.

Computaciones infinitas

¿Realmente merece la pena tanto follón por esta sutileza? La respuesta es que, si los programas de ordenador no se colgasen, no importaría. Pero los programas de ordenador pueden entrar en computaciones infinitas que no acaban.

Supongamos una función que no acaba ω(x). Es mejor nunca calcularla porque no vamos a terminar. Ahora, supongamos una función constante que ignora su argumento y siempre retorna 7. Es decir:

constante(x)=7

¿Qué ocurre si calculo  constante(ω(1))? Si uso el orden normal he de sustituir sin ver lo que hay dentro de los argumentos y, por tanto

constante(ω(1))=7

He llegado al resultado. Si uso el orden aplicativo, he de calcular primero los argumentos.

constante(ω(1))=constante( ...y se queda colgado calculando ω

No puedo calcular el valor de ω porque no termina. Así que dependiendo de la estrategia de evaluación que use podré o no podré calcular ciertos valores.

De la pereza y otros vicios

El orden normal es magnífico porque no evalúa lo que no tiene que evaluar, pero es muy ineficiente. Esto lo vamos a comprobar en el siguiente ejemplo en el que hemos definido la función h y usamos el orden normal:

h(x)=x*x*x*x

h(f(3))=f(3)*f(3)*f(3)*f(3)

Hemos de calcular f(3) cuatro veces cuando realmente sólo hacía falta una. Esto con el orden aplicativo no habría ocurrido:

h(f(3))=h(6)=6*6*6*6

La solución es modificar ligeramente el orden normal para obtener lo que se llama la evaluación perezosa (hay diversos tipos, este es uno de ellos). La evaluación perezosa registra cuando una misma expresión se usa en varios sitios a la vez de manera que, cuando se evalúa una de esas expresiones, automáticamente todas pasan a tener el valor del resultado. En el caso de arriba sería:

h(f(3))=f(3)*f(3)*f(3)*f(3)=6*6*6*6

He puesto en gris las copias que no se calculan sino que se ponen con el resultado que da la copia que sí se evalúa (en negro). De esta manera, se evitan los problemas de la evaluación estricta y del orden normal.

Como detalle final, existen otras estrategias de evaluación: paso por referencia, paso compartido, expansión de macros, etc. Hay un interesante (aunque algo confuso en algunos aspectos) artículo en la wikipedia.