Mostrando entradas con la etiqueta teoria de tipos. Mostrar todas las entradas

domingo, 19 de mayo de 2013

Álgebras y coálgebras

He encontrado varias veces por Internet la pregunta de qué es un coálgebra y las respuestas han sido más o menos liosas. El motivo es que en computación al hablar de (co)álgebras nos referimos a las F-(co)álgebras. Lo que implica explicar qué es la F y esa F es un funtor. Un funtor es una operación en categorías y hay que introducir parte de la teoría de categorías para explicarlo.

Puede hacerse más simple.

El producto cartesiano generalizado

Estrictamente hablando el producto cartesiano es una operación entre dos conjuntos.[$$A\times B$$]El resultado es otro conjunto y sus elementos son los pares ordenados de forma que el primer elemento se obtenga del primer conjunto y el segundo elemento del segundo. En notación matemática:[$$A\times B = \{ (a,b) \mid a\in A, b\in B \}$$] Cuando hacemos dos productos cartesianos, surge la duda de si es asociativo o no.[$$A\times (B \times C) \overset{?}{=} (A\times B)\times C$$] En general el producto cartesiano no es asociativo, ya que [$(a,(b,c))\ne((a,b),c)$], pero nada impide usar un producto cartesiano generalizado (que escribiré entre paréntesis) en el cual el producto de tres conjuntos no sean pares, sino triplas. [$$(A\times B \times C) = \{ (a,b,c) \mid a\in A, b\in B, c\in C \}$$] El de cuatro conjuntos serían cuadruplas y el de [$n$] conjuntos lo que llamaremos [$n$]-tuplas. [$$(A_1\times\cdots\times A_n) = \{(a_1,\dots,a_n) \mid a_1\in A_1,\dots,a_n\in A_n \}$$] Usaremos este producto cartesiano generalizado.

Antes de acabar este apartado sólo resta destacar un caso particular. El del producto cartesiano de cero conjuntos. Llamaremos a este conjunto [$1$] y sólo contiene un elemento que es la tupla vacía [$()$].

Esta definición no debe ser extraña si seguimos la siguiente secuencia. [$$(A\times B \times C) = \{ (a,b,c) \mid a\in A, b\in B, c\in C \}$$][$$(A\times B) = \{ (a,b) \mid a\in A, b\in B \}$$][$$(A) = \{ (a) \mid a\in A \}$$][$$1 = \{ () \}$$]

Algebras

La idea de usar álgebras proviene de tomar un tipo de datos como sus valores y las operaciones que los construyen por inducción. Por ejemplo, en el caso de una lista, estos constructores serían.
  • La lista vacía. Lo que se ha venido a llamar la constante nil.
  • Añadir un elemento a la lista. Función que se llama cons.
Las constantes se expresan como funciones que no toman argumentos (mejor dicho, toman la tupla vacía), por lo que si la lista es de enteros y llamo al tipo de esta lista [int], el tipo de cada una de estas funciones sería: [$$nil : 1 \to [int]$$]Que no toma argumentos y devuelve la lista de enteros vacía y[$$cons : (int \times [int]) \to [int]$$]Que toma un entero y una lista de enteros y devuelve otra con este elemento añadido.

Teniendo en mente estas funciones, decimos que el tipo lista de enteros [int] no es más que el conjunto de sus valores (que llamaré [$A_{[int]}$]) y las dos funciones que los construyen por inducción. [$$(A_{[int]}, nil : 1\to[int] , cons : (int \times [int]) \to [int] )$$]Muy similar a, por ejemplo, un monoide [$$(M,e:1 \to M ,\otimes:(M\times M)\to M )$$] donde [$M$] son los elementos del monoide, [$e$] el elemento neutro y [$\otimes$] la operación interna. O a la definición de los números naturales[$$(N,cero:1\to N, suc:N \to N)$$] donde [$cero$] es la constante cero y [$suc$] la operación que obtiene el siguiente número natural (el sucesor).

Generalizando de nuevo, vemos que todas estas definiciones tienen siempre la misma estructura.[$$(A, f_1: X_1 \to A,\dots, f_n: X_n \to A)$$]Donde los [$X_i$] son productos cartesianos de conjuntos en los cuales puede estar el propio [$A$] o no.

Bien. Eso es un álgebra. Un conjunto y varias operaciones cuyo codominio es tal conjunto.

Coálgebras

En un coálgebra lo que tenemos es [$$(A, f_1: A\to X_1,\dots, f_n: A\to X_n)$$] En este caso las operaciones tienen el conjunto en su dominio.

¿Qué significado tiene esto?

Pensemos en una lista. La operación cons tomaba una lista y un elemento e introducía ese elemento en la lista.

cons(7,[1,2,3])=[7,1,2,3]
cons(9,[8,1,3])=[9,8,1,3]
cons(4,[])=[4]

El tipo de cons era [$(int\times [int])\to [int]$]. En una coálgebra la operación correspondiente (que llamaremos headtail) deberá tener el tipo [$[int]\to(int\times [int])$] lo que significa que de una lista obtenemos un elemento y otra lista. Una forma de ver esto es pensar que, en la coálgebra, la operación headtail extrae un elemento de la lista. En general, las operaciones de una coálgebra deshacen lo que los constructores hacían en las álgebras. Por esta razón a las operaciones de una coálgebra se las denomina destructores.

headtail([1,2,3])=(1,[2,3])
headtail ([8,1,3])=(8,[1,3])
headtail ([])=????

¿Qué pasó en este último ejemplo? ¿Es realmente headtail una función sobre las listas o sólo sobre las listas no vacías?

Existen dos respuestas aquí.

La primera respuesta es introducir los tipos suma. De esa manera, headtail podría devolver un error sumando el conjunto unidad al tipo de su codominio ([$headtail: [int]\to 1+(int\times [int])$]). Esto es dual a la agrupación de todas las operaciones del álgebra de la lista en una única operación sumando sus dominios ([$nilcons: 1+(int\times [int])\to [int]$]) y por esta vía definimos el funtor polinómico [$F X = 1+(X\times [X])$] y llegamos a las F-(co)álgebras que es de lo que realmente estamos hablando.

Aún introduciendo la posibilidad de que headtail acabe de leer una lista, no significa que lo haga. Usar coinducción permite trabajar con listas infinitas en las cuales siempre podemos ir extrayendo elementos. Esto nos lleva a...

La segunda respuesta es modificar nuestro tipo de datos y decir que no trabajamos con listas, sino con listas infinitas (los llamados streams). Como la lista es infinita, nunca va a estar vacía y siempre podremos usar headtail. Estos tipos de datos infinitos definidos por coálgebras y coinducción se denominan codatos. Son útiles para modelar, por ejemplo, la entrada del usuario que, en principio, nunca acaba.

viernes, 28 de octubre de 2011

El combinador Y en C++ (y II)

La primera parte de esta serie está aquí.

Como se comentó en la primera parte, el combinador Y toma una función g que representa un paso de recursión y devuelve una función p que es el punto fijo de g. Esto del punto fijo no es más que la función recursiva obtenida aplicando g a sí misma infinitas veces. El problema con este planteamiento es que currificar en C++ es difícil. Por esta razón usaremos una versión de g que no esté currificada. El prototipo de esta función sería:
#include <functional>

int g(std::function<int(int)> f,int v);
El tipo de los objetos función en C++ es muy largo y escribir "std::function" cada vez va a emborronar el código. Usaré una macro para aligerar la notación.
#include <functional>

//F(X,Y) es X->Y
#define F(X,Y) std::function<Y(X)>

//F(X,Y,Z) es (X,Y)->Z
#define F2(X,Y,Z) std::function&lg;Z(X,Y)>

int g(F(int,int) f,int v);
Ahora vamos a tratar de definir el combinador Y. La mejor forma de hacerlo es, en vez de usar las funciones lambda de C++ que son muy tediosas, usando la ecuación recursiva que obtuvimos en la primera parte.

Y(g)=g(Y(g))

Como ahora tengo a g sin currificar, he de añadir un argumento extra. Queda así:

Y(g)=[](x){g(Y(g),x)}

Entonces, el código del combinador Y para los enteros sería

F(int,int) Y(  F2( F(int,int) ,int,int)  f)
{
    return [=](int x){return f(Y(f),x);};
}

Realmente la parte difícil es la de los tipos, aunque se pueden obtener poco a poco estudiando la expresión.

Cambiar los int por un tipo genérico nos da el combinador Y genérico en C++:

template<typename T>
F(T,T) Y(  F2( F(T,T) ,T,T)  f)
{
    return [=](T x){return f(Y(f),x);};
}

Ahora sólo tenemos que usarlo. Definimos para eso la función g del factorial y lo volcamos a la salida. El código final es el que sigue:

#include <functional>

#include <iostream>

//F(X,Y) es X->Y
#define F(X,Y) std::function<Y(X)>
 

//F(X,Y,Z) es (X,Y)->Z
#define F2(X,Y,Z) std::function&lg;Z(X,Y)>

int g(F(int,int) f,int v)
{
    return v==0 ? 1 : v * f(v-1);
}

template<typename T>
F(T,T) Y(  F2( F(T,T) ,T,T)  f)
{
    return [=](T x){return f(Y(f),x);};
}

int main(int argc,char** argv)
{
std::cout << Y<int>(g)(5) << std::endl;
    return 0;
}

En este punto sólo queda advertir al lector que es necesario usar un compilador compatible con el estándar de C++ de 2011.

miércoles, 11 de mayo de 2011

El punto de la pereza

Hace unos días Bob Harper, que defiende SML con uñas y dientes, se dedicó a atacar a los elitistas del Haskell. Su idea era muy sencilla: los tipos de Haskell no son inductivos. Voy a intentar explicar esto de forma sencilla.

Tipos inductivos

Son los tipos cuyos valores se construyen con unos valores bases y unos constructores. El caso arquetípico son los números naturales.
  • El 0 es un valor base.
  • El siguiente número natural S(n), es un constructor que, dado un número, construye otro.
Con esto y la inducción estructural tenemos los números naturales (y podemos demostrar propiedades sobre ellos).
  • El cero es 0
  • El uno es S(0)
  • El dos es S(S(0))
  • Y así.
También es posible usar como argumento de un constructor el valor de otro tipo. Este otro tipo será un parámetro del nuevo tipo. De esa manera aterrizamos en los tipos algebraicos. Por ejemplo, las listas de valores de un tipo T que llamaremos L(T) será.
  • La lista vacía [] es un valor base.
  • El constructor de lista  cons(V,R) toma un valor V de un tipo T y el resto de la lista R de tipo L(T).
Con esto y la inducción estructural, obtenemos las listas que queramos (y podemos demostrar propiedades sobre ellas).
  • Tomamos la lista vacía [] como valor base de una lista de enteros L(int)
  • Añadimos  un entero  cons(-3, [])
  • Añadimos otro entero  cons(7, cons(-3, []) )
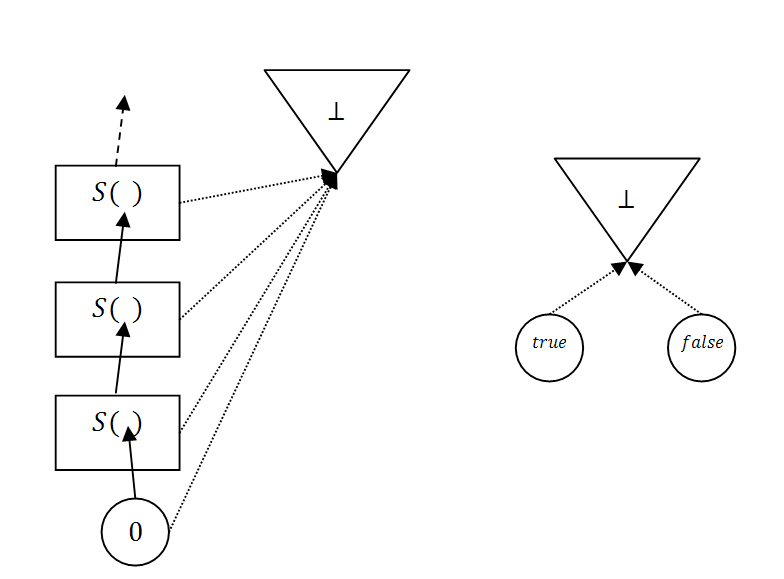
Todos estos tipos inductivos tienen una forma muy similar si se dibujan: son bosques de árboles (matemáticamente son órdenes parciales completos, también llamados dominios). En concreto, los números naturales son un árbol de una única rama.
Los números naturales son inductivos. El valor base es el 0, en un círculo, y el constructor es S(n), en rectángulos. De esta manera tenemos representados en la figura, de abajo arriba, los valores 0, S(0), S(S(0)), S(S(S(0))) y así sucesivamente.
Los booleanos son dos árboles sin ramas.
Los booleanos son dos valores base: true y false. No hay constructores. Estos tipos sin constructores suelen llamarse tipos enumerados.

Las listas de naturales son árboles con infinitas ramas ya que, cada vez que usamos un constructor con un natural distinto, generamos una nueva rama. Es difícil dibujar esto porque cada una de las infinitas ramas lleva a infinitos valores que, a su vez, vuelven a tener infinitas ramas. Con un poco de imaginación el diagrama sería algo así.
Lista de naturales. La lista vacía es el valor base [] que está abajo. A partir de él construimos infinitos valores, uno para cada natural. Serían las listas de un único natural. Asimismo, de cada uno de estos valores se obtienen otros infinitos valores. A este tipo de árboles infinitos pero con una estructura simple se los denomina árboles regulares.

Existen también los llamados tipos coinductivos en los cuales, en vez de tener una lista vacía (valores base) y usar constructores sobre ella, tenemos una lista llena (valores co-base) y usamos destructores (co-constructores) sobre ella. No hablaré mucho más de esto aquí.

Evaluación perezosa 

La evaluación perezosa, de la que hablamos alguna que otra vez, consiste básicamente en no evaluar hasta que no sea estrictamente necesario. Un caso clásico es la multiplicación por cero.

0*(7+5)

¿Para qué sumar siete y cinco si sabemos que al final la multiplicación va a ser cero? Bueno, existe un motivo por el que evaluar los argumentos y son los efectos laterales. Si en vez de sumar dos números imprimiésemos un mensaje, la cosa cambia.

0*(print "hola") 

Ahora sí que habría que imprimir "hola" aunque el resultado de esta multiplicación (si es que print devuelve un número, claro) sea cero. Pues bien, ocurre que en Haskell no hay efectos secundarios. Es un lenguaje funcional. En este lenguaje de programación sí que conviene no perder tiempo evaluando cosas que, al final, no se van a usar.

La idea fundamental de la crítica de Harper es que siempre existen los efectos secundarios. En concreto existe un efecto secundario que jamás puedes quitarte de encima en un lenguaje de programación Turing completo. Ese efecto es... que la computación no termine.

Imaginemos el siguiente programa:

f(x) = 1+f(x)  //Esta computación no termina 
0*f(3) 

Si el lenguaje es estricto y evalúa f(3), nunca llega a ejecutar la multiplicación. Si el lenguaje es perezoso y no evalúa f(3), la multiplicación ha aceptado un valor que no es un número (de hecho ni siquiera es un valor, es no terminación) y lo ha tratado como si fuera un número. ¿Cuál es el tipo del argumento que ha aceptado la multiplicación?

Los lenguajes con evaluación perezosa cuelan entre los valores de sus tipos la no terminación. O mejor dicho, algo todavía sin evaluar que puede ser no terminación o puede ser un valor concreto. Este valor tan especial que se puede convertir en otro (o no) se corresponde con el mínimo de un orden parcial completo con mínimo. Este mínimo tiene el nombre de "punto" y se suele representar con el símbolo [$\bot$].

Si añadimos el punto a los tipos inductivos el resultado es que ¡no son inductivos! Los naturales y los booleanos quedan algo así.
Los naturales y booleanos con punto. El punto representa la no evaluación (con la no terminación como posibilidad). El punto está más allá de la inducción. No se pueden usar técnicas inductivas para demostrar propiedades de él.
Esto rompe la posibilidad de usar la inducción estructural porque el punto queda más allá, más arriba, del resto de valores. Así que, según Harper, usar la evaluación perezosa es equivalente a olvidarse de la inducción estructural y, con ella, poder demostrar con facilidad múltiples propiedades en nuestro programa.

Epílogo

Por supuesto, esto es todo cuestión de compromisos. Usar evaluación perezosa abre la puerta a tener tipos coinductivos con mucha facilidad. De hecho la "lista llena" de la que hablé antes es precisamente el punto [$\bot$]. Una computación que puede no terminar, una lista infinita, de la cual vamos extrayendo valores, como los iteradores. Esto permite cosas nuevas como el uso de la composición en estos tipos coinductivos, lo que abre la posibilidad a la reutilización de código.

miércoles, 8 de diciembre de 2010

C++: Conceptos y traits

Toda esta entrada es una especie de resumen personal de la presentación de Bartosz Milewski que podéis ver aquí más algunas ideas extra de mi propia cosecha.

Conceptos mediante traits

Antes de nada hay que entender que los template en C++ no pueden compilarse inmediatamente porque no sabemos los tipos que vamos a tener cuando instanciemos el template.

El problema podría ser resuelto si forzamos a que estos tipos cumplan un contrato, una interfaz. La idea es hacerlo mediante los llamados conceptos. Por ejemplo, un tipo sobre el que podamos comprobar la igualdad, tendría un concepto parecido a este:

concept Eq<T>
{
 bool operator==(T const& l, T const& r);
}

Ahora podríamos agregar tipos que cumplen ese concepto mediante lo que se denomina una asignación de concepto (concept_map).

concept_map Eq<int>
{
 bool operator==(int const& l, int const& r) { return l==r; }
}

Hay que notar que el == de los enteros no es inmediatamente Eq ya que el concepto Eq podría significar algo más que "tiene igual". Podría significar "tiene igual y es reflexivo, simétrico y transitivo" por lo que sólo el programador sabe si puede o no hacer un concept_map en función de la semántica del concepto.

La idea es que ahora, en un template, se pueda usar el igual del concepto en vez del igual de la clausura dinámica.

template<Eq T>
T f(T const& a, T const& b)
{
 return a==b ? a : b;
}

El == este sería el del concepto Eq y no una función que haya que esperar a tener el tipo T para encontrarla en tiempo de instanciación. Por tanto, este template se podría comprobar estáticamente en declaración. Sin saber si T es un int u otra cosa.

La manera de implementar algo parecido en el C++ actual (aunque sin la ventaja de la comprobación en declaración) es mediante el uso de traits. En vez de tener Eq como un concepto (ya que el C++ actual carece de ellos) lo tendremos como una clase Eq<T> que significa "el tipo T es del concepto Eq". Para que el tipo T sea del concepto Eq deberá demostrarse que el operador == es parte de ese tipo.

template<typename T>
class Eq
{
public:
static bool operator==(T const& l, T const& r);
};

El concept_map no es más que una especialización demostrando que int se ajusta a lo requerido. El compilador de C++ actual no lo comprueba así que hemos de ser cuidadosos.

template<>
class Eq<int>
{
public:
static bool operator==(int const& l, int const& r) { return l==r; }
};

Finalemente, cuando usemos estos sucedáneos de conceptos, hay que usar la clase trait en vez de utilizar directamente el operador ==. En el caso de los conceptos puros el uso del == del concepto era implícito.

template<typename T>
void f(T a, T b)
{
return Eq<T>::operator ==(a, b) ? a : b;
}


Lo importante aquí es que es posible mediante esta técnica el separar la comprobación del template de su instanciación. Desafortunadamente, este conocimiento ha llegado a la comunidad de C++ unos veinte años después de que se estandarizaran los templates (como ya he comentado en una entrada anterior, incorrectamente). Aunque usemos Eq<T>::operator ==(a, b), el compilador tomará esta expresión como dependiente y no la comprobará estáticamente.

Extensión hipotética de C++

Esto no quiere decir que no se puedan introducir. Sólo quiere decir que hay que tener muchísimo más cuidado en cómo se hace puesto que interacciona con otras características del C++ de maneras indeseadas lo cual llevó a retirar los conceptos del estándar actual.

Una manera posible de introducirlo, pienso, sería subsanando las dos carencias que hemos comentado arriba.
  1. Comprobar que las especializaciones implementan el template general. 
  2. Evitar que se tomen como expresiones dependientes las que usen estos templates comprobados. 

Postulemos entonces una pequeña variación en C++ introduciendo unos templates cuyas especializaciones tengan que implementar su interfaz forzosamente. Usaremos la hipotética sintaxis abstract template.


abstract template<typename T>
class Eq
{
public:
static bool operator==(T const& l, T const& r);
};

Con esta hipotética sintaxis el compilador se quejaría de especializaciones como estas:

//ERROR: Eq<T> es abstract y su especialización Eq<int> no implementa ==
template<> class Eq<int>
{
public:
 static bool operator<(int const& l, int const& r) { return l<r; }
};

//ERROR: El segundo argumento de operator == no es de tipo adecuado.
template<> class Eq<int>
{
public:
 static bool operator==(int const& l, float const& r) { return l<r; }
};

Como el compilador sólo va a permitir las especializaciones que cumplan con el abstract template, tiene suficiente información para comprobar las expresiones que usen este abstract template, hayan sido especializadas o no. Por esta razón no es necesario que el uso de los abstract template sean dependientes.


template<typename T>
void f(T a, T b)
{
return Eq<T>::operator ==(a, b) ? a : b;
}


La expresión Eq<T>::operator ==(a, b), aunque depende de T, como lo hace a través de un abstract template, no es dependiente y se puede comprobar ahora. De hecho, se comprueba que operator== es miembro de Eq y tiene el tipo adecuado, por tanto, la función template f() es correcta. ¡Y lo sabemos antes de instanciar T!

Estas modificaciones que propongo son en principio seguras ya que si no introduces ningún abstract template todo sigue siendo compatible. No rompe ningún código. Son fáciles de realizar puesto que es añadir una pequeña regla en la definición de expresión dependiente y la comprobación de que se implementa una interfaz es bastante parecida a la de las funciones virtuales puras (aunque hay detalles y en los detalles está el diablo).

Otra cosa es que no cumpla todos los objetivos que se esperaban de los conceptos como su uso implícito. Vayamos por partes. Esto es un primer paso, veremos como solucionar el siguiente en otro momento.

Nota: Podríamos recurrir a la vinculación dinámica en vez de a un trait y tener

template<typename T>
class Eq
{
public:
 bool (*operator==)(T const& l, T const& r); //Sin static
};

Que se usaría así

template<typename T>
void f(Eq<T>& demo, T a, T b)
{
return demo.operator ==(a, b) ? a : b;
}

Ahora bien, ¿para qué retardar la decisión a tiempo de ejecución? Muy sencillo. Este cambio permite compilar el template y generar código. Esto es lo que se llama compilación separada y aceleraría los tiempos de compilación. Como siempre, hay un compromiso entre perder algo de tiempo de ejecución o perder algo de tiempo de compilación.

jueves, 30 de septiembre de 2010

El isomorfismo de Curry-Howard

Uno de los descubrimientos más impactantes en la lógica del siglo XX es el isomorfismo de Curry-Howard. También llamado la correspondencia de Curry-Howard o, como veremos inmediatamente, tipos como predicados.

Historia

Todo empezó cuando, en 1934, Haskell Curry se fijó en lo siguiente:

Si tengo una función f que toma un valor de tipo A y devuelve un valor de tipo B, su tipo lo escribiré como A -> B. Para indicar que f tiene ese tipo usaré los dos puntos f : A -> B y leeremos "f tiene tipo función de A a B". Escribiré los tipos en mayúsculas y los términos en minúscula. Para aplicar esa función a un término t arbitrario uso la siguiente regla de inferencia:

Si sé que f : A -> B y sé que t : A entonces puedo deducir que f(A) : B.

El golpe de genialidad de Curry consistió en quitar los términos y observar que los tipos solos conforman la regla de inferencia lógica del modus ponens.

Si sé que A implica a B y sé que A es cierto, entonces puedo deducir que B es cierto.

Tras años de trabajo, en 1958, Curry concluyó que no podía expresar la lógica proposicional clásica. Sólo una parte de ella llamada lógica intuicionista. En esta lógica no tenemos el principio del tercero excluido por lo que no podemos realizar demostraciones por reducción al absurdo.

Años más tarde, William Alvin Howard descubrió que no sólo se podía expresar la lógica proposicional intuicionista, sino un gran conjunto de lógicas intuicionistas incluidas las de primer orden y orden superior. Desde entonces se ha extendido aún más la correspondencia y se ha incluido la lógica clásica mediante el uso de continuaciones. De hecho, se han inventado lógicas gracias a la correspondencia.

Explicación

¿Pero cómo es posible que un tipo sea una proposición lógica? En todo caso un tipo es un conjunto de valores o de términos, pero ¿cómo expresar conjunciones o implicaciones? Aunque no lo parezca a primera vista, es relativamente fácil.

Por ejemplo, ¿qué significa cuando decimos 3 : int ? Que tres es un entero, sí. Pero también podemos decir que los enteros tienen algún habitante: existe un valor, el 3, que es un entero y por tanto los enteros no están vacíos. En este sentido el valor 3 sería la demostración de que los enteros están habitados. La proposición int significa "los enteros están habitados". Si nuestro lenguaje de programación no tuviera enteros, int sería falso. Si los tiene, int es cierto.

Entonces, los términos son, por un lado, valores de un tipo y, por otro, demostraciones de que ese tipo no está vacío. Que un tipo no esté vacío significa que, visto como proposición, tiene una demostración y por tanto es cierto en nuestro sistema o lenguaje de programación.

Seguimos: ¿Cómo demuestra una función una implicación? Viendo la regla modus ponens de arriba, la demostración de que B está habitado es f(t) así que lo que hace una función f es, dada una demostración t,  construye otra f(t). O como siempre se ha entendido, dado un valor devuelve otro. Por esta razón demuestra la implicación: dame una demostración de A que te doy otra de B. Si A es cierto, entonces B también.

Hasta ahora tengo predicados constantes como int e implicaciones como A->B. Introduciremos la conjunción A & B. Desde el punto de vista lógico si A & B es cierto es por que A es cierto y B es cierto. Si me pongo a trabajar con las demostraciones necesito la demostración de A y la demostración de B para tener la demostración de A & B. Llamemos a estas demostraciones a : A y b : B. Entonces, un término que agrupa ambas demostraciones es un par (a, b). Por tanto, el tipo conjunción no es más que el tipo de los pares (a, b) : A & B más usualmente llamado producto cartesiano.

De esta forma se pueden obtener todas las conectivas en gran cantidad de lógicas distintas y, lo que es más importante, se estandariza la forma de demostrar las proposiciones en dichas lógicas: Los programas son esas demostraciones.

Portada de las actas del congreso LICS'90, humorísticamente titulada el homeomorfismo de Curry-Howard. Los constructores de tipos (arriba) se transforman en las conectivas lógicas (abajo) de forma continua.
  
En acción

Para finalizar vamos a demostrar, usando programas como prueba, que A -> B -> C es lógicamente equivalente a (A & B) -> C. Para esto primero demostraremos ( (A & B) -> C) -> (A -> B -> C) y luego (A -> B -> C) -> ( (A & B) -> C).

λ f. (λ x. λ y. f (x, y) ) : ( (A & B) -> C) -> (A -> B -> C)
λ f. λ x. f (primero x) (segundo x) :  (A -> B -> C) -> ( (A & B) -> C)

Sólo hay que hacer notar que hemos usado las proyecciones de un par: primero (p, q) se evalúa a p y segundo (p, q) se evalúa a q. El resto de la demostración es obvia en el sentido de que el programa que proporciono tiene ese tipo que digo. Para comprobar eso harían falta ciertas reglas de inferencia, pero eso será para otro día.

lunes, 20 de septiembre de 2010

Intensión y extensión

Ya hemos hablado de la regla eta anteriormente, pero ahora vamos a relacionarla sintácticamente con el concepto de igualdad por extensión. El procedimiento de extensionalidad es siempre el mismo: si todos los casos particulares cumplen una propiedad, el caso general también. Por ejemplo, en la teoría de conjuntos la el axioma de extensionalidad dice algo así como
Todo par de conjuntos que contengan elementos iguales son conjuntos iguales.
En el caso de la computación, lo que tendríamos sería
Toda par de funciones cuyos resultados para cualquier entrada sean los mismos son funciones iguales.
Algo más matemáticamente sería decir que para todo
[$$ x $$]
si
[$$ f x =_\beta g x $$]
entonces
[$$ f =_{\beta\eta} b $$]
Lo interesante es que en el primer igual, con subíndice beta, estamos únicamente usando las definiciones y no la extensionalidad. Cuando usamos sólo las definiciones decimos que trabajamos intensionalmente. El segundo igual es distinto porque hemos usado la extensionalidad.

Lo más interesante de todo esto es que basta añadir la regla eta para que la igualdad intensional se convierta en extensional en el lambda cálculo. El problema es que esa simple regla introduce muchos quebraderos de cabeza a la hora de demostrar las propiedades de los sistemas que la usan.

La idea es bien sencilla. Como
[$$ f x $$]
se puede obtener mediante una beta-conversión desde
[$$ (\lambda y.f y) x $$]
y puedo decir que
[$$ f x =_\beta (\lambda y.f y) x $$]
Al aplicar extensión obtengo que
[$$ f =_{\beta\eta} \lambda y. f y $$]
Tomando la dirección que simplifica la expresión obtengo la eta-regla (como la variable que introduzco es fresca, no debe aparecer en f para poder aplicar la regla).

[$$ \lambda x. f x  \rightarrow f $$]

Basta añadir esta regla para comprobar si dos funciones son iguales (aunque se hayan definido de forma distinta). Esto no es inmediato ya que existen teoremas bien profundos para este tipo de igualdades extensivas. Afortunadamente la simplicidad del lambda cálculo permite automatizarlo (aunque recordemos que el lambda cálculo sin tipos puede no acabar la computación).

Resumiendo: tenemos tres tipos de igualdades.
  • Igualdad sintáctica. Dos términos son iguales si son el mismo. En el lambda cálculo hay cierto detalle y es que las variables se pueden renombrar. Esto es a lo que se llama la alfa-conversión. Llamamos entonces a los términos iguales sintácticamente alfa-equivalentes.
  • Igualdad intensional. Dos términos son iguales si, sustituyendo sus definiciones, son el mismo. En el lambda cálculo esto se consigue aplicando la regla beta. Por esta razón se llaman términos beta-equivalentes (aunque también son alfa-equivalentes y deberían llamarse alfa-beta-equivalentes).
  • Igualdad extensional. Dos términos son iguales si hagamos lo que hagamos con ellos obtenemos el mismo resultado siempre.  Se obtienen usando las reglas beta y eta. Por esta razón se llaman beta-eta-equivalentes (aunque también se use la alfa-conversión).
Como final, planteo un breve ejercicio: ¿cuáles de estos términos son iguales sintácticamente, intensionalmente o extensionalmente?

[$$ (\lambda x.\lambda y. x) 3 = \lambda y. 3 $$]
[$$ \lambda x.x = \lambda y.y $$]
[$$ \lambda x. 5*(x+2) = \lambda x. 5*x+10 $$]

miércoles, 16 de junio de 2010

La relación de subsunción

La letra a en el nombre está relacionada con la regla a del lambda cálculo ya que en esta regla también realizábamos un renombramiento de variables.

El conjunto cociente de a-equivalencias

A partir de ahora es fácil definir

[$$ M < N \Leftrightarrow M \le N \wedge M \not\approx N $$]

Y las relaciones simétricas >, =, etc.

Como la a-congruencia es una relación de equivalencia, notaremos [M] por la clase de equivalencia del término M (o clase de congruencia ya que estamos trabajando con congruencias).

Realmente el conjunto cociente T(A,V)/≈ agrupa en una misma clase los términos que son iguales excepto renombramientos de variables.

[$$ \left[ f(x) \right] = \left\{ f(x), f(y), f(z), ...\right\} $$]
[$$ \left[ g(h(1,z),y) \right] = \left\{ g(h(1,x),y), g(h(1,y),x), g(h(1,x),z), ...\right\} $$]

Es importante recordar que un renombramiento de variables no puede fusionar variables y por lo tanto el término g(h(1,x),x) no pertenece a la clase de equivalencia anterior. Esto es así porque no existe ninguna sustitución que pueda obtener el término original g(h(1,z),y) y por tanto no sería a-congruente.

La subsunción inducida

Si ignoramos los renombramientos de variables, la subsunción se convierte en un orden parcial. Esto es obvio ya que la antisimetría nos lleva directamente a la definición de a-congruencia y, dado que estamos trabajando en el conjunto cociente de esta relación, ambas clases de equivalencia van a ser la misma.

Formalmente esto lo haríamos extendiendo la subsunción al conjunto cociente obtenido por a-conversión. Esta nueva relación se denomina subsunción inducida en el conjunto cociente.

[$$ \left( \le, T(A,V)/\approx \right) $$]

Usaremos el mismo símbolo = para ambas relaciones ya que usualmente trabajaremos con la inducida en el conjunto cociente.

Es realmente importante ver que, dado que los términos son finitos, la subsunción inducida es Noetheriana. Es decir, no existe una cadena infinita

[$$ M_1 > M_2 > \cdots $$]

Esto significa que la subsunción inducida forma una semiretículo inferior Noetheriano y, por ciertos teoremas, debe ser también un semiretículo superior y un retículo completo.

El menor elemento del retículo es [x] ya que lo podemos sustituir por cualquier otro elemento y el superior es [O] que no puede ser sustituido más que por él mismo. Esta era una de las razones por las que nos interesaba introducir un elemento indefinido.

Supremo e ínfimo

Siempre que hablamos de retículos podemos aproximarnos a ellos desde dos perspectivas. Desde una relación de orden y desde las operaciones constituyentes de supremo e ínfimo (con las propiedades asociativa, conmutativa y absorción).

En el caso del retículo de la subsunción inducida el supremo (lo notaremos como una unión de conjuntos) es una unificación con variables disjuntas.

[$$ f(x,g(y)) \cup f(g(y), z) = f(g(w), g(v)) $$]

Probablemente explique algo de unificación más adelante. La idea de la unificación es buscar una sustitución que, aplicada a ambos términos, nos proporcione un mismo término final. En el caso especial de usar variables disjuntas, antes de realizar esta unificación hay que renombrar las variables para que sean todas distintas unas a otras.

El ínfimo (que notaremos como la intersección) es la antiunificación.

[$$ f(x,g(y)) \cap f(g(y),z) = f(x,y) $$]

Lo interesante de todas estas ideas es que, a partir de una definición muy simple de términos y sustituciones, obtenemos una estructura algebraica con unas propiedades bastante bien estudiadas como son los retículos completos.

domingo, 6 de junio de 2010

Formas normales

He descubierto un artículo donde aparecen muy bien explicadas las distintas formas normales del lambda cálculo. El artículo es este y se resume en la siguiente tabla:

Reduce bajo abstracciones

No reduce bajo abstracciones

Reduce argumentos

v ::= λx.v | x v1 … vn

Forma normal (NF)

v ::= λx.e | x v1 … vn

Forma normal débil (WNF)

No reduce argumentos

v ::= λx.v | x e1 … en

Forma normal de cabeza (HNF)

v ::= λx.e | x e1 … en

Forma normal débil de cabeza (WHNF)

He puesto entre paréntesis las iniciales de las formas normales en inglés (Normal Form, Weak Normal Form, Head Normal Form y Weak Head Normal Form).

El grupo sintáctico v es el de los términos que se consideran forma normal. El grupo sintáctico e es el de los términos del lambda cálculo. Éstos se definen así:

e ::= x | λx.e | e1 e2

Estas formas normales se usan luego para definir las propiedades de los términos. Por ejemplo, un término fuertemente normalizable (SF) es un término que, usemos la estrategia de evaluación que usemos, siempre alcanza una forma normal (NF).

Un término tiene forma normal si existe una estrategia de evaluación que llegue a esa forma normal. De hecho, las estrategias de evaluación están enfocadas a llegar a una forma normal en concreto. Las estrategias que siempre llegan a esa forma normal deseada se denominan estrategias normalizantes.

La siguiente tabla define las estrategias de evaluación más usuales según reduzcan los términos exteriores o interiores primero.

Forma normal deseada

Primero términos exteriores

Primero términos interiores

NF

Orden normal (Normalizante)

Orden aplicativo (No normalizante)

WNF


Llamada por valor (No normalizante)

WHNF

Llamada por nombre (Normalizante)


viernes, 28 de mayo de 2010

Sustituciones

Ya hablé del álgebra de términos, pero no dije nada de cómo se usaba y para qué servía. En este artículo voy a exponer una de las operaciones sobre esta álgebra: la sustitución.

Definición

Realmente, no debería llamarse sustitución, ya que no es una sustitución de "quito esto y pongo lo otro". Esto es así porque no vamos a cambiar términos por términos sino variables por términos. O sea, una sustitución es una aplicación de las variables en los términos.

[$$ \sigma : V\to T(A,V)
$$]

Lo interesante de esta aplicación es que puede extenderse de forma congruente a todo el álgebra de términos. Para eso introducimos una nueva aplicación extendida

[$$ \bar{\sigma} : T(A,V)\to T(A,V) $$]

Y la definimos para que mantenga la estructura de los términos así:

[$$ \bar{\sigma}(x)=\sigma (x) $$]
[$$ \bar{\sigma}(f(M_1,...,M_n))=f (\bar{\sigma}(M_1),...,\bar{\sigma}(M_n)) $$]

El conjunto de todas las sutituciones en T(A,V) lo escribiremos como S(A,V). Usualmente no se distingue entre la sustitución con y sin barra. En este artículo haremos la distinción para ser formales, pero en otros lugares sólo se usa s.

Dominio y restricción

Llamamos dominio de una sustitución al conjunto de variables que no se sustituyen por ellas mismas.

[$$ dom(\sigma)=\left\{x\in V\mid \sigma(x)=x \right\},\qquad \sigma\in S(A,V) $$]

Cuando el dominio sea infinito, la sustitución se llamará infinita. Generalmente cuando se habla de sustitución, sólo se hace referencia a las sustituciones no infinitas. Nosotros sólo consideraremos las sustituciones no infinitas.

La restricción de una sustitución a un subconjunto (finito) de variables se define así.

[$$ \sigma\mid_W(x)=\left\{\begin{matrix}
\sigma(x) & \Leftarrow x\in W\\
x & \Leftarrow x\not\in W
\end{matrix}\right.\qquad W\subset V
$$]

Para indicar una sustitución lo más sencillo es componer varias sustituciones simples. Una sustitución simple es la que tiene dominio unitario. Representaremos a estas sustituciones así:

[$$ \sigma=\left[ x \mapsto M \right] $$]

Donde

[$$ \sigma(x)=M $$]

Si llamamos "id" a la sustitución identidad, entonces una sustitución arbitraria se representa así:

[$$ id\circ\left[ x_1 \mapsto M_1 \right]\circ\cdots\circ \left[ x_n \mapsto M_n \right] $$]

Donde

[$$ dom(\sigma)=\left\{ x_1,...,x_n\right\} $$]

Edit: Corrección. Una sustitución arbitraria donde todas las variables se renombren. Cuando hay variables comunes entre el dominio y el resultado de la sustitución hay que usar una sustitución simultánea.[$$ \left[ x_1 \mapsto M_1 ,\cdots\circ , x_n \mapsto M_n \right] $$]


Introduciendo la sustitución indefinida

Cuando realizamos un algoritmo muchas veces necesitamos un "valor de error", en el conjunto de sustituciones sobre el álgebra de términos con indefinido se introduce una transformación especial que llamaremos la sustitución indefinida. Su propiedad es que siempre asigna el valor indefinido.

[$$ \omega : T^\Omega(A,V) \to T^\Omega(A,V) $$]
[$$ \omega (M) = \Omega $$]

Al conjunto de sustituciones con sustitución indefinida (sobre el álgebra de términos con indefinido) lo definimos de esta forma:

[$$ S^\omega(A,V)=S(A,V)\cup \left\{ \omega \right\} $$]

Hemos de arreglar un poco las operaciones anteriores de la siguiente forma:

[$$ \bar{\sigma}(\Omega)=\Omega $$]
[$$ \omega\mid_W=\omega $$]

Ahora queda averiguar qué estructura matemática tiene la operación de sustitución sobre el álgebra de términos, pero eso lo dejaré para otro día.


jueves, 20 de mayo de 2010

Tipos intersección

¿Qué son?

Supongamos que tenemos una función con el siguiente tipo

[$$ f: A \rightarrow B \rightarrow C $$]

¿Cuál es el tipo de esta nueva función?

[$$ \lambda x. f x x $$]

Esta claro que la x tendrá que ser de tipo A y de tipo B. Si tuviéramos subtipos, y asumiendo que el tipo de x es X, diríamos

[$$ X\le A,\quad X\le B $$]

Sería tarea del motor de inferencia buscar el tipo adecuado. Por otra parte, podríamos introducir una solución tramposa. Inventarnos el tipo

[$$ X=A\cap B $$]

con las  propiedades

[$$ T\cap S \le T $$]
[$$
T\cap S \le S $$]

Ni que decir tiene que esto recuerda mucho al concepto de intersección de conjuntos, de ahí el nombre.

El sistema de Coppo-Dezani

Si introducimos las reglas usuales de una intersección (es decir, las de un ínfimo) obtenemos el sistema de Coppo-Dezani (sistema CD). Este sistema tiene unas cualidades muy interesantes.

  • Cumple la reducción de sujeto. Es lo mínimo que se puede pedir a un sistema de tipos para una estrategia de evaluación por nombre: que si evaluamos en un paso nuestra expresión (sea el redex que sea), el tipo siga siendo el mismo.
  • Los términos tipables son los términos fuertemente normalizables. O sea, que sólo podremos darle un tipo a los términos cuya evaluación acabe.
  • Las formas normales son tipables ya que no tienen más pasos de evaluación.
  • Cumple la expansión de sujeto. Esto es interesante. Si damos un paso de evaluación marcha atrás, el tipo también se mantiene.
  • Estas propiedades nos llevan a la gran característica definitoria del sistema CD: Un término es tipable si y sólo si su evaluación acaba sea cual sea la estrategia de evaluación (es fuertemente normalizable).

Esta última propiedad no es buena. Y no lo es porque significa que no podemos darle un tipo a expresiones de la forma

[$$ K x y = x $$]
[$$ K\; 3\;((\lambda z. z z)(\lambda z. z z)) $$]

La función K (el combinador K) descarta su segundo parámetro, por lo que el término debería tener tipo entero (el resultado es 3). Sin embargo, no es tipable porque el segundo argumento nunca termina su evaluación. Este término no es fuertemente normalizable, es sólo normalizable de cabeza.

El sistema de Coppo-Dezani-Venneri

La solución es añadir una constante ? que significa "cualquier cosa". Sería vista como la intersección nula o como el elemento neutro de la intersección.

[$$ \omega \cap X = X $$]
[$$ X \cap \omega = X $$]

Al añadir las reglas apropiadas para introducir esta constante, los autores del sistema CDV se vieron forzados a separar los tipos en dos niveles. El nivel de tipo simple y el nivel de intersección (o secuencia) de tipos.

[$$ \tau ::= X\;\mid\;\omega\;\mid\;\sigma \rightarrow \tau $$]
[$$ \sigma ::= \tau_1 \cap \cdots \cap \tau_n\qquad (n>0) $$]

Con este sistema, las propiedad principal es que se puede asignar un tipo a los términos con forma normal de cabeza.

El sistema de Barendregt-Coppo-Dezani

El problema de los tipos restringidos del sistema CDV se soluciona introduciendo una relación de subtipo. Esto es así porque en posición covariante las intersecciones distribuyen.

[$$ A\rightarrow (B\cap C)=(A\rightarrow B)\cap(A\rightarrow C) $$]

Introduciendo una relación de subtipo que sea un preorden se puede derivar una clase de equivalencia y trabajar con el orden parcial generado en el conjunto cociente.

Este sistema es bastante más complejo. La relación de subtipo tiene hasta ocho reglas. La relación de tipado tiene seis reglas.

El sistema BCD tiene la misma potencia que el CDV. Sin embargo tiene un gran fallo: existen varias formas de demostrar que una expresión tiene un tipo. Las reglas no son dirigidas sintácticamente.

A pesar de todo esto, el sistema BCD es el más conocido y usado de los sistemas de tipos intersección.

lunes, 17 de mayo de 2010

Lo que nunca me enseñaron: El álgebra de términos

Cuando me enseñaron la lógica de primer orden, empezaron con las definiciones de alfabeto, término, sustitución, igualdad, unificación, etc. Realmente antes habíamos visto los términos, las gramáticas, autómatas y demás, pero nunca desde el punto de vista algebraico.

En un caso era demasiado complejo y en otro demasiado general. Aquí explico lo que es el álgebra de términos de la manera más simple y sencilla posible. A partir de estas definiciones se pueden explorar otras estructuras y operaciones matemáticas con un buen fundamento.

El alfabeto

Supongamos que tenemos un alfabeto de símbolos (que llamaremos funtores) de forma que cada funtor tenga una aridad.

[$$ A=(F,a) $$]
[$$ a:F \rightarrow \mathbb{N} $$]

Este alfabeto no podrá ser vacío ni no numerable.

[$$ 0<\left| F \right| \le \aleph_0 $$]

Cuando la aridad de un funtor es cero, se denomina entonces constante.

Nota: Los símbolos de los paréntesis y las comas están reservados y no podrán formar parte de nuestro alfabeto. Estos símbolos son los que se usan para construir los términos.

Nota: Usaremos las letras del inicio del alfabeto para las constantes (a,b,c) y del medio para los funtores (f,g,h).

Los términos

Llamamos variables a otros símbolos tomados de un conjunto infinito y numerable.

[$$ \left| V \right| = \aleph_0 $$]

Nota: Usaremos las letras del final del alfabeto para las variables.

[$$ \left\{ x,y,z\right\} \subset V $$]

El conjunto de términos de primer orden se define como el menor conjunto[$$ T(A,V) $$]

tal que

[$$ V\subset T(A,V) $$]

y

[$$ M_1,...,M_n \in T(A,V), f\in F \Rightarrow f(M_1,...,M_n) \in T(A,V) $$]

Por ejemplo, si nuestro alfabeto fuera a,b,+ con a y b constantes y con + de aridad dos, algunos términos serían.

  • a()
  • b()
  • +(a(),a())
  • +(a(),b())
  • +(x,b())
  • x

En muchos casos se permite la licencia de omitir los paréntesis vacíos y usar otras notaciones como la infija o la circunfija. Los ejemplos de arriba serían entonces:

  • a
  • b
  • a+a
  • a+b
  • x+b
  • x

Términos con indefinido

Muchas veces es útil añadir un valor indefinido para denotar un error o algún valor excepcional. En estos casos se define

[$$ T^\Omega(A,V)=T(A,V)\cup \left\{ \Omega \right\} $$]

Obviamente, el valor indefinido no debe estar ni entre los funtores ni entre las variables.

[$$ \Omega \not \in F $$]
[$$ \Omega \not \in V $$]

Igualdad de términos

Dos términos son iguales si lo son símbolo a símbolo. Esta relación se puede definir recursivamente sobre la estructura de los términos:

[$$ x = x $$]
[$$ \frac{M_1=M'_1,...,M_n=M'_n}{f (M_1,...,M_n) = f (M'_1,...,M'_n)} $$]


lunes, 12 de abril de 2010

¿Cómo prefiere la lista el señor? Equirrecursiva o isorrecursiva

Supongamos que tenemos un constructor tipos producto (el tipo de los pares ordenados) y un tipo suma (el tipo de un valor opcional entre dos). Entonces, una lista de enteros sería algo como

[$$ List = Empty + ( Integer \times List ) $$]

Una lista es o bien un valor de lista vacía o bien un entero y el resto de la lista. Ahora bien, ¿qué tipo cumple la ecuación anterior? Sencillamente, ninguno. Esto es así porque si sólo tenemos los constructores de tipos producto y suma. Hagamos lo que hagamos, jamás vamos a satisfacer la ecuación de arriba.

Equirrecursividad

La equirecursividad consiste en modificar el modelo en el cual se comprueba la ecuación. Esto viene a ser una modificación del significado de igualdad, de ahí el nombre.

La ecuación de arriba no se puede satisfacer porque sólo podemos usar tipos finitos (usamos el universo de Herbrand). Sea lo que sea el tipo List, al agregarle 

[$$ Empty + ( Integer \times ... ) $$]

al alrededor, hemos generado un tipo distinto.

[$$ List \ne Empty + ( Integer \times List ) $$]

La idea es permitir tipos infinitos (usamos el universo de árboles regulares) de manera que, al tener una extensión infinita, añadir o quitar el contexto

[$$ Empty + ( Integer \times ... ) $$]

del tipo, el resultado sea el mismo.

[$$ List $$]
[$$ = Empty + ( Integer \times ( Empty + ( Integer \times ( Empty + ... ) ) ) ) ) $$]
[$$ = Empty + ( Integer \times List ) $$]

La equirrecursividad permite definir listas, pero este cambio de modelo permite que ciertas expresiones tengan tipo aunque sean algo extrañas.

[$$ \lambda x. x x\ :\ \forall Y. (\mu X. X \rightarrow Y) \rightarrow Y $$]

Una solución es controlar cuándo introducimos o quitamos el contexto

[$$ Empty + ( Integer \times ... ) $$]

Isorecursividad

Volvemos a prohibir que la ecuación

[$$ List = Empty + ( Integer \times List ) $$]

tenga solución. Es decir, volvemos al universo de Herbrand.

Pero lo que vamos a hacer es introducir un isomorfismo entre los tipos de manera que el tipo List sea isomorfo al tipo

[$$ Empty + ( Integer \times List ) $$]

Esto lo escribimos como

[$$ List \equiv\ Empty + ( Integer \times List ) $$]

Ahora tenemos que introducir los isomorfismos. Estos los vamos a llamar fold y unfold. Son funciones que sólo modifican el tipo, no el valor. En este aspecto serían funciones identidad con un tipado especial.

[$$ fold\ :\ Empty + ( Integer \times List ) \rightarrow List $$]
[$$ unfold\ :\ List \rightarrow Empty + ( Integer \times List ) $$]

Afortunadamente estas funciones bastan aplicarlas cuando construimos o destruimos un valor de tipo List. Si tengo el constructor de valores del tipo suma

[$$ inj_l\ empty\ :\ Empty + ( Integer \times List ) $$]

tras aplicarle fold tendríamos

[$$ fold\ inj_l\ empty\ :\ List $$]

He construido una lista. Para destruirla primero hay que usar unfold.

[$$ case\ (unfold l)\ (\lambda .\ ...caso\ Empty...) (\lambda v. ...caso \times ...) $$]

El hecho de que los tipos isorrecursivos usen los isomorfismos fold/unfold justo en la construcción y destrucción ha provocado que se desarrollen los tipos algebraicos (ADT) que aúnan ambos tipos de funciones en una. Pero eso ya es otra historia.

jueves, 1 de abril de 2010

Polimorfismo de rango superior

Abstracción de tipos

Cuando escribimos una abstracción lambda, la idea subyacente es que quién elige el argumento es el llamador y quién elige el retorno es el llamado. En

[$$ (\lambda x:Int.x)3 $$]

el llamador elige que sea 3 el argumento y el llamado elige que sea x(=3) el resultado. Eso sí, el tipo está fijado a

[$$ Int \rightarrow Int $$]

Llamamos "flecha" a la flecha que indica que el tipo es una función de enteros en enteros. Esto es realmente un constructor de tipos.

Cuando usamos un tipo polimórfico el llamador también elige el tipo al que quiere instanciar un término. Para eso usamos una abstracción de tipos (lambda mayúscula). En la versión polimórfica de la función identidad sería:

[$$ (\Lambda T.\lambda x:T.x)Int\ 3 $$]

El llamador debe decidir qué tipo usar (el Int) y qué valor aplicar (el 3). Para expresar que una abstracción requiere un tipo (que puede ser cualquiera), le asignamos un tipo para todo. Así que el tipo de las abstracciones anteriores sería

[$$ \forall X.X \rightarrow X
$$]

Formas canónicas

Es interesante comprobar el hecho inverso. Cuando tenemos un valor cuyo tipo es

[$$ T \rightarrow S $$]

este valor debe ser una abstracción lambda como

[$$ s=\lambda x:T.r $$]

En la anotación del tipo (detrás de la x) tenemos lo que hay a la izquierda de la flecha del tipo. Es decir, el tipo T en la expresión de arriba.

Además, la forma de usarlo es aplicando un valor del propio tipo T. Algo como

[$$ s\ t $$]

donde t tiene tipo T.

Por otra parte, si tenemos un valor cuyo tipo es

[$$ \forall X.T $$]

este valor debe ser una abstracción de tipos como

[$$ s=\Lambda X.t $$]

Y el uso de s sería aplicándole un tipo. Por ejemplo, el tipo R.

[$$ s\ R $$]

Estas son las llamadas formas canónicas y la manera que tenemos de usarlas.

Rango uno

Ahora veamos qué forma puede tener una expresión de tipo

[$$ \forall X. \forall Y. X \rightarrow Y \rightarrow X $$]

Para empezar empieza por un para todo así que debe ser

[$$ \Lambda X.t $$]

Ese término t también empieza por para todo (el de la Y) así que tendríamos

[$$ \Lambda X. \Lambda Y.s $$]

Y el término s una función de dos argumentos que debe tener por tanto dos abstracciones lambda. Para no complicar el término, haremos que el cuerpo final retorne la propia x.

[$$ \Lambda X. \Lambda Y.\lambda x:X. \lambda y:Y. x $$]

Lo interesante de esta expresión es que, al usarla, es el llamador quién elige todos los tipos y argumentos. Podría ser algo como

[$$ (\Lambda X. \Lambda Y.\lambda x:X. \lambda y:Y. x)Int\ String\ 3\ ''hola'' $$]

Siempre que ocurra esto, nuestra expresión será de rango uno. Esto es muy importante porque no hay dependencias de ningún tipo. Dados los argumentos que apliquemos (sean tipos o valores) sabremos, directamente, cómo se van a usar dentro del cuerpo de la función (basta sustituir).

Si modificamos el tipo que hemos usado bajando un para todo a la derecha de una flecha, sólo intercambiamos el orden de los argumentos. Siguen dependiendo todos del llamador.

[$$ \forall X. X \rightarrow \forall Y. (Y \rightarrow X) $$]
[$$ \Lambda X. \lambda x:X. \Lambda Y. \lambda y:Y. x $$]

Seguimos en rango uno.

Rango superior

Ahora vamos a ver qué ocurre cuando ponemos el para todo a la izquierda de una flecha.

[$$ (\forall X.X \rightarrow X)\rightarrow Int $$]

Vemos que lo más exterior es una flecha. Es decir, la forma canónica empezará por lambda minúscula con una anotación de tipo igual a lo que haya a la izquierda de la flecha.

[$$ \lambda x:(\forall X.X \rightarrow X).t $$]

Esto significa que es el llamado el que debe pasarle el tipo a la x dentro de la t. Podría ser algo como

[$$ \lambda x:(\forall X.X \rightarrow X).(x\ Int\ 3) $$]

Entonces, no basta con sustituir, también hemos de calcular con lo que hay dentro del cuerpo de la aplicación. Hemos aumentado en un grado la complejidad con la que tiene que trabajar el sistema de tipos por el mero hecho de escribir un para todo a la izquierda de una flecha.

Si la aparición de este para todo está anidado a la izquierda de las flechas menos de N veces, decimos que el tipo es de rango N. En nuestro caso, como está sólo una vez, es de rango dos.

Es decidible el inferir tipos en rango uno y dos, pero en rango tres y superiores no es decidible. Esa es la razón por la que muchos lenguajes hacen únicamente inferencia de rango dos o, incluso, uno; donde todos los para todos están por fuera de cualquier flecha.

domingo, 28 de marzo de 2010

Contaminando datos

En la programación defensiva, existen varias formas de comprobar que los datos introducidos por el usuario no crean problemas de seguridad en nuestro código. La más usual es suponer que los datos están contaminados (no son fiables) hasta que se pruebe lo contrario.

Nota: A falta de mejor traducción, usaré "contaminado" por "tainted".

El funcionamiento es bien sencillo:

  1. Marcamos los datos que introduce el (potencialmente maligno) usuario como contaminados.
  2. Marcamos los datos que introduce el (supuestamente competente) programador como no contaminados.
  3. Las funciones con las que trabaja el programa sólo deben permitir utilizar datos no contaminados.
  4. El programador debe definir, adicionalmente, ciertas funciones de comprobación de la validez de los datos y quita de contaminación.

De esta manera en el único sitio donde hay que mirar por si hay problemas de seguridad es en las funciones de "descontaminación". Generalmente son muy pocas.

El caso clásico es cuando se quieren detectar desbordamientos de búfer. Hasta que no comprobemos que la cadena ofrecida por el usuario cabe en el búfer, no descontaminamos esa cadena. Este simple mecanismo, de descontaminar cuando se hace una comprobación de la longitud, puede aplicarse automáticamente al código fuente con una herramienta externa. Incluso, cuando no se estén marcando como contaminados los datos en el programa.

El resultado es que se encuentran los puntos donde se usan cadenas introducidas por el usuario sin haber comprobado antes la longitud. Algunos de estos usos inseguros pueden explotarse para introducirse maliciosamente en nuestro sistema.

En definitiva, el simple método de marcar los datos (o los tipos de los datos si hacemos el análisis estático) como contaminados o no contaminados tiene una incidencia directa en la seguridad de nuestro programa. Algunos lenguajes lo hacen así, como Ruby. Otros, no. 

jueves, 11 de marzo de 2010

Polimorfismo paramétrico

El polimorfismo paramétrico aparece de forma natural en la programación. El caso más simple es la función identidad.

[$$ \lambda x.x $$]

¿Cuál es el tipo de esta función? Realmente, depende de lo que sea el tipo de su argumento. Si es un real, la función será Real->Real. Si es un natural, será Natural->Natural. Si es una cadena Cadena->Cadena.

Esto se puede agrupar con la idea de los tipos universales: Para todo tipo X el resultado es X->X. Lo que se escribe así.

[$$ \forall X.X\rightarrow X $$]

Obviamente, según el tipo que deseemos usar, especializamos. Así de 

[$$ \forall X.X\rightarrow X $$]

pasamos a

[$$ Real \rightarrow Real $$]

Cuando especializamos X a un real. Pero, ¿podemos especializar X a lo que queramos? ¿Incluso al propio tipo universal? La respuesta es que sí. Es un caso de impredicación en el cual cuantificamos la propia sentencia en la que está el cuantificador. Es decir, que podríamos pasar a especializar

[$$ \forall X.X\rightarrow X $$]
[$$ (\forall X.X\rightarrow X)\rightarrow (\forall X.X\rightarrow X) $$]
[$$ (((\forall X.X\rightarrow X)\rightarrow (\forall X.X\rightarrow X))\rightarrow

((\forall X.X\rightarrow X)\rightarrow (\forall X.X\rightarrow X)))\rightarrow
(((\forall X.X\rightarrow X)\rightarrow (\forall X.X\rightarrow X))\rightarrow
((\forall X.X\rightarrow X)\rightarrow (\forall X.X\rightarrow X))) $$]

Y así, infinitamente.

Las estructuras infinitas no son malas de por sí. A menos que quieras recorrerlas enteras. En ese caso vas a tardar un tiempo infinito. Esto es la indecibilidad. Una forma de evitarlo es dividir los tipos en dos. Los esquemas con los para todos y los tipos monomórficos sobre los que se predica.

Esta separación de los tipos en dos niveles es lo que hacen los sistemas de tipos al estilo ML o  de polimorfismo let. Aunque esa será historia para otro post.

martes, 2 de marzo de 2010

Predicativo e impredicativo

Veamos esta fórmula de la lógica de primer orden

[$$ \forall y.y \lt x $$]

Podríamos verla como un predicado

[$$ P(x) \equiv \forall y.y \lt x $$]

Ahora veamos esta fórmula de la lógica de segundo orden

[$$ \forall Q.Q(x) $$]

También podríamos verla como un predicado

[$$ R(x) \equiv \forall Q.Q(x) $$]

Pero R(x) dice que todos los predicados Q cumplen Q(x) ¡incluido R(x)!

Así que factorizamos ese término para que se vea bien.

[$$ R(x) \equiv R(x) \wedge \forall Q.Q(x) $$]

Esto no pasaba con la lógica de primer orden porque la y en

[$$ \forall y.y<x $$]

sólo puede ser un elemento del dominio. Cuando ocurre esto, se dice que es un sistema predicativo. Cuando ocurre lo de la lógica de segundo orden, el sistema es impredicativo (habla de sí mismo).

Los sistemas impredicativos son una puerta a los problemas. Si hubiéramos definido por ejemplo

[$$ R(x) \equiv \forall Q.\neg Q(x) $$]

Podríamos especializar en

[$$ R(x) \equiv \neg R(x) \wedge \forall Q.\neg Q(x) $$]

Así que R(x) es cierta cuando R(x) es falsa... Mal rollo, ¿no?

miércoles, 2 de diciembre de 2009

Coinducción

Estudiando teoría de tipos me he cruzado con el concepto de coinducción. Es un concepto fácil y con interesantes consecuencias.

Inducción

Tanto en la inducción como en la coinducción queremos saber qué elementos de un conjunto universo U cumplen una propiedad P. Llamemos precisamente P al conjunto de elementos que cumplen P. Obviamente

[$$ P\subseteq U $$]

En el caso de la inducción partimos con unos casos base B que son elementos de los que tenemos constancia directa de su propiedad P. De nuevo y obviamente

[$$ B\subseteq P\subseteq U $$]

Ahora necesitamos el paso de inducción. El paso de inducción nos dice que si conocemos que ciertos elementos cumplen la propiedad, entonces otros también la cumplen. El paso clásico es

[$$ P(n)\rightarrow P(n+1) $$]

Sin embargo, generalizamos pensando que si he comprobado que los elementos de X cumplen la propiedad, entonces los elementos de F(X) también la cumplen. F(X) representa a los elementos del siguiente paso. Es decir,

[$$ X\subseteq F(X) $$]

El resultado es que cada vez X se hará más y más grande... hasta encontrar un punto fijo (por el teorema de Kleene es el mínimo punto fijo)

[$$ X=F(X)=\mu F $$]

En ese momento P=X.

Nota adicional: Si hacemos que

[$$ F(\emptyset )=B $$]

Se captura también la idea de caso base en el formalismo de F (llamada función generadora). Una restricción para esta F es que debe ser monótona.

[$$ U\subseteq V \rightarrow F(U)\subseteq F(V) $$]

Esto es lógico porque si hemos probado que un elemento x cumple la propiedad P(x) está claro que debe seguir cumpliéndola conforme avancemos en la demostración.

Coinducción

Algunas propiedades no se pueden demostrar por inducción. Sólo podremos demostrar por inducción aquellas en las que exista una función generadora F cuyo mínimo punto fijo sea P. Como ya hemos escrito,

[$$ \mu F=P $$]

Sin embargo, tenemos otro punto fijo que es el máximo punto fijo. En este punto fijo, empezamos por asumir que todos los elementos de U cumplen la propiedad y luego, con la F, vamos quitándolos. Eso es la coinducción.


Partimos de unos casos bases de los que estamos seguros que fuera de ellos no se cumple P. Luego vamos refinando esos casos quitando poco a poco, usando F otra vez, hasta llegar al máximo punto fijo.

[$$ \nu F=F(X)=X=P $$]

Todo esto está muy bien, ¿pero para qué sirve?

Principalmente para nada si ambos puntos fijos son el mismo, pero si no son el mismo obtenemos propiedades distintas ya usemos la inducción o la coinducción.

Aplicación a los subtipos recursivos

Supongamos que tenemos una lista definida de la manera usual en tipos algebráicos paramétricos.

Lista(X) = vacía | par X Lista(X)

Es decir, una lista es o bien la lista vacía o bien un par de un elemento del contenido de la lista (tipo X) con el resto de la lista.

Ahora tendremos dos tipos, los enteros y los reales. Está claro que un entero es un subtipo de un real de sólo lectura ( Entero <: Real ), pero ¿es una lista de enteros una lista de reales? ( Lista(Entero) <: Lista(Real) ).


Vayamos por partes.


Una lista vacía es una lista vacía así que no vamos a tener problemas ahí.

Si un par X Y es subtipo de otro par S T entonces X ha de ser subtipo de S e Y de T. Es decir

[$$ par\ X\ Y\ <:\ par\ S\ T\ \ \leftrightarrow\ \ X<:S\ \ \wedge\ \ Y<:T $$]


Cuando comparamos las listas de enteros y reales los primeros términos del par son precisamente Entero y Real por lo que todo va bien. Sin embargo, en el segundo término volvemos a tener Lista(Entero) y Lista(Real) que es justo lo que queríamos comprobar.

Estamos usando tipos recursivos y es normal que esto pase.

Si usáramos inducción deberíamos decir "Como no he comprobado que Lista(Entero)<:Lista(Real) entonces lo asumo falso y concluyo que una lista de enteros no es una lista de reales".


Si usáramos coinducción deberíamos decir "Como no he comprobado que Lista(Entero)<:Lista(Real) entonces lo asumo cierto y concluyo que una lista de enteros es una lista de reales".


En los lenguajes de programación que usan tipos recursivos, el uso de la coinducción es necesario ya que de otra forma estos tipos recursivos no cumplirían ninguna propiedad.

miércoles, 11 de noviembre de 2009

De objetos y TADs

Leo desde LtU un ensayo de W.R.Cook que explica por qué un objeto no es un tipo abstracto de datos (TAD o ADT en inglés).

Resumiendo las diferencias sería:

  1. Un objeto no necesita tipado estático. De hecho, hay muchos lenguajes orientados a objetos con tipado dinámico. Lo que necesitan los objetos es alguna forma de funciones de orden superior para la vinculación dinámica.
  2. Los objetos no soportan operaciones "complejas" que tengan que inspeccionar otros objetos. De hecho, los objetos sólo pueden inspeccionarse a ellos mismos (o, según el lenguaje, a otros de su misma clase). Esto es una desventaja al principio, pero luego permite una mayor escalabilidad.
  3. Los TAD permiten extender el comportamiento añadiendo nuevas funcionalidades y operaciones, mientras que los objetos extienden el comportamiento añadiendo nuevas representaciones.

En general, si mi comprensión no ha fallado, los TAD  ocultan la representación y muestran las operaciones. Los objetos muestran la representación y ocultan las operaciones (que pasan a ser parte de la representación via vinculación dinámica).

miércoles, 14 de octubre de 2009

Covariancia y contravariancia (V)

Funciones virtuales

En el último post de esta serie dije que la siguiente operación no se podía realizar.

pes.crea_mueble(150) // Mal, no sabemos las patas que tiene la silla

Esto puede soslayarse si el programador asume la responsabilidad de actualizar correctamente el estado de la silla entera cuando se modifica únicamente la parte mueble de la misma. Por ejemplo, en el caso anterior el programador puede usar una versión especial de crea_mueble() para las sillas. En esta versión especial puede optar por, por ejemplo, usar cuatro patas por defecto.

Ahora bien, ¿cómo sabe que, aunque sea un puntero a mueble, realmente es una silla? Se usa lo que se llaman funciones virtuales. Una función virtual es aquella cuyo despacho se realiza en función del tipo de objeto apuntado y no en función del tipo de puntero. De esta forma, aunque tengamos un puntero a mueble, si actuamos sobre una silla, se usará la función especial de la silla.

Con esta técnica, y bajo responsabilidad del programador, los punteros de lectura/escritura terminan siendo como los punteros de lectura: covariantes.

Paso por valor

En otro post dije que la herencia no era lo mismo que el subtipado y di un motivo en concreto: el tamaño que ocupan los objetos en memoria. Si usamos punteros (o referencias) a objetos podemos usar la técnica de arriba, pero si nuestro lenguaje es de paso por valor, tenemos un problema.

Supongamos que una función tiene el tipo f: Unit -> A. Esta función no toma ningún argumento (el tipo unit es algo así como el tipo void en C/C++ en este caso) y devuelve un objeto de tipo A. Claro está que podría devolver un subtipo B de A.

Por lo mencionado antes, los lenguajes orientados a objetos no usan realmente la relación de subtipo. Usan la relación de herencia. Eso significa que B puede ser de mayor tamaño que A y aquí surge el problema: ¿cómo sabe la función llamante si f va a devolver un A o algún otro tipo heredado como B? Porque si va a devolver un B va a tener que reservar más memoria que para un A. En caso contrario tendríamos un desbordamiento de buffer (buffer overflow).

Una solución sería pensar que la función tiene que devolver exactamente un A. Esto la haría invariante y que no podríamos cambiar cualquier aparición de f: Unit -> A por otra función g: Unit -> B.

Por otra parte, sabemos que con los punteros (y gracias a las funciones virtuales) no tenemos ese problema. Es decir, que sí podemos cambiar cualquier aparición de f2: Unit -> PA por otra función g2: Unit -> PB.

¡Pero es que es lógico! Pasamos los punteros por valor y el objeto apuntado por referencia. Los punteros son todos del mismo tamaño por lo que no hay problemas de desbordamiento de buffer. Esto es justo lo que hace el C++: permitir la covariancia de funciones sólo para los punteros (y referencias).

Marcando la variancia en los constructores de tipo

La solución de C++ está bastante encorsetada. Sólo permite covariancia para unos tipos predefindos. ¿No podríamos mejorar esto?

Si el programador supiese que, cuando usa un constructor de tipos, el resultado es otro tipo que

  1. Va a tener estados consistentes y no va a tener slicing (funciones virtuales)
  2. No va a provocar desbordamiento de buffer (mismo tamaño si es paso por valor)
  3. No va a tener problemas semánticos (el programador es responsable y sabe lo que se hace).

Entonces podría asegurar que sus constructores de tipos van a ser covariantes o contravariantes y podría anotarlo en el código. Por ejemplo, un contenedor de sólo lectura es covariante.

Esto es lo que hace el lenguaje de programación Scala y las nuevas versiones del C#. Un ejemplo obtenido de aquí es:

//+A significa que es covariante en A

class Stack[+A] { 

//B >: A significa que A es subtipo de B (A<:B)

def push[B >: A](elem: B): Stack[B] = new Stack[B] {
override def top: B = elem
override def pop: Stack[B] = Stack.this
override def toString() = elem.toString() + " " +
Stack.this.toString()
}

def top: A = error("no element on stack")

def pop: Stack[A] = error("no element on stack")

override def toString() = ""
}

object VariancesTest extends Application {

var s: Stack[Any] = new Stack().push("hello");
s = s.push(new Object())
s = s.push(7)
Console.println(s)

}

Comentarios finales

Con esto doy por acabada la serie de variancias. Seguramente surgirá algún tema más que comentar en el futuro, por lo que no tendré ninguna pereza en reabrirla para nuevos posts. 

viernes, 11 de septiembre de 2009

Herencia y subtipo

Hoy en día en los lenguajes orientados a objetos es común hacer cosas del tipo

class A { int x; };

class B: public A { int y; };

Y decimos que la clase "B" hereda de la clase "A" y por lo tanto puedo usar "B" en cualquier sitio donde pueda usar "A". ¿Seguro?

Esto es erróneo y el ejemplo es claro arriba. La clase "A" ocupa el tamaño de un entero mientras que la clase "B"  ocupa el tamaño de dos por lo que es imposible usar la clase "B" en un espacio donde estaba la clase "A" porque no cabe.

Esto me lleva a pensar que subtipo (sustitución) y herencia (derivación de clases unas de las otras) no son completamente equivalentes. Muchos lenguajes lo ocultan mediante la prohibición de tener acceso directamente a las clases y sólo se pueden usar punteros o referencias a los objetos de las mismas (y el lenguaje se encarga de la gestión de memoria para que no podamos hacer cosas raras). Por ejemplo, Java y C# siguen este paradigma.

En otros lenguajes donde sí se puede acceder directamente a los objetos de las clases ocurren otros tipos de problemas indeseables como el slicing. Ahí están las grietas que separan subtipado de herencia. De hecho, la herencia ¡es una composición! La magia radica en que es una composición especial (usualmente la clase base es el primer miembro oculto de la clase hija) y los símbolos de la clase padre se importan subrepticiamente a la clase hija. De esta manera, cualquier uso de los miembros de la clase padre se corresponden con los mismos miembros de la clase hija. Esto es lo que da esa apariencia de sustitutibilidad.