Mostrando entradas con la etiqueta ingeniería del software. Mostrar todas las entradas

miércoles, 18 de diciembre de 2013

La historia de Mel

Una historia clásica de un pasado mejor. Nada mejor para estas fiestas navideñas. Citado de aquí.


Fuente: utastro!nather (Ed Nather), 21 de Mayo de 1983.


La historia de Mel


En un artículo reciente, hablando del lado macho de la programación, se hizo la simple y llana afirmación:

Los Verdaderos Programadores escriben en FORTRAN

Quizá lo hagan ahora, en esta era decadente de cerveza sin alcohol, calculadoras de bolsillo y programas "user-friendly" pero en los Viejos Buenos Tiempos, cuando el término "software" sonaba a broma y los Verdaderos Ordenadores estaban hechos de tambores y tubos de vacío los Verdaderos Programadores escribían en código máquina. No FORTRAN. No RATFOR. Ni siquiera ensamblador. Código máquina. Crudos, sin adornos, inescrutables números hexadecimales. Directamente

Toda una nueva generación de programadores creció en la ignorancia de este glorioso pasado, por lo que me siento obligado a describir, tan bien como me sea posible debido al salto generacional, cómo un Verdadero Programador escribía código.

Le llamaré Mel, porque ese era su nombre.


Conocí a Mel cuando empecé a trabajar para Royal McBee Computer Corp., una extinta subsidiaria de una compañía de maquinas de escribir. La empresa producía el LGP-30, un pequeño y barato (para los estándares de la época) ordenador con memoria de tambor, y empezaba a producir el RPC-4000, un ordenador con memoria de tambor mejorado, más grande y más rápido. Estos ordenadores costaban demasiado, y tampoco duraron mucho de todas formas (es por esto que no habéis oído hablar de la compañía ni del ordenador)
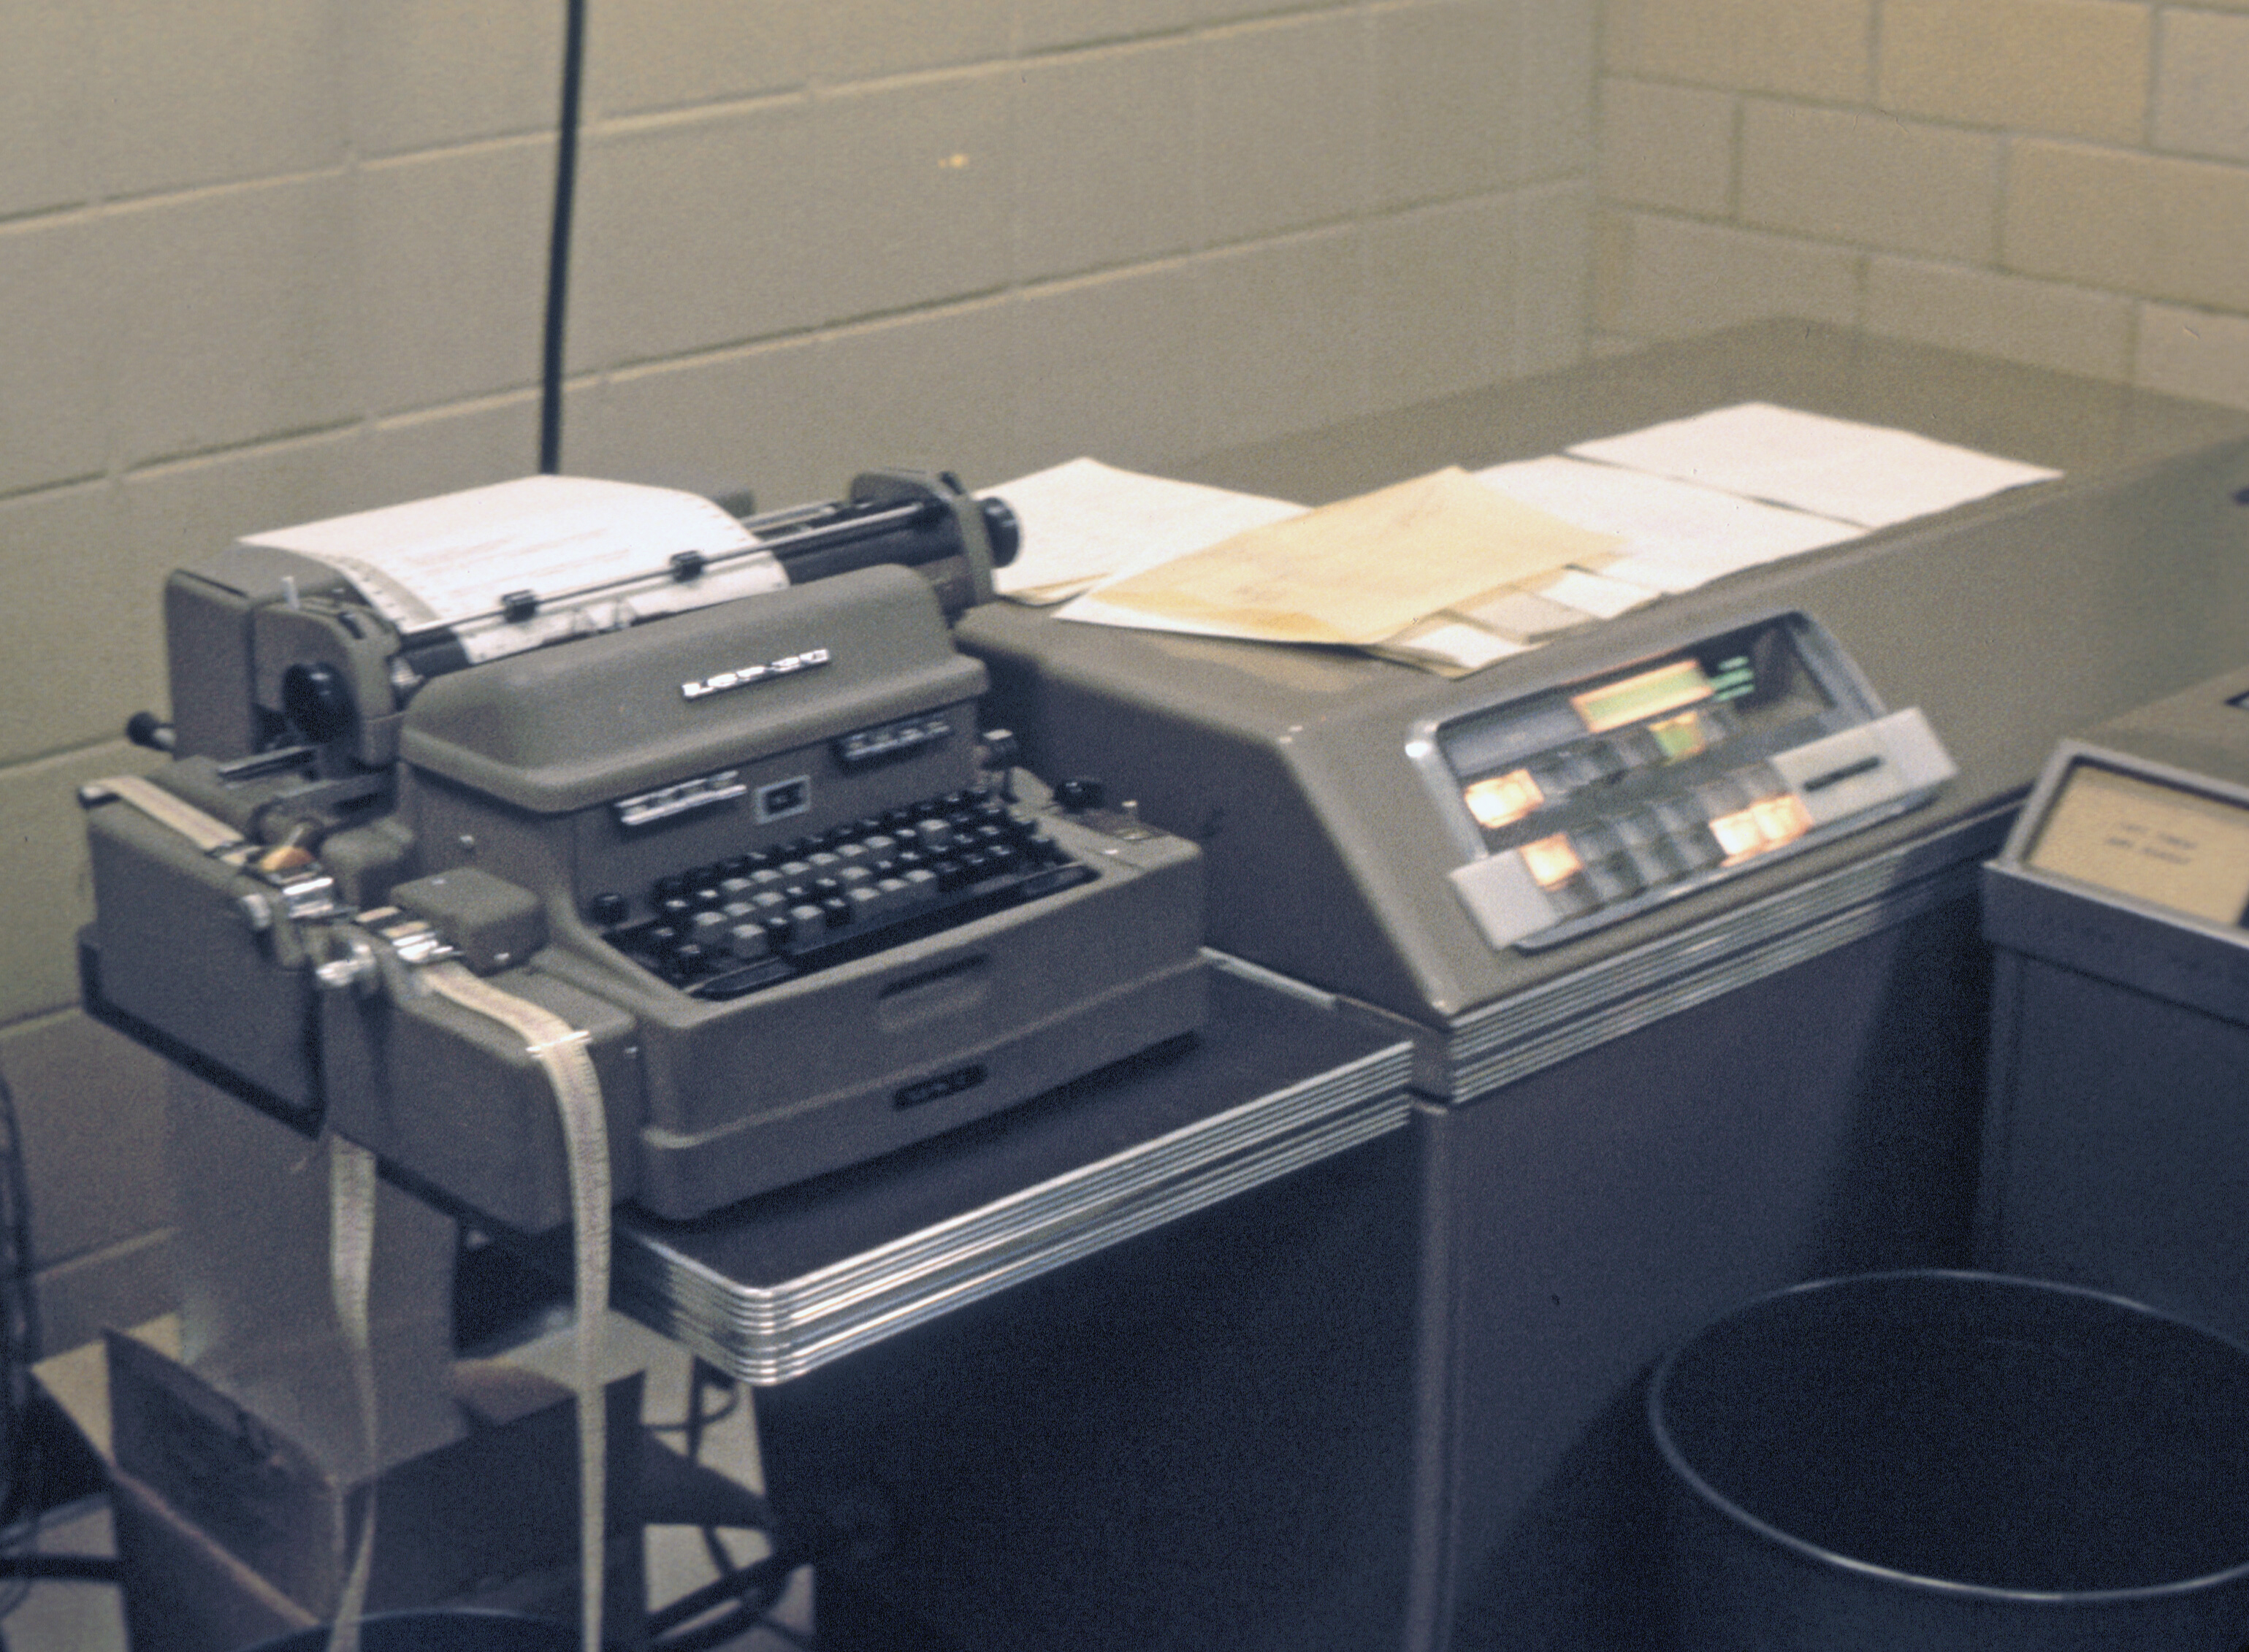

 Había sido contratado para escribir un compilador de FORTRAN para esta nuevo portento y Mel fue mi guía a sus maravillas. Mel no soportaba a los compiladores.

– ¿Si un programa no puede rescribir su propio código — preguntó — qué tiene de bueno?

Mel había escrito, en hexadecimal, el programa de ordenador más conocido que la compañía poseía. Corría sobre el LGP-30 y jugaba al blackjack con los compradores potenciales en las exposiciones de ordenadores. Su efecto era increíble. El stand del LGP-30 estaba siempre lleno en cada exposición, y los vendedores de IBM estaban allí de pie sin poder hacer otra cosa que hablar entre ellos. Si aquello servía para vender ordenadores o no era una pregunta que nadie se planteó nunca.

El trabajo de Mel era reescribir el programa de blackjack para el RPC-4000 (¿Portable? ¿Qué significa eso?). El nuevo ordenador tenia un sistema de direccionamiento de uno más uno, en donde cada instrucción máquina, aparte del código de operación y de la dirección del operando utilizado, tenía una segunda dirección que indicaba donde estaba la próxima instrucción en el tambor giratorio.
¡Una forma moderna de contarlo sería que cada instrucción estaba seguida de un GOTO! Pon eso en la pipa de Pascal y fúmatelo.

Mel amaba al RPC-4000 porque podría optimizar su código: es decir, localizar las instrucciones en el tambor de modo que cuando una hubiera terminado su trabajo, la próxima estuviera pasando por debajo de la cabeza lectora y, por lo tanto, estuviera disponible para su inmediata ejecución. Había un programa que se usaba para hacer eso, un "optimizador de código de ensamblador", pero Mel se oponía a usarlo.

– Nunca sabes donde va a poner las cosas — explicaba — por lo que deberías utilizar constantes separadas.

Tardé un buen tiempo antes de poder entender esa extraña frase. Como Mel conocía el valor numérico de cada código de operación, y había asignado sus propias direcciones en el tambor, cada instrucción que escribía podía también ser considerada como una constante numérica. Podía tomar una instrucción "add" anterior, por ejemplo, y multiplicar algo con ella, si tenía el valor numérico que necesitaba. Su código no era muy sencillo de modificar por otra persona que digamos.

Comparé los programas optimizados a mano de Mel con el mismo código pasado por el programa de optimización de código de ensamblador, y los de Mel siempre se ejecutaban más rápido. Esto era debido a que el sistema de programación "top-down" no había sido inventado aún, y Mel no lo habría utilizado de todas formas. Escribía las partes más internas de los bucles de su programa primero, para que se pudieran situar en las direcciones optimas del tambor. El optimizador de código ensamblador simplemente no era lo suficientemente listo para hacerlo de ese modo.

Mel nunca escribía bucles de espera, a pesar de que la Flexowriter requería un tiempo de espera entre los caracteres de salida para funcionar correctamente. Simplemente situaba las instrucciones en el tambor de forma que cada una ya hubiera pasado por debajo de cabeza cuando se necesitaba; de forma que el tambor debía realizar otra revolución completa para encontrar la instrucción que acababa de pasar. Acuñó un término inolvidable para este proceso. A pesar de que "óptimo" es un término absoluto, como "único", se convirtió en una costumbre hacerlo relativo: "no del todo óptimo" o "menos óptimo" o "o no muy óptimo". Mel llamaba a las localizaciones con mayor tiempo de espera las "más pésimas".

Después de terminar el programa de blackjack y conseguirlo ejecutar ("Incluso el inicializador está optimizado" dijo orgullosamente), recibió una Petición de Modificación desde el departamento de ventas. El programa utilizaba un elegante (y optimizado) generador de números aleatorios para barajar las "cartas" y repartirlas desde el "montón", y algunos de los vendedores creían que esto era demasiado justo, porque a veces los compradores perdían. Querían que Mel modificara el programa para que, cuando se cambiara un interruptor en el panel, pudieran cambiar la suerte y dejar al comprador ganar.

Mel protestó. Creía que la proposición era sencillamente deshonesta, que lo era, y que chocaba con su integridad personal como programador, lo que pasaba de veras, por lo que se negó a hacerlo. El Director de Ventas habló con Mel, igual que lo hizo el Gran Jefe, y, a petición del jefe, unos cuantos Compañeros Programadores. Mel finalmente se rindió y escribió el código, pero hizo la comprobación al revés, y, cuando el interruptor se pulsaba, el programa hacia trampas, ganando todo el rato. Mel estaba encantado con ello, proclamando que su subconsciente era incontrolablemente ético, y se negó estoicamente a arreglarlo

Después de que Mel dejara la compañía en busca de pa$to$ más verdes, el Gran Jefe me preguntó si podía mirar el código y ver si podía encontrar la comprobación y darle la vuelta. Un poco reticente acepté mirar. Seguir el código de Mel era una verdadera odisea.

A veces creo que programar es un arte, y su valor solo puede ser apreciado por otra persona versada en ese arcano arte; existen gemas maravillosas y brillantes ocultas a la vista y admiración humanas, algunas veces para siempre, por la naturaleza misma del proceso. Puedes aprender un montón sobre alguien sólo leyendo su código, incluso en hexadecimal. Mel era, creo, un genio incomprendido.

Quizá mi mayor conmoción fue cuando encontré un inocente bucle que no contenía ninguna condición. Nada. El sentido común me decía que tenía que ser un bucle cerrado, donde el programa se ejecutaría para siempre, sin fin. Sin embargo el control del programa pasaba a través de él hasta el otro extremo sin problemas. Me llevó dos semanas descubrir lo que sucedía.

El RPC-4000 tenía un dispositivo realmente moderno llamado registro índice. Permitía al programador escribir un bucle que utilizara una instrucción indexada en su interior; cada vez que se pasaba por ese punto el valor en el registro índice era añadido a la dirección del operando de aquella instrucción, por lo que se referiría al próximo dato de una serie. Sólo tenía que incrementar el registro índice cada vez. Mel nunca lo utilizó

En su lugar, él ponía la instrucción en un registro de la máquina, añadia uno a su dirección y la almacenaba de nuevo. Entonces ejecutaba la instrucción modificada, directamente desde el registro. El bucle estaba escrito de forma que este tiempo adicional de ejecución se tenía en cuenta, cuando la instrucción en curso terminaba la próxima estaba justo bajo la cabeza de lectura del tambor, lista para ser ejecutada. Pero el bucle no tenía comprobación.

La pista vital llegó cuando me di cuenta que el bit del registro índice, el bit que estaba entre la dirección y el código de operación en la palabra de la instrucción estaba activo… a pesar de que Mel nunca utilizaba el registro índice, dejándolo a cero todo el tiempo. Cuando la luz brilló, casi me cegó.

Mel había situado los datos en los que trabajaba cerca de la parte alta de la memoria, las direcciones más grandes que las instrucciones podían direccionar por lo que, después de que el último dato hubiera sido utilizado, incrementar la dirección de la instrucción haría que se desbordara. El acarreo añadiría uno al código de operación, cambiándolo a la siguiente instrucción en el juego: una instrucción de salto. Además la próxima instrucción de programa estaba en la dirección cero, y el programa seguiría felizmente su recorrido

No me he mantenido en contacto con Mel, por lo que no se si se rindió a los cambios que los tiempos han introducido en las técnicas de programación desde esos días desaparecidos hace mucho tiempo. Me gusta pensar que no lo hizo. De todas maneras me impresionó tanto aquello que dejé de buscar la comprobación, diciéndole al Gran Jefe que no podía encontrarla. No pareció sorprendido.

Cuando dejé la compañía el programa de blackjack seguía haciendo trampas si activabas el interruptor, y creo que es como debe ser. No me siento a gusto hackeado el código de un Verdadero Programador
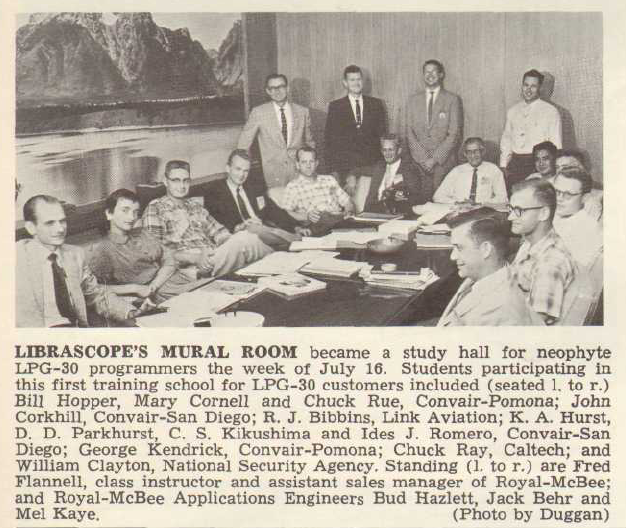
Mel está de pie a la derecha

sábado, 2 de febrero de 2013

Coma serial, agujeros de gusano, gotos desnudos, e implícitos por tipo

Funciones

Llamemos a una función. Una función que está en un lugar distante del código.
Si sigo el flujo de control (dibujado en rojo abajo) y el flujo de datos (en azul), ambos van paralelos. Es decir, el valor de a (dato) se lleva a la función doble (control) y se trae de vuelta el resultado (dato) al retornar (control).
La variable a es local. Eso quiere decir que fuera de mi trocito de código no se ve. Por eso necesitamos pasar la variable a a la función doble. ¿Qué pasaría si a fuera global y sí se viese en todo el programa incluida la función doble?

Variables globales

En este caso, no hace falta pasar la variable global a ninguna función, puesto que ya se ve desde allí.
Ahora, una vez guardado el dato 3 en la variable global a, está disponible en cualquier punto del programa. No hace falta pasarlo como argumento a la función doble. El flujo de datos a través de la variable global a se ha ocultado.

Ahora bien, ¿qué ocurre si otro trozo de código ejecuta doble en vez del que estoy usando como ejemplo?
Primero, el flujo de control llegará y asignará el dato 3 a la variable global a. Luego, el programa seguirá funcionando. Algún tiempo o mucho tiempo después, el flujo de control llegará al trozo de código en el que se ejecuta doble y se recupera el valor de la variable global a.

La variable global ha hecho que el dato 3 se pase de una punta a la otra del programa sin que haya relación directa entre esos dos trozos de código. Si no vemos la definición de doble, el uso de la variable global a dentro de doble no es tan obvio. No aparece ni en sus parámetros ni en sus argumentos. El efecto es el de un dato que se teleporta de un lugar a otro del programa.

Beam me up, Scotty!


Entra en un lugar del universo y sale por otro completamente distinto. Como los agujeros de gusano, pero mucho peor ya que puede haber más de dos extremos en una variable global.

Que alguien busque un error en un programa lleno de variables globales con datos que se teleportan de un lado a otro sin relación directa es muy, muy difícil.

Conclusión lógica: mejor evitar el uso de variables globales porque separan el flujo de datos del flujo de control.

Se considera al goto dañino

Hay ríos de tinta (y de bits) explicando que la instrucción goto debe ser evitada a toda costa y, además, su uso es síntoma de mal código. Muchas veces se toma demasiado al pie de la letra el título del artículo de Dijkstra que puso este problema sobre la mesa, pero sin terminar de leer el artículo por completo y viendo el porqué de la mala fama del goto.

Realmente no siempre el goto es malo. Veamos la razón. El goto es el caso complementario a una variable global. En la variable global era el flujo de datos el que saltaba de una punta a otra del código, con el goto es el flujo de control el que salta.
Como goto no permite pasar datos al lugar donde salta, el flujo de datos se acaba en el goto y empieza en el lugar donde llega. Este lugar es llamado la etiqueta. Llamaremos a este tipo de goto un goto desnudo.

¿Y si quiero pasar datos desde un goto desnudo hasta su etiqueta? Muy sencillo: debemos usar las variables globales.
Es más, si usamos gotos desnudos, no nos queda otra opción que usar variables globales. Las variables globales implican saltos en el flujo de datos: lo que entra en una variable global puede aparecer en la otra punta del código. Además, los gotos implican saltos en el flujo de control: la etiqueta de destino de un goto puede estar en la otra punta del código. Las dos cosas juntas hacen que la comprensión de un programa no trivial sea imposible.

Conclusión: los gotos desnudos son malos porque nos fuerzan a usar variables globales. Realmente, la raíz de todo mal está en las variables globales ya que los gotos pueden modificarse para que no sea necesario el uso de estas variables.

Restricción de saltos

¿Cómo podemos restringir el uso de los goto para que sea seguro? La primera lección la da el lenguaje C: un goto sólo puede saltar a una etiqueta que esté en su misma función.

void g(void)
{
y:
  puts(“ups!”);
}

void f(void)
{
  int a;
x:
  a=rand();
  if(a==0) goto x;  //OK: x está en f
  else     goto y;  //ERROR: y está en otra función
  printf(“%d\n”,a);
}

De esta forma antes y después del goto están visibles las variables locales de la función. No hace falta usar variables globales ya que la comunicación se realiza mediante variables locales.

Otra lección proviene de la teoría de lenguajes y consiste en añadir al goto un parámetro. Llamaremos a este goto vestido.

goto x(3);

Y en la etiqueta recogemos el argumento.

x(a):
print(a);

La etiqueta se comporta en cierta manera como una función que nunca retorna. Esto se acerca al concepto de continuación. También, con las continuaciones, pasamos los datos como si fuera una función y no necesitamos variables globales.

Evitamos la raíz de todo mal: las variables globales y sus agujeros de gusano.

Nota: Una continuación es un valor de forma similar a lo que las clausuras son a las funciones, por lo que el goto vestido no es exactamente una continuación.

Implícitos

Sin embargo, no tener variables globales es tedioso a la hora de escribir un programa porque hay que ir arrastrando el contexto que antes mantenía la variable global.

Propongamos este simple ejemplo:

Dato d; //Mi dato d que voy a usar como variable global

void h(Dato d); //La función que usa el dato
void g(OtrosDatos a, YMasDatos b)
{
  //Esta función hace otras cosas con a y b pero, al final usa h
  h(d)
}
void f(AlgunasCosas x, OtrasCosas y)
{
  //Esta función hace cosas con x e y, pero al final llama a g
  g(a,b)
}
int main()
{
  //Prepara x e y
  //Preparo mi dato d
  f(x,y)
}

La función h usa d. Por ese motivo se dice que d es contexto de h. Como d es global no tenemos problemas en escribirla en cualquier parte del código, incluida h. ¿Qué pasaría si d no pudiera ser global? Tendríamos que ponerla en main(), pasársela a f y propagarla hasta llegar a h. Es decir, tenemos que escribir el contexto en los parámetros de las funciones que lo usan.

Esto es justamente lo que deseamos hacer: que el flujo de datos y de control vayan paralelos.

void h(Dato d); //La función que usa el dato
void g(OtrosDatos a, YMasDatos b, Dato d)
{
  //Esta función hace otras cosas con a y b pero, al final usa h
  h(d)
}
void f(AlgunasCosas x, OtrasCosas y, Dato d)
{
  //Esta función hace cosas con x e y, pero al final llama a g
  g(a,b,d)
}
int main()
{
  //Prepara x e y
  Dato d; //Mi dato d que voy a usar como variable local
  //Preparo mi dato d
  f(x,y,d)
}

En las funciones f y g hemos tenido que añadir el dato para transmitirlo hasta la función h. Cada vez que usemos f o g, hemos de añadir d ¡y eso pueden ser muchas, muchas veces! ¿Cómo solucionarlo sin variables globales?

La mejor forma que he visto es mediante argumentos implícitos. Una característica del lenguaje de programación Scala. Consiste en añadir la palabra clave implicit en los parámetros que se comportan como propagadores de contexto.

void h(Dato d); //La función que usa el dato
void g(OtrosDatos a, YMasDatos b, implicit Dato d)
{
  //Esta función hace otras cosas con a y b pero, al final usa h
  h(d)
}
void f(AlgunasCosas x, OtrasCosas y, implicit Dato d)
{
  //Esta función hace cosas con x e y, pero al final llama a g
  g(a,b,d)
}
int main()
{
  //Prepara x e y
  Dato d; //Mi dato d que voy a usar como variable local
  //Preparo mi dato d
  f(x,y,d)
}

Hasta ahora nada cambia, pero declarar un parámetro como implícito significa que es opcional y, si no se pone, se busca el llamado valor implícito de ese tipo de datos en el entorno actual. La forma de declarar un valor implícito es también con la palabra clave implicit.

void h(Dato d); //La función que usa el dato
void g(OtrosDatos a, YMasDatos b, implicit Dato d)
{
  //Esta función hace otras cosas con a y b pero, al final usa h
  h(d)
}
void f(AlgunasCosas x, OtrasCosas y, implicit Dato d)
{
  //Esta función hace cosas con x e y, pero al final llama a g
  g(a,b,d)
}
int main()
{
  //Prepara x e y
  Dato d; //Mi dato d que voy a usar como variable local
  //Preparo mi dato d
  implicit d; //Usa d como el valor implícito para Dato
  f(x,y) //El implícito para el tipo Dato es d.
         //Entonces, es como llamar a f(x,y,d)
}

Nota: ¿Por qué Scala asocia un valor implícito al tipo Dato y no, por ejemplo, a cada nombre de manera que si no escribo el argumento implícito busque la variable con nombre “d”? ¿No es muy rebuscado buscar el valor implícito según sea el tipo del parámetro? La respuesta es bastante teórica. Este mecanismo introduce una dependencia de valores desde los tipos y esto es muy útil para otras muchas cosas como los conceptos (también llamados clases de tipos).

Lo interesante es que un parámetro implícito es directamente el valor implícito en el entorno de la función, por lo que tampoco hace falta escribir g(a,b,d).

void h(Dato d); //La función que usa el dato
void g(OtrosDatos a, YMasDatos b, implicit Dato d)
{
  //Esta función hace otras cosas con a y b pero, al final usa h
  h(d)
}
void f(AlgunasCosas x, OtrasCosas y, implicit Dato d)
{
  //Esta función hace cosas con x e y, pero al final llama a g
  g(a,b) //d es implícito aquí también
}
int main()
{
  //Prepara x e y
  Dato d; //Mi dato d que voy a usar como variable local
  //Preparo mi dato d
  implicit d; //Usa d como un implícito para Dato
  f(x,y) //El implícito para el tipo Dato es d.
         //Entonces, es como llamar a f(x,y,d)
}

Por supuesto, en este ejemplo sólo nos hemos ahorrado escribir d dos veces, pero en un programa real suele haber muchos más usos de este tipo de parámetros. Así que con estos parámetros implícitos se soslaya el inconveniente de no poder usar variables globales.

La coma serial

Una bagatela para finalizar. El título de esta entrada se llama "Coma serial, agujeros de gusano, gotos desnudos, e implícitos por tipo". Un lector atento habrá visto una escritura inusual de la enumeración. Concretamente usando la coma antes de la conjunción.

Este tipo de uso de la coma no es común en el español, pero en inglés sí que lo es. Se denomina la coma de Oxford, la coma de Harvard o la coma serial. Se usa para evitar ambigüedades como estas:

"Dedicado a mis padres, Juan y Ana." Bien. Los padres son Juan y Ana.
"Dedicado a mis padres, Juan, y Ana." Mmmm.... Los padres no son Juan y Ana. ¿Verdad?

En el caso del título podía confundirse "e implícitos por tipo " como si los goto fueran, además de desnudos, implícitos por tipo. No es el caso. Los implícitos por tipo son otra cosa. Para evitar la ambigüedad, usé la coma serial.

jueves, 23 de junio de 2011

Clasificación de los bugs

Leyendo a Walter Bright me he encontrado con la palabreja "heisenbug" que según él es un tipo de bug. Ya me imaginaba yo que tendría que haber una taxonomía de los bugs. El resumen de lo que he encontrado es este:
  • Bohrbug: Error sistemático que se da siempre cuando las condiciones lo propician.
  • Mandelbug: Error sistemático tan complejo que no parece sistemático, pero lo es.
  • Heisenbug: Error sistemático que desaparece cuando intentamos depurarlo. Ya sea por que estamos usando el depurador y cambia la estructura de la memoria, porque el código está compilado en modo de depuración o por otras razones.
  • Schrödinbug: Error oculto que, una vez descubierto, todo el mundo se tropieza con él.
  • Estadístico: Error que no se detecta en una única ejecución del programa, sino que hay que hacer una estadística de los resultados hasta darnos cuenta que no son como deberían ser. (Esto me recuerda a la minería de datos en los MMORPG)
  • Alfa bug: Error que ves una vez y no vuelves a ver. Lo que ocurría antiguamente cuando un rayo cósmico le daba a una celda de memoria.
Supongo que luego están los errores de condiciones de carrera, que aparecen cuando les da la gana si no se han sincronizado bien las hebras. Ya inventarán una palabreja para eso algún día.

martes, 5 de octubre de 2010

Enlaces de interés

Muy breve esta vez:

¿Cómo ser un (buen) programador?

¿Cómo es el lenguaje de programación ese? 

¿Uso un lenguaje dinámico o estático?

¿Qué tal programador soy?

jueves, 26 de agosto de 2010

La maldición del programador

No suelo trabajar de esta forma pero recientemente una persona, un cliente, estableció contacto conmigo para que le hiciera un pequeño programa de control para cámaras de vídeo. Realmente el programa es sencillo pero hay que conocer un protocolo serie. Cuando le di el presupuesto el cliente me dijo que era excesivamente caro y que "se lo pensaría" (ya sabéis lo que significa esto, ¿no?). Las razones que me dio fueron las siguientes:
  1. Me había dado toda la información del protocolo serie para controlar la cámara de vídeo.
  2. Él había sido programador durante años y sabía lo que costaba hacer el programa. Literalmente me dijo "te hago un GUI en unos minutos".
  3. No podía cobrarle la depuración porque no sabía, por anticipado, qué fallos iba a haber en el programa (o si iba a haberlos).
  4. Podía usar los recursos que él tenía en su nave industrial. No necesitaba nada para programar, aparte del ordenador.
  5. El programa era muy pequeño y "en un rato se hacía".
La verdad es que, desde cierto punto de vista inocente, tiene razón en todo lo que me decía. Sin embargo, la realidad es bien distinta.
  1. Después de estudiar y entender el protocolo serie (por cierto, no estándar) que me dio, descubrí que era otro protocolo el que realmente necesitaba ya que había un dispositivo "adaptador inteligente" que traducía de un protocolo a otro. A esta conclusión no llegué de inmediato sino que tuve que estar bastantes horas investigando. Además, esta investigación no fue a vuelapluma. Tuve que recurrir a conocimientos que me ha costado muchos años y esfuerzo tener. Por mucho menos un electricista te cobra un buen monto. Ni que decir tiene que, para poder hacer el presupuesto, tuve que estudiarme este segundo protocolo (por cierto, tampoco estándar).
  2. Yo también hago un GUI, no en minutos, en segundos. Cojo un lápiz y un papel y te dibujo unos cuadraditos que son los botones. Ya está. Claro que quizás él se refería a usar un programa donde pones los botones y con una opción te genera el código. Bueno, "el código" es sólo para poner los botones, nada de la lógica que hay detrás. Porque no querrá nadie que la cámara haga zoom cuando pulses el botón de apagado o que te diga que la cámara está encendida cuando no hay cámara conectada o que intente contactar por un puerto cuando está conectada a otro. Tampoco querrá nadie que no mande los checksums en el protocolo, que no respete la temporización o que ignore las respuestas del dispositivo diciendo que no está preparado para nuevas instrucciones. Y todo eso hay que programarlo y probarlo. Así que no es GUI todo el programa. De hecho, la mayor parte del programa es la lógica de control. Aunque no se vea. Es más, como no se ve, es la realmente difícil de programar y probar.
  3. Jamás he escrito un programa de más de 1000 líneas que no tuviera un fallo. Es verdad que la gran mayoría de fallos son tontos y, o bien los descubre el compilador, o bien los descubres rápidamente al ejecutar. Esto es cierto, pero también tiene una cara negativa: los errores que no descubres rápidamente son los difíciles. Los que ocurren al azar. Los que se detectan haciendo una operación en concreto tras haber hecho cinco antes de una forma dada. Los que no se ven, pero están. Y, en definitiva, los que más calentamientos de cabeza dan. A todo esto hay que añadir, en el caso de este cliente, que cada error que se descubra implica tener que coger el coche, ir a su nave, ver el problema y trabajar en campo. Hasta los fontaneros cobran los desplazamientos, ¿no?
  4. De hecho, no necesito nada para programar. No necesito ni el ordenador, me basta el cerebro. Los grandes programadores, los programadores muertos, escribían sus programas en papel. Concretamente, el papel de la revista en el que lo publicaban. Pero volvamos al mundo real. En un trabajo manual liberas tu mente.  Si estás apretando tuercas y pensando en la vecina del segundo no creo que tu trabajo se vea afectado. Esto no ocurre con la programación. En la programación tienes que pensar el programa. Si dejas de pensar en el programa, no avanzas. Es más, suele ocurrir lo contrario. Suele ocurrir que dejas de programar, te vas, no sé, a comer y ¡sigues pensando en el programa! Estoy viendo la tele ¡trabajando! De paseo, ¡trabajando! En la ducha, ¡trabajando! ¿Cuento o no cuento esas horas de trabajo? Y lo digo en serio porque la ducha es unos de mis momentos más productivos, cuando se me ocurren las mejores ideas de diseño que simplifican un programa drásticamente. ¿Y ahora, qué hacemos?
  5. Esto se relaciona con el punto 2. El famoso "yo fui programador aficionado". Esta frase deja entrever que "y programar es divertido". No te voy a pagar por algo que, si te diviertes, no es trabajo. Bueno, es que hay una diferencia, yo llevo 26 años programando y llega un momento en el cual no te divierte tanto. En el cual, es un trabajo. El problema es que el programador aficionado se pone con el ordenador y se divierte. Se le pasan las horas y cree que ha sido menos tiempo. Así que cuando dice "en un rato se hace" no tiene en cuenta que su visión de la programación está sesgada. Su "rato" fue en realidad de muchas horas. Claro que, con el tiempo, sólo se recuerdan las cosas agradables. Un rato agradable.
Aquí acabo. Siento haber escrito tanto. No puedo decir estas cosas a la cara del cliente. Ya me siento mejor. Ha pasado ya tanto tiempo, décadas, y seguimos a vueltas con lo mismo. ¿Podrá ver el cliente algún día que la programación es un trabajo muy duro, aunque no sea un trabajo físico? ¿Es esta la maldición del programador?

miércoles, 12 de mayo de 2010

Excepciones o asertos

Existen varios niveles de errores cuando se ejecuta un programa o parte de un programa.

En principio, el error puede ser un resultado correcto del mismo. En este caso más que un error es un resultado especial. Generalmente hay que atender a este resultado inmediatamente cuando se produce ya que es lo que le hemos pedido a la subrutina y lo que ésta nos devuelve. A esta técnica se la denomina código de error.

También puede ser que no sea un resultado correcto. Esto tiene dos consecuencias. En primer lugar toda la zona en la que se ha producido el error y que estaba trabajando para obtener ese resultado ha hecho un trabajo en balde. En segundo lugar, no tenemos que atender al resultado inmediatamente porque toda la zona ha quedado invalidada. Lo que tenemos es una excepción que será manejada después, cuando salgamos de la zona que estaba calculando ese resultado.

Finalmente, ocurre que es el propio estado del programa lo que es inválido. Los invariantes no se cumplen, las precondiciones fallan o ha ocurrido algo inesperado e irrecuperable. Obviamente esto no debe suceder nunca. En este caso hemos de usar asertos. Los asertos sólo se usan en depuración, así que si fallan en la versión de producción probablemente nuestro programa deje de funcionar.

Entonces, el algoritmo para decidir si usamos excepciones o asertos es el siguiente:

  1. ¿Si el hecho ocurre, puedo solucionarlo? Si la respuesta es NO, es un aserto.
  2. ¿Si el hecho ocurre, es parte del resultado? Si la respuesta es NO, es una excepción. (Se puede comprobar esto pensando ¿voy a solucionar el hecho más adelante?)
  3. En otro caso, es un resultado correcto del procedimiento o código de error.

jueves, 8 de abril de 2010

Comparativa de lenguajes de programación

Veremos tres comparativas. La primera es la comparativa de uso de TIOBE. Esta empresa hace una lista de los lenguajes de programación por la cantidad de desarrollos. Los lenguajes más usados están delante de los menos usados.

Es curioso observar que justamente este mes de abril del 2010 el lenguaje de programación C vuelve a estar en primera posición. Puesto que perdió durante un tiempo frente a Java. Es meritorio que el C siga dando guerra después de casi cuarenta años.

La segunda es la comparativa de velocidad Shootout. La gente de Debian realiza esta comparativa ejecutando los mismos programas en distintos lenguajes y compilados en ciertas plataformas. Después de usar la mediana como estimador más robusto, los ordena en las tablas que aparecen en el enlace.

Es sorprendente que justamente este mes de abril del 2010 el lenguaje de programación C sea el segundo más rápido. Sólo por detrás del C++, que es el primo hermano. Sorprende precisamente que en cuarenta años no se haya conseguido un lenguaje al menos tan eficiente como el C. Aunque es cierto que el ATS, el Java y el LUA con JIT están cerca.

Finalmente, una comparativa neutra es la que aparece en la Wikipedia. Es neutra porque no compara numéricamente los lenguajes, lo hace por sus capacidades. Así, compara la sintaxis, instrucciones básicas, cómo funcionan arreglos y arreglos asociativos, cadenas, comprensión de listas, orientación a objetos, metaprogramación y demás.


domingo, 28 de marzo de 2010

Contaminando datos

En la programación defensiva, existen varias formas de comprobar que los datos introducidos por el usuario no crean problemas de seguridad en nuestro código. La más usual es suponer que los datos están contaminados (no son fiables) hasta que se pruebe lo contrario.

Nota: A falta de mejor traducción, usaré "contaminado" por "tainted".

El funcionamiento es bien sencillo:

  1. Marcamos los datos que introduce el (potencialmente maligno) usuario como contaminados.
  2. Marcamos los datos que introduce el (supuestamente competente) programador como no contaminados.
  3. Las funciones con las que trabaja el programa sólo deben permitir utilizar datos no contaminados.
  4. El programador debe definir, adicionalmente, ciertas funciones de comprobación de la validez de los datos y quita de contaminación.

De esta manera en el único sitio donde hay que mirar por si hay problemas de seguridad es en las funciones de "descontaminación". Generalmente son muy pocas.

El caso clásico es cuando se quieren detectar desbordamientos de búfer. Hasta que no comprobemos que la cadena ofrecida por el usuario cabe en el búfer, no descontaminamos esa cadena. Este simple mecanismo, de descontaminar cuando se hace una comprobación de la longitud, puede aplicarse automáticamente al código fuente con una herramienta externa. Incluso, cuando no se estén marcando como contaminados los datos en el programa.

El resultado es que se encuentran los puntos donde se usan cadenas introducidas por el usuario sin haber comprobado antes la longitud. Algunos de estos usos inseguros pueden explotarse para introducirse maliciosamente en nuestro sistema.

En definitiva, el simple método de marcar los datos (o los tipos de los datos si hacemos el análisis estático) como contaminados o no contaminados tiene una incidencia directa en la seguridad de nuestro programa. Algunos lenguajes lo hacen así, como Ruby. Otros, no. 

miércoles, 24 de marzo de 2010

La ley de Fitts

La ley de Fitts es muy simple:

Cuanto más cerca esté y más grande sea, más fácil es pulsar un botón.

Esta simple ley es la piedra angular del desarrollo de interfaces gráficas de usuario. Desafortunadamente, parece ser que no se sigue todo lo que debiera.

domingo, 8 de noviembre de 2009

Buscando el siguiente orden de magnitud

Viendo esta entrevista con John Hughes (creador de QuickCheck) me he quedado pensando sobre el último párrafo.

If you compare Haskell programs to C code or even C++ often, they are about an order of magnitude smaller and simpler. The same is for Erlang, those results are being validated in the industry. Where is the next order of magnitude coming from? I wish I had an answer to that question because it's hard to see almost. When you look at a beautiful Haskell program, how could this be 10 times shorter? But I think we need to be asking ourselves that kind of question. If I had a good idea there, I would spend the rest of my career working on it.

Realmente parece difícil reducir más un programa Haskell, como por ejemplo su versión de quick sort.

qsort [] = []
qsort (x:xs) = qsort (filter (<>= x) xs)

Comparada con la de C...

void qsort(int a[], int lo, int hi) {
{
int h, l, p, t;

if (lo < hi) {
l = lo;
h = hi;
p = a[hi];

do {
while ((l < h) && (a[l] <= p))
l = l+1;
while ((h > l) && (a[h] >= p))
h = h-1;
if (l < h) {
t = a[l];
a[l] = a[h];
a[h] = t;
}
} while (l < h);

a[hi] = a[l];
a[l] = p;

qsort( a, lo, l-1 );
qsort( a, l+1, hi );
}
}

¿De dónde va a salir el siguiente orden de magnitud?

domingo, 1 de noviembre de 2009

La parábola de los dos programadores

Es un texto antiguo, pero no tiene desperdicio. Lo he dejado tal y como estaba (tiene algunas faltas de ortografía pero se lo perdono al traductor. Entre otras cosas, no sé quién es):


LA PARABOLA DE LOS DOS PROGRAMADORES


Erase una vez las empresas "AAAA-AUTOMATED ACCOUNTING APPLICATIONS
ASSOCIATION" y la "CCCC-CONSOLIDATED COMPUTERIZED CAPITAL
CORPORATION", desconocidas entre si. Ambas decidieron que necesitaban
el mismo programa para prestar un determinado servicio.

AAAA contrato a un analista-programador, Alan, para que resolviera
el problema.

Por su parte, CCCC decidio encargar el trabajo a un programador
junior,recien contratado para comprobar si era tan bueno como decia.

Alan, que poseia experiencia en la realizacion de proyectos de
programacion dificiles, decidio emplear el metodo PQR de disenyo
estructurado.

En funcion de ello, solicito a su jefe de departamento que nombrase a
otros tres programadores para formar un equipo de programacion. A
continuacion el equipo puso manos a la obra, elaborando cantidad de
informes previos de analisis del problema.

En CCCC, Charles dedico un tiempo a considerar el problema. Sus
companyeros de trabajo observaban que a menudo se sentaba con los pies
sobre su escritorio, mientras bebia cafe. A veces se le veia sentado
frente al terminal,pero su compayero de oficina podia adivinar que en
realidad estaba jugando a marcianitos, por su forma ritmica de
teclear.

A esta alturas, el equipo de AAAA estaba empezando a codificar.
Los programadores dedicaban la mitad de su tiempo a escribir y
recopilar codigos y pasaban el resto del dia reunidos, hablando de las
interfaces entre los diversos modulos.

El companero de oficina de Charles advirtio que este finalmente
habia dejado de jugar a marcianitos. En lugar de ello, su tiempo
transcurria bebiendo cafe con sus pies sobre la mesa y haciedo
garabatos en trozos de papel. Por sus garabatos no se podia decir que
estuviese jugando a "tres en raya" pero tampoco parecian tener mucho
sentido.

Han pasado dos meses. El equipo de AAAA ya ha elaborado el
calendario de implantacion del programa. Dentro de dos meses tendran
la primera version del mismo. Tras un periodo de dos meses mas, para
verificarlo y mejorarlo deberia quedar concluida la version completa
del mismo.

En este momento, el jefe de Charles ya se ha cansado de verle
holgazanear. Decide enfrentarse a el. Pero cuando se dirige a su
oficina se queda sorprendido de verle muy enfrascado, introduciendo
codigos en el terminal. Asi que decide prorrogar el encuentro, hablan
un poco y se marcha. No obstante, empieza a vigilar de cerca a
Charles, para enfrentarse a el en cuanto se le presente la ocasion.
Como en realidad no deseaba tener una conversacion desagradable le
alegra comprobar que Charles parece estar ocupado la mayor parte del
tiempo.

Incluso se le ha visto ir tarde a comer y quedarse a trabajar fuera
de horas de oficina dos o tres dias a la semana.

Transcurridos tres meses, Charles anuncia que ha finalizado el
proyecto, presenta un programa de 500 lineas. El programa esta
escrito con claridad, y una vez verificado, ejecuta todo lo que se le
exigia.

De hecho, posee incluso unos rasgos adicionales que podrian mejorar
en gran medida la rentabilidad del programa. Este se somete a prueba
y, con excepcion de un descuido que se corrige rapidamente, funciona
de manera satisfactoria.

El equipo de AAAA ya ha conlcuido dos de los 4 modulos principales
que configuran su programa. Mientras se elaboran los dos restantes,
aquellos se someten a prueba.

Tres semanas despues, Alan anuncia que ya esta lista la version
preliminar del programa una semana antes de lo previsto. El programa
se somete a prueba.

Los usuarios detectan una serie de fallos y deficiencias, a parte de
los previstos. Como Alan aclara, no hay de que extranyarse. Despues
de todo, se trata de una version preliminar en donde los fallos son
normales.

Transcurridos unos dos meses mas, el equipo ha concluido su version
definitiva del programa. Esta constituida por 2500 lineas de codigo.

(Si esto parece exagerado, pregunte a cualquiera que normalmente da
cursos de informatica en los que se exigen proyectos de programacion.

Es bastante tipico un ratio de 5 a 1 entre el programa mas largo y
el mas corto, y normalmente estos ultimos son los mejores.) Una vez
verificada, parece satisfacer la mayor parte de lo que se pedia.
Contiene un par de omisiones, y el formato de su input de datos es muy
confuso. Sin embargo, la compania decide instalar el programa;
siempre puede instruir al personal de entrada de datos para que lo
hagan en el formato requerido. Se remite el programa a algunos
programadores de matenimiento para que subsanen las omisiones.

Desenlace:

En un principio, el supervisor de Charles se quedo impresionado,
pero a medida que iba leyendo el codigo fuente, se dio cuenta de que
el proyecto era en realidad mucho mas sencillo de lo que habian
pensado.

Ahora parecia claro que no representaba un reto ni siquiera para un
programador principiante. Charles habia hecho cinco lineas de codigo
por dia. Representaba un promedio superior al normal. Pero, teniendo
en cuenta la sencillez del programa no tenia nada de excepcional.

Ademas, su supervisor no olvidaba los meses que habia estado
haciendo el vago.

En la revision salarial siguiente, Charles recibio un aumento igual
a la mitad correspondiente a la mitad de la inflacion correspondiente
a dicho periodo. No se le ascendio de puesto. Al cabo de un anyo
aproximadamente, abandono CCCC desanimado.

En AAAA, Alan recibio felicitaciones por haber concluido el proyecto
en el tiempo previsto. Su jefe echo un vistado al programa. Despues
de hojearlo durante unos minutos, vio que en el se respetaban las
normas de la companyia sobre la programacion estructurada. No
obstante rapidamente desecho la idea de leerse todo el programa;
parecia bastante incomprensible. En este momento se daba cuenta de
que el proyecto era en realidad mucho mas complejo de lo que habia
pensado en un princicpio y felicito a Alan por su trabajo.

Cada programador del equipo habia producido 3 lineas de codigo por
dia. Era un promedio normal, pero, teniendo en cuenta la complejidad
del programa, podia considerarse como excepcional. Se concedio a Alan
un elevado aumento de sueldo y se le ascendio a Analista de Sistemas
en recompensa a su trabajo.

Epilogo:

Se invita al lector a extraer sus propias conclusiones.

Nail W. Rickert.
Departamento de Matematicas,
Estadistica e Informatica.
Universidad de Illinois, Chicago.
(NOVATICA V. XII-67 Programofilia)

martes, 22 de septiembre de 2009

Compatibilidad hacia atrás en lenguajes

Una cosa que nunca he entendido es la cerrazón de los diseñadores de lenguajes de programación en mantener la compatibilidad hacia atrás. Esto ha hecho que los lenguajes empiecen a tener complicaciones innecesarias y, como no se pueden quitar, cada vez habrá más complicaciones innecesarias.

¿Por qué no usar una opción en el compilador que regule la versión que queremos usar de una característica del lenguaje? Tenemos infinidad de opciones en el compilador: tipo de biblioteca en tiepo de ejecución, definición de símbolos, grado de optimización, juego de caracteres a usar, directorios de inclusión, etc. ¿Qué ocurriría si añadiésemos una más indicando la versión del código?

Quizás la única parte que no se debería tocar es la de las interfaces ya que tendrían que interoperar y eso implicaría mantener su versión, pero el resto es modificable. Así, los lenguajes irían refinándose. Los códigos antiguos (legacy) seguirían funcionando. ¿Qué problema hay que no atino a ver para que no se use esto?

domingo, 9 de agosto de 2009

Punteros y demás hierbas

¿Qué maneras hay de referenciar un objeto en un programa? Que se me ocurran:

  • Referencia: Es la idea general de tener un valor que representa otra cosa. Realmente todos los mecanismos que vamos a ver son referencias. Nota: En algunos lenguajes como el C++ las referencias son concretamente una mezcla entre puntero y alias. 
  • Alias: Damos un nombre para el objeto. Usamos ese nombre para referenciarlo. Los alias no están reificados. Es decir, no existen durante la ejecución de un programa. Si así fuera, necesitaríamos algún tipo de almacén para guardar la relación nombre-objeto y estaríamos hablando de un identificador (ver más abajo). Entonces, un alias es un mecanismo externo al programa. Por ejemplo, los nombres de variables que viven en el compilador y se olvidan antes de llegar al programa ejecutable. Esta idea de "ser externo al programa" o "no sabido por el programa" lleva a la idea de alias como algo "no querido" que es el aliasing (múltiples referencias desconocidas para el mismo objeto).
  • Puntero: Es la dirección de memoria donde está el objeto. Generalmente los punteros son mala idea porque no abstraemos. Realmente nos da igual la dirección de memoria en concreto, lo que nos interesa es el objeto. Esto hace que haya limitaciones a la hora de usar el puntero. Por ejemplo, si el objeto se mueve a otra dirección de memoria, el puntero queda invalidado. El saber la dirección donde está el objeto significa que llegar a él es muy rápido. De complejidad O(1) (constante).
  • Índice: Si el objeto está en una colección lineal de objetos, se puede llegar al objeto en concreto sabiendo su posición dentro de la colección. Eso es el índice. En este caso no nos liamos con direcciones de memoria, aunque necesitamos una colección y que la colección esté ordenada de forma que podamos contar las posiciones. De hecho, nada impide que la colección esté en otro sitio en vez de memoria como un fichero en disco o en algún dispositivo de entrada/salida. Aunque, en general, se intenta que la complejidad de acceso al objeto sea O(1) (constante).
  • Identificador: Si el objeto está en un diccionario, se puede llegar al objeto en concreto sabiendo su clave dentro del diccionario. Eso es el identificador o asidor (handle) del objeto. Este identificador ya no tiene por qué ser numérico. Ahora puede ser un número (aunque no relacionado con una colección lineal), un nombre, una estructura compleja o cualquier cosa que sea comparable (y ordenable por motivos de eficiencia). Tampoco hay aquí problema con las relocalizaciones del objeto siempre y cuando se mantenga actualizado el diccionario. Eso sí, usualmente los identificadores tardan más en resolver la referencia (llegar al objeto) con una complejidad, en los casos usuales, de búsqueda en el diccionario. Sería O(log n) para árboles y O(n) amortizada para tablas hash.
  • Iterador: Es la abstracción de lo anterior. Un iterador es una posición, pero no de memoria. Es una posición abstracta. Podría ser un puntero, un índice, un identificador o cualquier otra cosa. El nombre de iterador proviene del hecho de que la operación más común que se suele realizar sobre él es "pasar a la siguiente posición" para recorrer colecciones (lo que se llama iterar). Sin embargo, su noción más abstracta es la de posición y existen iteradores que no iteran. Esta variedad hace que sea imposible dar una complejidad para los iteradores, cada tipo tendrá su complejidad a la hora de llegar al objeto que referencian.
  • Rangos: Extienen la idea de referencia a un objeto a referencias a colecciones de objeto. Como se sale un poco de la pregunta inicial, sólo dejaré constancia de su existencia.

viernes, 31 de julio de 2009

Patrón decorador

Los patrones de diseño no son más que una manera conocida de resolver problemas. Incluso sin saber lo que son, es probable que cualquier programador los haya usado sin querer. Esto es así porque muchas veces son la solución más lógica y no dependen del lenguaje de programación que se use.

El patrón decorador se basa en el siguiente problema. Tengo una clase C y por alguna razón no puedo o no quiero tocarla, pero tendría que hacer algo que no hace. Es más, esta nueva funcionalidad ni siquiera necesita que modifiquemos su interfaz I (por lo que los usuarios de la clase ni se van a enterar que estoy modificando la funcionalidad por debajo).

La solución que propone el patrón decorador es crear otra clase D que implemente esta interfaz y que envuelva a la clase C. Cuando ejecutamos los miembros del interfaz de D, hacemos lo que tengamos que hacer como si fuéramos la clase C y, si fuera necesario, usamos la clase C que envolvemos. Es decir, suplantamos la clase C.

Ya está. Fácil, ¿no? Bueno, podemos refinar porque aún tenemos algunos problemillas. Si quiero agregar varias funcionalidades a C tendría que hacer una clase D1, D2..., pero también la que combina ambas cosas D12 (Imaginemos que C es un texto y las D son el tipo de letra. Entonces D1 sería "negrita", D2 sería "cursiva" y D12 "negrita y cursiva"). Si tuviera D1, D2, D3, D4... las combinaciones serían muchas. Es lo que se denomina una explosión exponencial.

Afortunadamente, la clase D puede envolver en vez de una clase C, una clase de interfaz I. Esto incluye otras clases D. En este caso, si escribo que D envuelve a C así D(C), la modificación D12 sería D1(D2(C)). Esto me evita tener que escribir clases compuestas D12, D24, etc y evito la explosión exponencial.

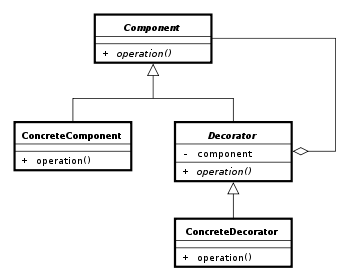
Por último, y para seguir la ley DRY, es conveniente que todas las clases D1, D2... deriven de una clase D común de "envoltura básica". Esto nos lleva al esquema usual del patrón decorador tal y como viene en la Wikipedia.

Donde

  • "Component" es la interfaz común I.
  • "ConcreteComponent" es la clase C que queremos modificar pero no tocar.
  • "Decorator" es la clase base D de otros decoradores D1, D2... Esta clase lo único que hace es contener (envolver) un objeto de interfaz I.
  • "ConcreteDecorator" son las clases D1, D2... que tengamos que implementen la nueva funcionalidad.

sábado, 27 de junio de 2009

Consejos para APIs

Leo en el blog de lightsleeper unos consejos para hacer APIs.

  • Deben ser intuitivas. Los nombres han de ser significativos y deben dar una idea de lo que hacen las funciones sin tener que leer los documentos.
  • Deben ser simples. Es decir, seguir el principio KISS y si pueden hacer sólo una cosa en vez de dos, mejor. Cuantos menos parámetros mejor, cuantas menos funciones mejor, cuantos menos tipos mejor.
  • Debe ser difícil equivocarse. Con pocos estados, pocos errores y con un tipado que evite que compile si se intentan hacer cosas mal. Los fallos se deben detectar en compilación y no en ejecución.
  • No deben tener efectos secundarios. Realmente esto es parte de la simplicidad. Tener estados ocultos, variables globales perdidas y demás complica la cosa.
  • Debe ser consistente. En el nombrado de funciones y parámetros, en el orden de las mismas, en la nomenclatura de tipos, variables y demás opciones estilísticas. También deben usarse las convenciones conocidas ("ptr" es puntero y no "poi", etc.)

Hay un par de puntos relativos a la hora de revisar las API que no voy a incluir porque prefiero este punto que leí en algún otro lado:

  • La regla del tres: Haz tres programas que usen la API. Si usas uno, seguro que luego te van a faltar o sobrar cosas. Si usas dos te quedarán bugs y sutilezas. Con tres también, pero serán menos y la API será usable.

Finalmente, otro consejo que leí por ahí tiempo ha:

  • Una API es un lenguaje. Cada palabra debe ser un concepto. Cuando dos desarrolladores hablen de tu API deben hacerlo en ese lenguaje especial que has inventado.