Mostrando entradas con la etiqueta programación genérica. Mostrar todas las entradas

domingo, 19 de mayo de 2013

Álgebras y coálgebras

He encontrado varias veces por Internet la pregunta de qué es un coálgebra y las respuestas han sido más o menos liosas. El motivo es que en computación al hablar de (co)álgebras nos referimos a las F-(co)álgebras. Lo que implica explicar qué es la F y esa F es un funtor. Un funtor es una operación en categorías y hay que introducir parte de la teoría de categorías para explicarlo.

Puede hacerse más simple.

El producto cartesiano generalizado

Estrictamente hablando el producto cartesiano es una operación entre dos conjuntos.[$$A\times B$$]El resultado es otro conjunto y sus elementos son los pares ordenados de forma que el primer elemento se obtenga del primer conjunto y el segundo elemento del segundo. En notación matemática:[$$A\times B = \{ (a,b) \mid a\in A, b\in B \}$$] Cuando hacemos dos productos cartesianos, surge la duda de si es asociativo o no.[$$A\times (B \times C) \overset{?}{=} (A\times B)\times C$$] En general el producto cartesiano no es asociativo, ya que [$(a,(b,c))\ne((a,b),c)$], pero nada impide usar un producto cartesiano generalizado (que escribiré entre paréntesis) en el cual el producto de tres conjuntos no sean pares, sino triplas. [$$(A\times B \times C) = \{ (a,b,c) \mid a\in A, b\in B, c\in C \}$$] El de cuatro conjuntos serían cuadruplas y el de [$n$] conjuntos lo que llamaremos [$n$]-tuplas. [$$(A_1\times\cdots\times A_n) = \{(a_1,\dots,a_n) \mid a_1\in A_1,\dots,a_n\in A_n \}$$] Usaremos este producto cartesiano generalizado.

Antes de acabar este apartado sólo resta destacar un caso particular. El del producto cartesiano de cero conjuntos. Llamaremos a este conjunto [$1$] y sólo contiene un elemento que es la tupla vacía [$()$].

Esta definición no debe ser extraña si seguimos la siguiente secuencia. [$$(A\times B \times C) = \{ (a,b,c) \mid a\in A, b\in B, c\in C \}$$][$$(A\times B) = \{ (a,b) \mid a\in A, b\in B \}$$][$$(A) = \{ (a) \mid a\in A \}$$][$$1 = \{ () \}$$]

Algebras

La idea de usar álgebras proviene de tomar un tipo de datos como sus valores y las operaciones que los construyen por inducción. Por ejemplo, en el caso de una lista, estos constructores serían.
  • La lista vacía. Lo que se ha venido a llamar la constante nil.
  • Añadir un elemento a la lista. Función que se llama cons.
Las constantes se expresan como funciones que no toman argumentos (mejor dicho, toman la tupla vacía), por lo que si la lista es de enteros y llamo al tipo de esta lista [int], el tipo de cada una de estas funciones sería: [$$nil : 1 \to [int]$$]Que no toma argumentos y devuelve la lista de enteros vacía y[$$cons : (int \times [int]) \to [int]$$]Que toma un entero y una lista de enteros y devuelve otra con este elemento añadido.

Teniendo en mente estas funciones, decimos que el tipo lista de enteros [int] no es más que el conjunto de sus valores (que llamaré [$A_{[int]}$]) y las dos funciones que los construyen por inducción. [$$(A_{[int]}, nil : 1\to[int] , cons : (int \times [int]) \to [int] )$$]Muy similar a, por ejemplo, un monoide [$$(M,e:1 \to M ,\otimes:(M\times M)\to M )$$] donde [$M$] son los elementos del monoide, [$e$] el elemento neutro y [$\otimes$] la operación interna. O a la definición de los números naturales[$$(N,cero:1\to N, suc:N \to N)$$] donde [$cero$] es la constante cero y [$suc$] la operación que obtiene el siguiente número natural (el sucesor).

Generalizando de nuevo, vemos que todas estas definiciones tienen siempre la misma estructura.[$$(A, f_1: X_1 \to A,\dots, f_n: X_n \to A)$$]Donde los [$X_i$] son productos cartesianos de conjuntos en los cuales puede estar el propio [$A$] o no.

Bien. Eso es un álgebra. Un conjunto y varias operaciones cuyo codominio es tal conjunto.

Coálgebras

En un coálgebra lo que tenemos es [$$(A, f_1: A\to X_1,\dots, f_n: A\to X_n)$$] En este caso las operaciones tienen el conjunto en su dominio.

¿Qué significado tiene esto?

Pensemos en una lista. La operación cons tomaba una lista y un elemento e introducía ese elemento en la lista.

cons(7,[1,2,3])=[7,1,2,3]
cons(9,[8,1,3])=[9,8,1,3]
cons(4,[])=[4]

El tipo de cons era [$(int\times [int])\to [int]$]. En una coálgebra la operación correspondiente (que llamaremos headtail) deberá tener el tipo [$[int]\to(int\times [int])$] lo que significa que de una lista obtenemos un elemento y otra lista. Una forma de ver esto es pensar que, en la coálgebra, la operación headtail extrae un elemento de la lista. En general, las operaciones de una coálgebra deshacen lo que los constructores hacían en las álgebras. Por esta razón a las operaciones de una coálgebra se las denomina destructores.

headtail([1,2,3])=(1,[2,3])
headtail ([8,1,3])=(8,[1,3])
headtail ([])=????

¿Qué pasó en este último ejemplo? ¿Es realmente headtail una función sobre las listas o sólo sobre las listas no vacías?

Existen dos respuestas aquí.

La primera respuesta es introducir los tipos suma. De esa manera, headtail podría devolver un error sumando el conjunto unidad al tipo de su codominio ([$headtail: [int]\to 1+(int\times [int])$]). Esto es dual a la agrupación de todas las operaciones del álgebra de la lista en una única operación sumando sus dominios ([$nilcons: 1+(int\times [int])\to [int]$]) y por esta vía definimos el funtor polinómico [$F X = 1+(X\times [X])$] y llegamos a las F-(co)álgebras que es de lo que realmente estamos hablando.

Aún introduciendo la posibilidad de que headtail acabe de leer una lista, no significa que lo haga. Usar coinducción permite trabajar con listas infinitas en las cuales siempre podemos ir extrayendo elementos. Esto nos lleva a...

La segunda respuesta es modificar nuestro tipo de datos y decir que no trabajamos con listas, sino con listas infinitas (los llamados streams). Como la lista es infinita, nunca va a estar vacía y siempre podremos usar headtail. Estos tipos de datos infinitos definidos por coálgebras y coinducción se denominan codatos. Son útiles para modelar, por ejemplo, la entrada del usuario que, en principio, nunca acaba.

miércoles, 11 de mayo de 2011

El punto de la pereza

Hace unos días Bob Harper, que defiende SML con uñas y dientes, se dedicó a atacar a los elitistas del Haskell. Su idea era muy sencilla: los tipos de Haskell no son inductivos. Voy a intentar explicar esto de forma sencilla.

Tipos inductivos

Son los tipos cuyos valores se construyen con unos valores bases y unos constructores. El caso arquetípico son los números naturales.
  • El 0 es un valor base.
  • El siguiente número natural S(n), es un constructor que, dado un número, construye otro.
Con esto y la inducción estructural tenemos los números naturales (y podemos demostrar propiedades sobre ellos).
  • El cero es 0
  • El uno es S(0)
  • El dos es S(S(0))
  • Y así.
También es posible usar como argumento de un constructor el valor de otro tipo. Este otro tipo será un parámetro del nuevo tipo. De esa manera aterrizamos en los tipos algebraicos. Por ejemplo, las listas de valores de un tipo T que llamaremos L(T) será.
  • La lista vacía [] es un valor base.
  • El constructor de lista  cons(V,R) toma un valor V de un tipo T y el resto de la lista R de tipo L(T).
Con esto y la inducción estructural, obtenemos las listas que queramos (y podemos demostrar propiedades sobre ellas).
  • Tomamos la lista vacía [] como valor base de una lista de enteros L(int)
  • Añadimos  un entero  cons(-3, [])
  • Añadimos otro entero  cons(7, cons(-3, []) )
Todos estos tipos inductivos tienen una forma muy similar si se dibujan: son bosques de árboles (matemáticamente son órdenes parciales completos, también llamados dominios). En concreto, los números naturales son un árbol de una única rama.
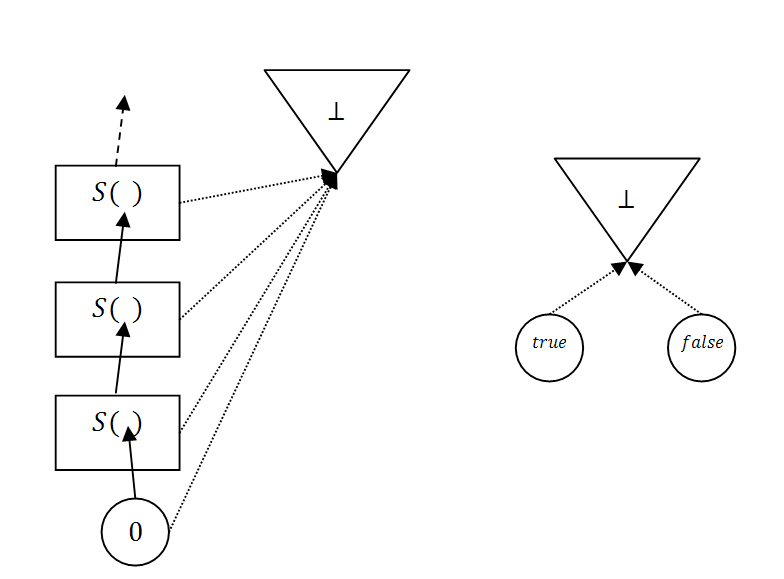
Los números naturales son inductivos. El valor base es el 0, en un círculo, y el constructor es S(n), en rectángulos. De esta manera tenemos representados en la figura, de abajo arriba, los valores 0, S(0), S(S(0)), S(S(S(0))) y así sucesivamente.
Los booleanos son dos árboles sin ramas.
Los booleanos son dos valores base: true y false. No hay constructores. Estos tipos sin constructores suelen llamarse tipos enumerados.

Las listas de naturales son árboles con infinitas ramas ya que, cada vez que usamos un constructor con un natural distinto, generamos una nueva rama. Es difícil dibujar esto porque cada una de las infinitas ramas lleva a infinitos valores que, a su vez, vuelven a tener infinitas ramas. Con un poco de imaginación el diagrama sería algo así.
Lista de naturales. La lista vacía es el valor base [] que está abajo. A partir de él construimos infinitos valores, uno para cada natural. Serían las listas de un único natural. Asimismo, de cada uno de estos valores se obtienen otros infinitos valores. A este tipo de árboles infinitos pero con una estructura simple se los denomina árboles regulares.

Existen también los llamados tipos coinductivos en los cuales, en vez de tener una lista vacía (valores base) y usar constructores sobre ella, tenemos una lista llena (valores co-base) y usamos destructores (co-constructores) sobre ella. No hablaré mucho más de esto aquí.

Evaluación perezosa 

La evaluación perezosa, de la que hablamos alguna que otra vez, consiste básicamente en no evaluar hasta que no sea estrictamente necesario. Un caso clásico es la multiplicación por cero.

0*(7+5)

¿Para qué sumar siete y cinco si sabemos que al final la multiplicación va a ser cero? Bueno, existe un motivo por el que evaluar los argumentos y son los efectos laterales. Si en vez de sumar dos números imprimiésemos un mensaje, la cosa cambia.

0*(print "hola") 

Ahora sí que habría que imprimir "hola" aunque el resultado de esta multiplicación (si es que print devuelve un número, claro) sea cero. Pues bien, ocurre que en Haskell no hay efectos secundarios. Es un lenguaje funcional. En este lenguaje de programación sí que conviene no perder tiempo evaluando cosas que, al final, no se van a usar.

La idea fundamental de la crítica de Harper es que siempre existen los efectos secundarios. En concreto existe un efecto secundario que jamás puedes quitarte de encima en un lenguaje de programación Turing completo. Ese efecto es... que la computación no termine.

Imaginemos el siguiente programa:

f(x) = 1+f(x)  //Esta computación no termina 
0*f(3) 

Si el lenguaje es estricto y evalúa f(3), nunca llega a ejecutar la multiplicación. Si el lenguaje es perezoso y no evalúa f(3), la multiplicación ha aceptado un valor que no es un número (de hecho ni siquiera es un valor, es no terminación) y lo ha tratado como si fuera un número. ¿Cuál es el tipo del argumento que ha aceptado la multiplicación?

Los lenguajes con evaluación perezosa cuelan entre los valores de sus tipos la no terminación. O mejor dicho, algo todavía sin evaluar que puede ser no terminación o puede ser un valor concreto. Este valor tan especial que se puede convertir en otro (o no) se corresponde con el mínimo de un orden parcial completo con mínimo. Este mínimo tiene el nombre de "punto" y se suele representar con el símbolo [$\bot$].

Si añadimos el punto a los tipos inductivos el resultado es que ¡no son inductivos! Los naturales y los booleanos quedan algo así.
Los naturales y booleanos con punto. El punto representa la no evaluación (con la no terminación como posibilidad). El punto está más allá de la inducción. No se pueden usar técnicas inductivas para demostrar propiedades de él.
Esto rompe la posibilidad de usar la inducción estructural porque el punto queda más allá, más arriba, del resto de valores. Así que, según Harper, usar la evaluación perezosa es equivalente a olvidarse de la inducción estructural y, con ella, poder demostrar con facilidad múltiples propiedades en nuestro programa.

Epílogo

Por supuesto, esto es todo cuestión de compromisos. Usar evaluación perezosa abre la puerta a tener tipos coinductivos con mucha facilidad. De hecho la "lista llena" de la que hablé antes es precisamente el punto [$\bot$]. Una computación que puede no terminar, una lista infinita, de la cual vamos extrayendo valores, como los iteradores. Esto permite cosas nuevas como el uso de la composición en estos tipos coinductivos, lo que abre la posibilidad a la reutilización de código.

miércoles, 16 de marzo de 2011

Mónadas en un plis-plás

Como no hay blog de informática teórica que se precie sin un tutorial de mónadas, y aprovechando que Milewski está dedicándole unos posts a esto, voy a explicar cómo entendí lo de las mónadas (si es que lo entendí, claro).


De los efectos secundarios y de cómo evitarlos

Supongamos esta función.

int f(int x)
{
  a=x+2;
  return x*3;
}

Realmente, está haciendo dos cosas: retornar el triple y asignar el argumento más dos a una variable externa “a”. Esta segunda acción es lo que se llama un efecto secundario porque modifica el estado global del programa. En este caso, el valor de “a”.


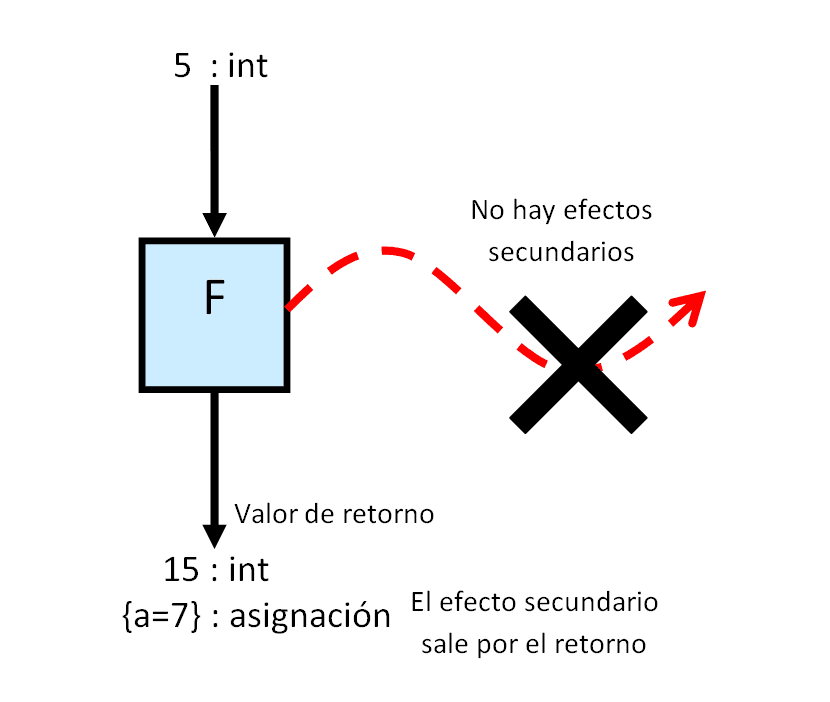
Muchas veces no es conveniente tener efectos secundarios: se simplifica la concurrencia, se permite la transparencia referencial, se permiten más optimizaciones, facilita la comprensión del programa, etc. Si queremos evitar que la función “f” tenga efectos secundarios la única solución es forzar a que éstos sean devueltos también por el retorno. Llamaremos a esta nueva función “F” para distinguirla de la original “f” con efectos secundarios.


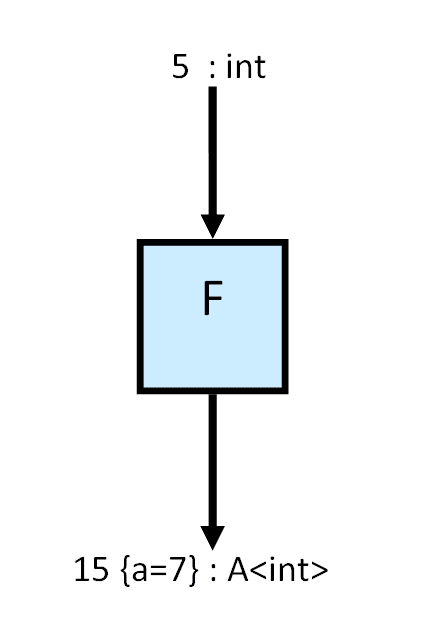
El problema ahora es que tenemos que devolver dos tipos. Además, no hemos dicho nada de que la función “f” pueda hacer más de una asignación. Tampoco hemos hablado de cómo cambia este nuevo retorno el estado global. Lo mejor es abstraernos de todos estos detalles y decir que “F” devuelve asignaciones y un entero. Inventaremos el tipo “A<int>” para eso usando un constructor de tipos "A".


Así que “F” vuelve a ser una función normal y corriente con un tipo a devolver exótico que engloba tanto el retorno normal (el entero) como los efectos secundarios (las asignaciones).

¡Pero hemos perdido una operación fundamental en la programación! ¿Cómo hacemos composiciones? ¿Cómo hacemos cosas como “f(f(5))”? Ahora que los tipos no coinciden, ¡no es posible escribir “F(F(5))”!


La solución pasa por hacer explícita la aplicación. ¿Pero qué es una aplicación explícita?


De la aplicación explícita y las restricciones que la composición le impone

En esta sección sólo hablaremos de cosas conocidas: funciones puras sin efectos secundarios. Llamaremos “g” y “h” a estas funciones puras. Nos olvidaremos por ahora del tipo “A<int>” y de las funciones “f” y “F” con efectos secundarios.

La aplicación explícita es sencillamente escribir “apply(x, g)” en vez de escribir “g(x)”.


Es únicamente un cambio en la notación, pero nos permite estudiar las propiedades de “apply” y realizar cosas tan potentes como la defuncionalización (de la que no hablaremos aquí). En concreto, para que “apply” sea coherente con la composición, debe mantener sus dos propiedades: elemento neutro y asociativa.

Para el elemento neutro hemos de introducir una función identidad. La llamaremos “id” y devuelve su argumento sin hacer nada de nada.

int id(int v) {return v;} //Función identidad de los enteros

Obviamente, componer esta función no debe hacer nada.

apply(x, id) == x
apply(id(x), g) == g(x)

Para la asociativa introduciremos una función compuesta “h” que aplique consecutivamente dos funciones “g1” y “g2”. En notación matemática escribiríamos [$h=g_2 \circ g_1$].

int h(int v) { return apply(g1(v), g2); }

Entonces, aplicar esta función compuesta “h” es igual que aplicar consecutivamente “g1” y “g2”.

apply(v, h) == apply(apply(v, g1), g2)

Con esto estamos seguros de que “apply” se comporta correctamente para la composición y podemos volver a pensar cómo solucionar el problema de la composición de la función “F”.

Nota: La propiedad asociativa aquí expuesta no parece ser la propiedad asociativa de toda la vida, pero si usamos “@” como operador infijo para el “apply” y la composición, entonces la propiedad queda algo así como “v@(g1@g2) = (v@g1)@g2” lo cual sí que se parece ya a la propiedad asociativa usual.

De la mezcla de efectos secundarios con aplicaciones explícitas

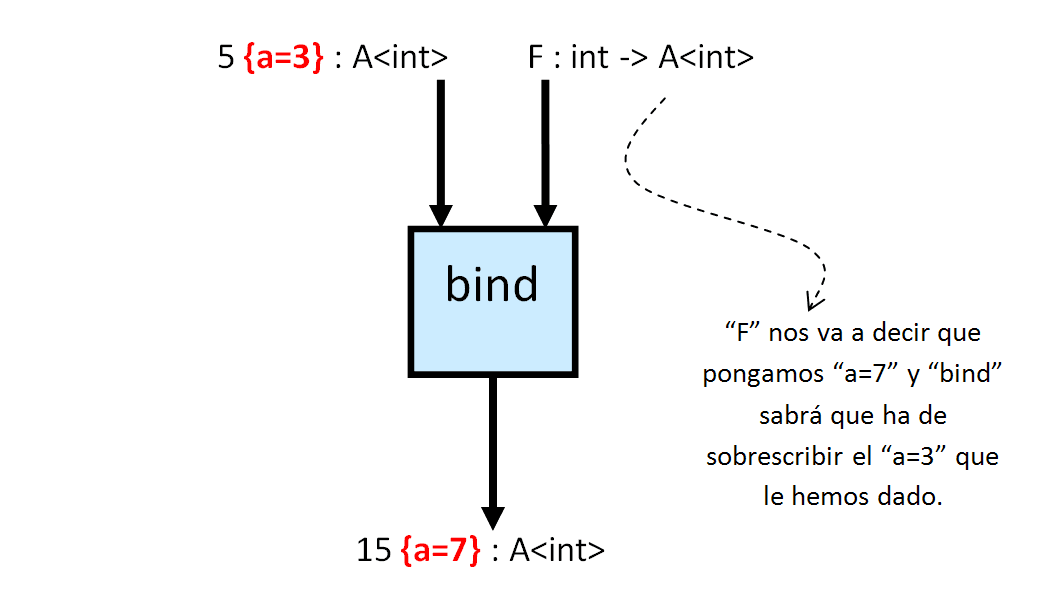
Lo interesante de hacer explícita la aplicación es que podemos adaptar el tipo de la misma a nuestros requisitos. Llamaremos “bind” a la aplicación con el tipo “A<int>” sobre funciones de tipo “int -> A<int>”, para no confundirla con “apply” que funciona sobre “int” y funciones “int -> int” únicamente.

apply: int -> (int->int) -> int
bind: A<int> -> (int -> A<int> ) -> A<int>


El truco está en que “bind(xx, F)” toma los efectos secundarios de “xx” y los mezcla con los efectos secundarios del resultado de “F” para luego devolverlos en su resultado.


Pero queda el asunto de la composición que nos forzó a introducir el “bind”: debe cumplir exactamente las mismas propiedades que “apply”.

La única salvedad es que “id” no debe ser la función identidad de los enteros. Tenemos que mantener el tipo “int -> A<int>” en las funciones. Así que se ha de convertir en una función que toma un entero y devuelve un “A<int>” de la manera más neutra posible. Es decir, sin efectos secundarios. También vamos a cambiar el nombre de esta función para no confundirla con la “id” original y la vamos a llamar “unit”.


Pues bien. Estas tres cosas son una mónada:
  • Un constructor de tipo como “A” que dado un tipo de retorno como “int” devuelve un tipo “A<int>” que engloba tanto ese tipo de retorno como los efectos secundarios.
  • Un par de funciones “bind” y “unit” que tienen los tipos antes mencionados.
  • Que se cumplan las propiedades de elemento neutro y asociativa.
Nota: El lector con conocimientos de álgebra habrá pensado “¿Elemento neutro y asociativa? ¿No era esto lo que definía un monoide? ¿Tiene que ver con el nombre de mónada?”. La respuesta es sí. Un monoide es lo que se forma con “int->int” donde el tipo de entrada es igual al tipo de salida. Una mónada es la generalización donde los tipos no son siempre iguales.

De los lugares en los que habitan las mónadas

La parquedad de los requisitos de las mónadas hace que aparezcan por todos los lados y no únicamente como modelo de efectos secundarios. Son en general un modelo de computación (ver ejemplo 1.1 en el articulo original de Moggi para una lista de cosas que puede modelar una mónada).

Por ejemplo, los punteros con NULL se usan generalmente como mónadas. El constructor de tipo está claro que es el de los punteros. De “int” pasamos a “int*”. La función “unit” es simplemente obtener la dirección de un entero.

int a;
int* p=&a; // p=unit(a)

La función “bind” consiste en comprobar que el puntero no es NULL.

return p==NULL ? NULL : p->OperaYDevuelvePuntero() ;
// return bind(p, OperaYDevuelvePuntero);

Es fácil comprobar las propiedades correspondientes con estas operaciones, pero aún hay más. Cualquier colección iterable es una mónada. Sí, así a lo bestia: vectores, conjuntos, listas, mapas, tablas hash, etc. Todos son mónadas. El constructor de tipo es el de la colección que queramos. Por ejemplo, “vector<int>”.

La función “unit” es bien sencilla: la colección con un único elemento.

vector<int> v;
v.push_back(3);
// v=unit(3)

La función “bind” es equivalente a iterar y mezclar.

vector<int> r;
foreach (x in v) r.append(Procesa(x));
// r=bind(v, Procesa)

Ojo que “Procesa” devuelve un vector y “append” mezcla vectores. Si “Procesa” fuera obtener la lista de divisores, entonces

bind([1, 6, 21], Procesa) = [1, 1, 2, 3, 6, 1, 3, 7, 21]

Esta propiedad del “bind” de separar, iterar y combinar es la que le da tanta utilidad. De hecho, debido a esto, “Procesa” también serviría para filtrar, transformar, unir y casi cualquier otra operación que se quiera realizar con la colección. Lo que no quita para que también la colección tenga sus operaciones propias no monádicas.


Pero con todo esto habría ya material para otra entrega en la que tendríamos que hablar de comprensiones monádicas, la notación “do” y empezar a usar muchas funciones anónimas.

miércoles, 8 de diciembre de 2010

C++: Conceptos y traits

Toda esta entrada es una especie de resumen personal de la presentación de Bartosz Milewski que podéis ver aquí más algunas ideas extra de mi propia cosecha.

Conceptos mediante traits

Antes de nada hay que entender que los template en C++ no pueden compilarse inmediatamente porque no sabemos los tipos que vamos a tener cuando instanciemos el template.

El problema podría ser resuelto si forzamos a que estos tipos cumplan un contrato, una interfaz. La idea es hacerlo mediante los llamados conceptos. Por ejemplo, un tipo sobre el que podamos comprobar la igualdad, tendría un concepto parecido a este:

concept Eq<T>
{
 bool operator==(T const& l, T const& r);
}

Ahora podríamos agregar tipos que cumplen ese concepto mediante lo que se denomina una asignación de concepto (concept_map).

concept_map Eq<int>
{
 bool operator==(int const& l, int const& r) { return l==r; }
}

Hay que notar que el == de los enteros no es inmediatamente Eq ya que el concepto Eq podría significar algo más que "tiene igual". Podría significar "tiene igual y es reflexivo, simétrico y transitivo" por lo que sólo el programador sabe si puede o no hacer un concept_map en función de la semántica del concepto.

La idea es que ahora, en un template, se pueda usar el igual del concepto en vez del igual de la clausura dinámica.

template<Eq T>
T f(T const& a, T const& b)
{
 return a==b ? a : b;
}

El == este sería el del concepto Eq y no una función que haya que esperar a tener el tipo T para encontrarla en tiempo de instanciación. Por tanto, este template se podría comprobar estáticamente en declaración. Sin saber si T es un int u otra cosa.

La manera de implementar algo parecido en el C++ actual (aunque sin la ventaja de la comprobación en declaración) es mediante el uso de traits. En vez de tener Eq como un concepto (ya que el C++ actual carece de ellos) lo tendremos como una clase Eq<T> que significa "el tipo T es del concepto Eq". Para que el tipo T sea del concepto Eq deberá demostrarse que el operador == es parte de ese tipo.

template<typename T>
class Eq
{
public:
static bool operator==(T const& l, T const& r);
};

El concept_map no es más que una especialización demostrando que int se ajusta a lo requerido. El compilador de C++ actual no lo comprueba así que hemos de ser cuidadosos.

template<>
class Eq<int>
{
public:
static bool operator==(int const& l, int const& r) { return l==r; }
};

Finalemente, cuando usemos estos sucedáneos de conceptos, hay que usar la clase trait en vez de utilizar directamente el operador ==. En el caso de los conceptos puros el uso del == del concepto era implícito.

template<typename T>
void f(T a, T b)
{
return Eq<T>::operator ==(a, b) ? a : b;
}


Lo importante aquí es que es posible mediante esta técnica el separar la comprobación del template de su instanciación. Desafortunadamente, este conocimiento ha llegado a la comunidad de C++ unos veinte años después de que se estandarizaran los templates (como ya he comentado en una entrada anterior, incorrectamente). Aunque usemos Eq<T>::operator ==(a, b), el compilador tomará esta expresión como dependiente y no la comprobará estáticamente.

Extensión hipotética de C++

Esto no quiere decir que no se puedan introducir. Sólo quiere decir que hay que tener muchísimo más cuidado en cómo se hace puesto que interacciona con otras características del C++ de maneras indeseadas lo cual llevó a retirar los conceptos del estándar actual.

Una manera posible de introducirlo, pienso, sería subsanando las dos carencias que hemos comentado arriba.
  1. Comprobar que las especializaciones implementan el template general. 
  2. Evitar que se tomen como expresiones dependientes las que usen estos templates comprobados. 

Postulemos entonces una pequeña variación en C++ introduciendo unos templates cuyas especializaciones tengan que implementar su interfaz forzosamente. Usaremos la hipotética sintaxis abstract template.


abstract template<typename T>
class Eq
{
public:
static bool operator==(T const& l, T const& r);
};

Con esta hipotética sintaxis el compilador se quejaría de especializaciones como estas:

//ERROR: Eq<T> es abstract y su especialización Eq<int> no implementa ==
template<> class Eq<int>
{
public:
 static bool operator<(int const& l, int const& r) { return l<r; }
};

//ERROR: El segundo argumento de operator == no es de tipo adecuado.
template<> class Eq<int>
{
public:
 static bool operator==(int const& l, float const& r) { return l<r; }
};

Como el compilador sólo va a permitir las especializaciones que cumplan con el abstract template, tiene suficiente información para comprobar las expresiones que usen este abstract template, hayan sido especializadas o no. Por esta razón no es necesario que el uso de los abstract template sean dependientes.


template<typename T>
void f(T a, T b)
{
return Eq<T>::operator ==(a, b) ? a : b;
}


La expresión Eq<T>::operator ==(a, b), aunque depende de T, como lo hace a través de un abstract template, no es dependiente y se puede comprobar ahora. De hecho, se comprueba que operator== es miembro de Eq y tiene el tipo adecuado, por tanto, la función template f() es correcta. ¡Y lo sabemos antes de instanciar T!

Estas modificaciones que propongo son en principio seguras ya que si no introduces ningún abstract template todo sigue siendo compatible. No rompe ningún código. Son fáciles de realizar puesto que es añadir una pequeña regla en la definición de expresión dependiente y la comprobación de que se implementa una interfaz es bastante parecida a la de las funciones virtuales puras (aunque hay detalles y en los detalles está el diablo).

Otra cosa es que no cumpla todos los objetivos que se esperaban de los conceptos como su uso implícito. Vayamos por partes. Esto es un primer paso, veremos como solucionar el siguiente en otro momento.

Nota: Podríamos recurrir a la vinculación dinámica en vez de a un trait y tener

template<typename T>
class Eq
{
public:
 bool (*operator==)(T const& l, T const& r); //Sin static
};

Que se usaría así

template<typename T>
void f(Eq<T>& demo, T a, T b)
{
return demo.operator ==(a, b) ? a : b;
}

Ahora bien, ¿para qué retardar la decisión a tiempo de ejecución? Muy sencillo. Este cambio permite compilar el template y generar código. Esto es lo que se llama compilación separada y aceleraría los tiempos de compilación. Como siempre, hay un compromiso entre perder algo de tiempo de ejecución o perder algo de tiempo de compilación.

miércoles, 1 de diciembre de 2010

Expresiones dependientes en templates de C++

El código

Existe un aspecto poco conocido a la hora de usar los templates de C++ que son las expresiones dependientes. Éstas dan un susto de vez en cuando a quienes las usan ya que son una mala implementación de las clausuras estáticas. El código ofensivo es el siguiente.

void f() { std::cout<<"A"; }

template<typename T>
struct B {
 void f() { std::cout<<"B"; }
};

template<typename T>
struct D : public B<T> {
 void g()
 {
  f();  //¿Imprime "A" o "B"?
 }
};

int main()
{
 D<char>::g();
}

Si llamamos a D<t>::g(), ¿se imprime "A" o se imprime "B"? Si se imprimiera "A" significa que se está usando el entorno global y si se imprime "B" significa que se está usando el entorno de la estructura D (que hereda de B). Esto está relacionado con la pregunta, ¿cuándo se compila/comprueba D? D se compila/comprueba parte cuando se declara (en el código de arriba donde pone template<typename T> struct D hasta la llave de cierre }; ) y parte cuando se instancia (cuando se hace T=char en D<char>::g() ).

Las clausuras 

Teniendo en cuenta que main() está en el entorno global y la estructura D es el entorno local de la definición de g(), el problema aquí es distinguir entre la clausura dinámica o la clausura estática. La clausura dinámica significa que si no encontramos la definición de un nombre en una declaración, buscamos en el contexto donde se está usando esa declaración (en D<char>::g()) . La clausura estática busca en el contexto donde se está declarando la declaración (en template...).

En los lenguajes basados en entorno, como el LISP o el Scheme, se usa la clausura estática, también llamada clausura léxica. Esto impide comprobar con facilidad si nuestra declaración es correcta porque no tenemos aún los tipos a los que vamos a instanciar (el char). Claro que esto no es problema ni en LISP ni en Scheme porque son lenguajes dinámicos.

La decisión 

La "solución" de los creadores de C++ fue separar la declaración del template en dos partes: la parte dependiente de los parámetros de tipos (los T) y la parte independiente de los mismos. La parte independiente puede comprobarse estáticamente, mientras que la parte dependiente se deja para cuando se conozca el argumento de tipo para la instanciación (el char).

El gran problema es que comprobar significa también buscar las declaraciones de los nombres y, en el caso de arriba, según f() sea del contexto estático o dinámico será la que imprime "A" o imprime "B".

Es fácil ver que la herencia de la clase D es B<T> y, efectivamente, depende de T por lo que no se va a buscar ningún nombre hasta el momento de instanciación ( D<char>::g() ). Antes de la instanciación está la declaración ( desde template<typename T> struct D hasta la llave de cierre }; ) y resulta que el f() que hay dentro de la declaración de g() no depende de T. Eso significa que se busca el nombre ahí, en declaración y el que encuentra es el que imprime "A" ya que el que imprime "B" depende de T a través de la herencia y no lo va a ver hasta la instanciación.

El resultado, contraintuitivo, es que imprime "A". Si tu compilador imprime "B", no se ajusta al estándar. Puedes ver más de esto en el FAQ del C++.

La historia se repite

Todo el lío fue la decisión, desde mi punto de vista errónea, de intentar comprobar el template en declaración, antes de tener los argumentos de tipos para instanciar. En el 90% de los casos al final no puedes comprobarlo en declaración porque casi todo va a depender de T, ¡que para algo se ha puesto! Así que la ganancia de separar las expresiones en dependientes e independientes es mínima y la pena es que se ha introducido la clausura dinámica por la puerta de atrás. La clausura dinámica es recordada amargamente por los programadores de LISP ya que hizo perder veinte años de investigación probando cosas como las FEXPR que al final tuvieron que ser descartadas.

In modern terminology, lexical scoping was wanted, and dynamic scoping was obtained (John McCarthy, History of Lisp)

Si se hubiera usado la clausura léxica, estos problemas no habrían surgido ya que se habría seguido la idea de sustitución (de hecho, esa fue la razón por la que se inventó la clausura léxica) y los costes habrían sido prácticamente los mismos que los que pagamos ahora.


El problema es que ahora estamos atados. De eso hablaré en otra entrada.

viernes, 25 de junio de 2010

Constantes y constantes

Hay un sutil hecho en los lenguajes de programación compilados que, aunque de sobra conocido en el mundo de la creación de compiladores, no lo es tanto por los programadores en general. Es la diferenciación entre constantes estáticas y constantes dinámicas.

Constantes estáticas

Imaginemos que en nuestro lenguaje de programación tenemos definida una función a la que queremos llamar con el argumento 3. Esto podría codificarse de la siguiente forma:

f(3)

El resultado de la compilación de la línea anterior es un código ejecutable que realiza dos acciones:

  • Introducir el valor 3 en los argumentos de llamada
  • Llamar al código de la función cuyo nombre es "f"
  • Tomar el resultado de la llamada como resultado del programa

Es muy sencillo introducir ahora una constante que tenga el valor 3 y llamar a la misma función con esta constante.

const A = 3
f(A)

El resultado de la compilación de este nuevo programa no es más que el mismo código. El compilador, acertadamente, ha sustituido el símbolo "A" por el valor 3 antes de generar el código ejecutable (es lo que se llama propagación de constantes). Esto significa que el programa anterior es completamente equivalente al inicial.

Como todas las transformaciones que hacemos ocurren a la hora de compilar (de hecho el código ejecutable resultante es idéntico en ambos casos) a este tipo de constantes se las llama constantes estáticas.

Plegado de constantes

Imaginemos que ahora queremos realizar la siguiente llamada a la misma función "f".

f(1+2)

El compilador tiene ahora dos opciones. La primera es la generación de código ejecutable directa. Este código ejecutable sería algo como:

  • Introduce el valor 1 en los argumentos de llamada (para la suma)
  • Introduce el valor 2 en los argumentos de llamada (para la suma)
  • Llamar al código de la función suma
  • Introducir el resultado de la llamada en los argumentos de una nueva llamada (para "f")
  • Llamar al código de la función cuyo nombre es "f"
  • Tomar el resultado de la llamada como resultado del programa

La segunda opción que puede tomar el compilador es esforzarse antes de generar el código en resolver las operaciones que se realicen sobre constantes. En este caso primero sumaría 1+2 y obtendría el valor 3 y, luego, generaría el código.

  • Introducir el valor 3 en los argumentos de llamada
  • Llamar al código de la función cuyo nombre es "f"
  • Tomar el resultado de la llamada como resultado del programa

A esta segunda opción se la llama plegado de constantes. El plegado de constantes no es más que ejecutar parte del código en el compilador en vez de en el programa. La razón de esto es muy sencilla. En el compilador se va a ejecutar una única vez mientras que en el programa se va a ejecutar muchas veces (al menos tantas como veces ejecutemos el programa).

De nuevo, como el plegado de constantes se efectúa durante la compilación, se dice que es una operación estática o en tiempo de compilación.

Evaluación de argumentos

Ejecutemos el siguiente código a continuación:

const A = 3
const B = A
f(B)

Nadie duda en este punto que el símbolo "B" estará asignado con el valor 3 ya que "A" se valuaba a 3. ¿Por qué no se asigna al símbolo "B" el valor "A" en vez del valor 3? Ciertamente, existen dos detalles importante:

  1. Lo que hay a la derecha (el argumento) del operador de asignación "=" se evalúa.
  2. Lo que hay a la izquierda (el símbolo) del operador de asignación "=" no se evalúa.

Aquí, cuando hablamos de evaluación, hablamos de evaluación en tiempo de compilación. Si nos fijamos bien, si hacemos f(1+2) también evaluamos el 1+2 antes de generar código. En general, se evalúan los argumentos de las funciones y no se evalúan los argumentos de las macros. De esto ya hablé anteriormente.

Otra vez, estamos hablando de transformaciones estáticas durante el tiempo de compilación.

Reserva de memoria

La diferencia de una constante con una variable es clara. Las variables pueden cambiar de valor durante la ejecución pero este valor es desconocido durante la compilación. Esto significa que hay que guardar una reserva de memoria durante la ejecución para almacenar el valor de la variable.

var A = lee_de_teclado()

El programa anterior generaría un código ejecutable como el que sigue:

  • Llama al código de la función cuyo nombre es "lee_de_teclado"
  • Guarda el resultado en la reserva de memoria para la variable "A"

Lo importante aquí es que no conocemos el valor que va a tener "A" hasta que no ejecutemos el programa y escribamos algo en el teclado. Por tanto, no estamos hablando de operaciones estáticas sino dinámicas que requieren la ejecución del programa.

Sin embargo, ¿qué pasaría si sí conociésemos el valor que va a tener "A" aunque sea una variable?

Constantes dinámicas

La pregunta anterior aparecería en el caso de este pequeño programa:

var A = 3
f(A)

Si el compilador no hiciera nada antes de generar código, el código ejecutable resultante sería:

  • Guarda el valor 3 en la reserva de memoria de la variable "A"
  • Introducir el valor que hay en la reserva de memoria de "A" en los argumentos de llamada
  • Llamar al código de la función cuyo nombre es "f"
  • Tomar el resultado de la llamada como resultado del programa

Obviamente, podríamos reducir el programa a f(3) pero que "A" sea una variable significa que puede ser modificada en tiempo de ejecución. Concretamente es el caso que sigue.

var A = 3
f(A)
A = lee_de_teclado()

Y lo que es peor, la modificación de "A" podría no producirse en la misma hebra. Podría ser concurrente por lo que no sabríamos si entre "var A = 3" y "f(A)" se habría modificado el valor de "A".

La solución a esto es prohibir que "A", aunque sea variable, pueda ser modificada. En nuestro lenguaje podríamos escribirlo así:

var const A = 3
//No permitimos que A se modifique aquí
f(A)

De esta forma se evita el problema anterior y el compilador es libre de optimizar. Debido a que este tipo de constantes requieren reserva de memoria durante la ejecución se denominan constantes dinámicas.

Utilidad de las constantes dinámicas

Entonces, ¿para qué sirve una constante dinámica? Porque si es constante podemos sustituirla y el programa anterior sigue siendo equivalente a f(3). Bien. Existen dos utilidades importantes.

La primera es que las constantes dinámicas están en memoria y podemos obtener su dirección de memoria. Las constantes estáticas sólo están en compilación y se olvidan cuando se genera el código ejecutable.

El que estén en memoria no es trivial, ya que esto nos permite crear objetos en memoria con una estructura compleja. Ejemplo de esto son arreglos o listas. En este tipo de estructuras es fundamental saber las direcciones de memoria ya que se usan punteros en su implementación.

La segunda utilidad está completamente ligada a la característica dinámica. Es posible tener una constante dinámica, cuyo valor el compilador desconoce, pero que sabe que no va a poder ser modificada. El código que sigue es un buen ejemplo de ello.

var const A = lee_de_teclado()
// Por seguro que nadie va a modificar A aquí
f(A)

Esta característica, también llamada inmutabilidad, es fundamental para la programación concurrente.

El origen de la confusión

La mayoría de los lenguajes de programación actuales no hacen una distinción entre estos dos tipos de constantes en el ámbito del compilador (no así en el del preprocesador).

Por ejemplo, en C++, las constantes son dinámicas casi siempre.

static const int A=3;
memset((void*)&A, 0, sizeof(A)); //OK. A es una constante dinámica.

Sin embargo, se pliegan.

sin(A+A); //Genera el mismo código que sin(6).

Existen mecanismos poco intuitivos y claros para forzar el uso de constantes estáticas.

enum {A=3};
memset((void*)&A, 0, sizeof(A)); //ERROR. A es una constante estática.

Por esta razón algunos opinan que haber elegido "const" como palabra clave fue un error y debería haberse usado "immutable". Java no soluciona el problema y usa variables "static final". En cambio, en C# (por fin) hay distinción entre "const" y "readonly".


jueves, 1 de abril de 2010

Polimorfismo de rango superior

Abstracción de tipos

Cuando escribimos una abstracción lambda, la idea subyacente es que quién elige el argumento es el llamador y quién elige el retorno es el llamado. En

[$$ (\lambda x:Int.x)3 $$]

el llamador elige que sea 3 el argumento y el llamado elige que sea x(=3) el resultado. Eso sí, el tipo está fijado a

[$$ Int \rightarrow Int $$]

Llamamos "flecha" a la flecha que indica que el tipo es una función de enteros en enteros. Esto es realmente un constructor de tipos.

Cuando usamos un tipo polimórfico el llamador también elige el tipo al que quiere instanciar un término. Para eso usamos una abstracción de tipos (lambda mayúscula). En la versión polimórfica de la función identidad sería:

[$$ (\Lambda T.\lambda x:T.x)Int\ 3 $$]

El llamador debe decidir qué tipo usar (el Int) y qué valor aplicar (el 3). Para expresar que una abstracción requiere un tipo (que puede ser cualquiera), le asignamos un tipo para todo. Así que el tipo de las abstracciones anteriores sería

[$$ \forall X.X \rightarrow X
$$]

Formas canónicas

Es interesante comprobar el hecho inverso. Cuando tenemos un valor cuyo tipo es

[$$ T \rightarrow S $$]

este valor debe ser una abstracción lambda como

[$$ s=\lambda x:T.r $$]

En la anotación del tipo (detrás de la x) tenemos lo que hay a la izquierda de la flecha del tipo. Es decir, el tipo T en la expresión de arriba.

Además, la forma de usarlo es aplicando un valor del propio tipo T. Algo como

[$$ s\ t $$]

donde t tiene tipo T.

Por otra parte, si tenemos un valor cuyo tipo es

[$$ \forall X.T $$]

este valor debe ser una abstracción de tipos como

[$$ s=\Lambda X.t $$]

Y el uso de s sería aplicándole un tipo. Por ejemplo, el tipo R.

[$$ s\ R $$]

Estas son las llamadas formas canónicas y la manera que tenemos de usarlas.

Rango uno

Ahora veamos qué forma puede tener una expresión de tipo

[$$ \forall X. \forall Y. X \rightarrow Y \rightarrow X $$]

Para empezar empieza por un para todo así que debe ser

[$$ \Lambda X.t $$]

Ese término t también empieza por para todo (el de la Y) así que tendríamos

[$$ \Lambda X. \Lambda Y.s $$]

Y el término s una función de dos argumentos que debe tener por tanto dos abstracciones lambda. Para no complicar el término, haremos que el cuerpo final retorne la propia x.

[$$ \Lambda X. \Lambda Y.\lambda x:X. \lambda y:Y. x $$]

Lo interesante de esta expresión es que, al usarla, es el llamador quién elige todos los tipos y argumentos. Podría ser algo como

[$$ (\Lambda X. \Lambda Y.\lambda x:X. \lambda y:Y. x)Int\ String\ 3\ ''hola'' $$]

Siempre que ocurra esto, nuestra expresión será de rango uno. Esto es muy importante porque no hay dependencias de ningún tipo. Dados los argumentos que apliquemos (sean tipos o valores) sabremos, directamente, cómo se van a usar dentro del cuerpo de la función (basta sustituir).

Si modificamos el tipo que hemos usado bajando un para todo a la derecha de una flecha, sólo intercambiamos el orden de los argumentos. Siguen dependiendo todos del llamador.

[$$ \forall X. X \rightarrow \forall Y. (Y \rightarrow X) $$]
[$$ \Lambda X. \lambda x:X. \Lambda Y. \lambda y:Y. x $$]

Seguimos en rango uno.

Rango superior

Ahora vamos a ver qué ocurre cuando ponemos el para todo a la izquierda de una flecha.

[$$ (\forall X.X \rightarrow X)\rightarrow Int $$]

Vemos que lo más exterior es una flecha. Es decir, la forma canónica empezará por lambda minúscula con una anotación de tipo igual a lo que haya a la izquierda de la flecha.

[$$ \lambda x:(\forall X.X \rightarrow X).t $$]

Esto significa que es el llamado el que debe pasarle el tipo a la x dentro de la t. Podría ser algo como

[$$ \lambda x:(\forall X.X \rightarrow X).(x\ Int\ 3) $$]

Entonces, no basta con sustituir, también hemos de calcular con lo que hay dentro del cuerpo de la aplicación. Hemos aumentado en un grado la complejidad con la que tiene que trabajar el sistema de tipos por el mero hecho de escribir un para todo a la izquierda de una flecha.

Si la aparición de este para todo está anidado a la izquierda de las flechas menos de N veces, decimos que el tipo es de rango N. En nuestro caso, como está sólo una vez, es de rango dos.

Es decidible el inferir tipos en rango uno y dos, pero en rango tres y superiores no es decidible. Esa es la razón por la que muchos lenguajes hacen únicamente inferencia de rango dos o, incluso, uno; donde todos los para todos están por fuera de cualquier flecha.

jueves, 11 de marzo de 2010

Polimorfismo paramétrico

El polimorfismo paramétrico aparece de forma natural en la programación. El caso más simple es la función identidad.

[$$ \lambda x.x $$]

¿Cuál es el tipo de esta función? Realmente, depende de lo que sea el tipo de su argumento. Si es un real, la función será Real->Real. Si es un natural, será Natural->Natural. Si es una cadena Cadena->Cadena.

Esto se puede agrupar con la idea de los tipos universales: Para todo tipo X el resultado es X->X. Lo que se escribe así.

[$$ \forall X.X\rightarrow X $$]

Obviamente, según el tipo que deseemos usar, especializamos. Así de 

[$$ \forall X.X\rightarrow X $$]

pasamos a

[$$ Real \rightarrow Real $$]

Cuando especializamos X a un real. Pero, ¿podemos especializar X a lo que queramos? ¿Incluso al propio tipo universal? La respuesta es que sí. Es un caso de impredicación en el cual cuantificamos la propia sentencia en la que está el cuantificador. Es decir, que podríamos pasar a especializar

[$$ \forall X.X\rightarrow X $$]
[$$ (\forall X.X\rightarrow X)\rightarrow (\forall X.X\rightarrow X) $$]
[$$ (((\forall X.X\rightarrow X)\rightarrow (\forall X.X\rightarrow X))\rightarrow

((\forall X.X\rightarrow X)\rightarrow (\forall X.X\rightarrow X)))\rightarrow
(((\forall X.X\rightarrow X)\rightarrow (\forall X.X\rightarrow X))\rightarrow
((\forall X.X\rightarrow X)\rightarrow (\forall X.X\rightarrow X))) $$]

Y así, infinitamente.

Las estructuras infinitas no son malas de por sí. A menos que quieras recorrerlas enteras. En ese caso vas a tardar un tiempo infinito. Esto es la indecibilidad. Una forma de evitarlo es dividir los tipos en dos. Los esquemas con los para todos y los tipos monomórficos sobre los que se predica.

Esta separación de los tipos en dos niveles es lo que hacen los sistemas de tipos al estilo ML o  de polimorfismo let. Aunque esa será historia para otro post.

lunes, 1 de marzo de 2010

Haciendo un intérprete de LISP (XX)

Esta es la última entrada sobre cómo hacer un intérprete LISP. Son las conclusiones.

Conclusiones

Empezamos describiendo los valores con los que íbamos a trabajar y dijimos que los guardaríamos en celdas. La idea de los valores elegidos era la homoiconicidad de forma que las propias expresiones del lenguaje fueran valores.

A continuación vimos cómo representar expresiones con celdas. También dijimos que la idea de la evaluación era convertir esas expresiones en otros valores.

Debido a que necesitábamos manipular las celdas empezamos a introducir operaciones sobre celdas.

Como también hacía falta inicializar y crear nuevas celdas, nos dedicamos a definir las operaciones correspondientes en el montículo.

Finalmente, en la quinta parte, nos dedicamos a definir la evaluación. La evaluación se apoyaba en la aplicación de las que teníamos dos variantes.

La primera era la predefinida. Estos eran los valores que llamábamos nativos y de los que dábamos la suma como ejemplo. También introdujimos el REPL como medio de comprobar que realmente la suma funcionaba.

La segunda forma de aplicación era usando una llamada compuesta. Es decir, definida por el usuario. Para eso teníamos las funciones lambda que guardábamos en objetos Lambda.

Para aplicar el objeto lambda realizábamos varios pasos: Creábamos un nuevo entorno local, vinculábamos los argumentos, comprobábamos la aridad y, finalmente, evaluábamos el cuerpo de la función lambda.

Hasta este punto habíamos hablado de entornos, pero no los habíamos definido. En la novena parte los definíamos.

Una vez que teníamos claro cómo usar los objetos lambda, lo único que nos faltaba era crearlos. Para eso introducíamos una nueva nativa.

Aunque mencionamos el REPL anteriormente, no lo habíamos especificado. En la undécima parte lo hacíamos.

En nuestra definición de celdas y entornos habíamos hablado repetidamente de los nombres. En la duodécima parte explicamos cómo usarlos y modificar su contenido. Además, introducimos la nativa que nos saca del REPL y otra que detiene la evaluación.

Cuando todo parecía terminado con las funciones lambda, nos damos cuenta que hace falta un pequeño detalle en nuestra implementación de los entornos. Debemos tener la capacidad de modificar nuestros entornos padre para poder realizar la clausura léxica correctamente.

La décimo cuarta parte es una colección de funciones nativas que posiblemente sean interesantes tener: operaciones con listas, formas especiales, formas especiales con booleanos y operaciones de inspección del estado del intérprete.

En la décimo quinta parte damos por concluida la realización del intérprete añadiendo las rutinas de lectura de expresiones y escritura de valores.

Las últimas cuatro partes (descontando ésta) las dedicamos a pensar en extensiones posibles.

Primero hablamos de mejoras básicas y casi siempre realizadas por un intérprete real: la recolección de basura y cache de celdas.

Luego, de otras extensiones menos básicas como las macros o carga de ficheros en tiempo de ejecución.

También exploramos la posibilidad de modificar la estructura del lenguaje. Vemos cómo podríamos llegar a Lua, Self o Smalltalk.

Finalmente, en vez de modificar el lenguaje, podríamos estandarizarlo. Hablábamos de los dos dialectos principales del lisp: Common Lisp y Scheme.

sábado, 27 de febrero de 2010

Haciendo un intérprete de LISP (XIX)

En esta penúltima entrada sobre el intérprete LISP voy a hablar sobre los distintos caminos que siguen a partir de nuestro intérprete.

El primer camino (y más usual) es usar el LISP como un lenguaje dedicado. Al ser tan simple hacer un intérprete LISP, se usa en muchísimos programas. Por ejemplo, en AutoCad (el llamado AutoLISP), en Emacs o en Audacity (el Nyquist en honor a Nyquist).

El segundo camino, mucho menos usado, es convertir nuestro intérprete en un LISP estándar. Existen muchos dialectos estandarizados de LISP, pero hay dos que predominan. El Common Lisp y el Scheme.

El Common Lisp

El Common Lisp es el abuelo de los LISP. Recopila añadidos y añadidos desde 1984 cuando se creó. No es un dialecto que busque innovar la estructura del LISP. Simplemente va introduciendo nuevas y nuevas características.

Cada característica, cada nuevo uso que se le quería dar hacía que se introdujeran nuevos tipos de datos, nuevas construcciones y nuevas semánticas. El resultado es que el estándar de Common Lisp es bastante voluminoso (1153 páginas).

Una de estas características es el CLOS que permite usar la programación orientada a objetos en el LISP, además de los paradigmas usuales de programación procedural y funcional usuales del LISP.

El Scheme

Si Common Lisp es la navaja suiza de los LISP, con una característica apropiada para cada momento, Scheme intenta ser un cuchillo muy afilado que sirva para todo. Esta filosofía llevó a los desarrolladores de Scheme a modificar la estructura del LISP.

Esta estructura se cambió en varios sentidos.

  1. Una gran simplificación. Por ejemplo, se usa el mismo nombre de espacios para funciones y variables. Tiene menos tipos de datos, etc.
  2. La introducción de continuaciones para el control de flujo y el requerimiento de la optimización de llamadas de cola.
  3. La introducción de un nuevo sistema de macros sintácticas.
  4. La introducción de clausuras y vinculado léxico, en vez de dinámico.

Muchas de estas decisiones han resultado ser muy interesantes. Tanto que se "filtraron" al Common Lisp. Por ejemplo, las clausuras léxicas.

El resultado de esto es que el Scheme es un lenguaje muy fácilmente implementable. Además, como el intérprete es muy pequeño, se puede usar incluso en entornos incrustados.

Como era de esperar, el estándar de Scheme son unas pocas páginas. 

lunes, 22 de febrero de 2010

Haciendo un intérprete de LISP (XVIII)

En esta parte de la realización de un intérprete LISP vamos a ver cómo convertirlo en un intérprete de otros lenguajes. Si no de forma completa, sí de manera básica, dando unas pinceladas.

A Lua

El lenguaje Lua es realmente diferente al LISP. La página principal del lenguaje está aquí y existe una interesante entrada en la Wikipedia. A poco que investiguemos el lenguaje nos encontramos con que el tipo de dato fundamental en Lua no es la lista, si no la tabla.

Realmente en LISP ya hemos usado tablas para los entornos. ¿Podremos quitar las listas? La respuesta es sí y muy fácilmente. Basta con realizar las siguientes operaciones:

  1. Permitir que los entornos usen como clave cualquier valor y no únicamente cadenas. A partir de ahora son tablas.
  2. Representar las expresiones mediante tablas. Para esto se puede ver el MetaLua.
  3. Modificar las reglas de evaluación para usar tablas. Ver por ejemplo las metatablas del Lua.

Una lista será ahora una tabla con claves 0, 1, 2, 3... Con este truco, las celdas de tipo CT_PAIR desaparecen de nuestro intérprete. A cambio, abundarán las celdas de tipo CT_TABLE (antiguas celdas de entornos).

Nota: Hay una pequeña diferencia entre un entorno y una tabla. Un entorno puede tener un entorno padre donde se busque una clave no encontrada en él mismo. Generalmente una tabla no tiene estas tablas padre. Nuestras tablas sí las tendrán, ya que las tenemos que usar como entornos también.

Las celdas de tabla mantienen la información en un objeto aparte. Generalmente este objeto será una tabla hash. Las tablas hash son una estructura de datos que no es trivial. Cambian de tamaño, el acceso no es inmediato, hay que mantener la cuenta del factor de carga, etc. Por esta razón habría que implementar una serie de trucos para hacer todo más eficiente. Por ejemplo, el Lua tiene una tabla separada para cuando las claves son números naturales y otra para el resto de accesos.

A Self

Una vez que empezamos a usar tablas surge de forma natural la técnica de guardar en ellas las operaciones que se pueden realizar sobre ellas mismas. De hecho, Lua tiene dos operadores para acceder a tablas. El primero es el punto "." que obtiene el valor bajo una de las claves de la tabla. Por ejemplo, "a.b(c)" busca el valor "b" dentro de la tabla "a" y le aplica los argumentos "(c)".

El otro operador se escribe con dos puntos ":" y es azúcar sintáctico ya que se puede traducir "a:b(c)" por "a.b(a, c)". Es decir, que reutiliza la tabla como primer argumento. Puede verse aquí. Esto significa que usamos la tabla "a" no sólo para buscar la operación "b", sino que también vamos a usar esta tabla como argumento de la operación.

Si siempre nos decantamos por esta segunda opción, pasando la tabla como un argumento implícito (generalmente llamado "self"), lo que tenemos es un lenguaje orientado a objetos puro. En este tipo de lenguajes escribir "a.b(c)" significa "enviar al objeto "a" el mensaje "b" con argumentos (c)". Realmente es igual a lo que escribíamos en Lua "a:b(c)". Esta es la esencia del lenguaje Self.

Para distinguir las tablas a secas de los objetos, en Self se denominan "slots" a las claves de las tablas. Además, existen diversos tipos de slots, aunque no entraremos a discutirlos aquí.

Lo realmente interesante es que Self permite herencia por prototipos. Esto significa que si buscamos una clave en una tabla/objeto y no lo encontramos, hemos de buscar en el objeto prototipo. ¡Pero esto es exactamente lo mismo que buscar en el entorno padre en el caso de los entornos! La única pequeña diferencia de mención es que Self puede tener varios objetos/tablas/entornos padre, ya que permite herencia múltiple.

Otro lenguaje que sigue este esquema de objetos y prototipos es JavaScript.

A Smalltalk

Una vez que empezamos a cambiar lo que ocurre cuando no encontramos una clave/"slot" en un objeto nos lleva a pensar en la siguiente simplificación: ¿para qué buscar en un objeto y, si no está, vamos a otro? ¡Directamente buscamos en el otro! Esta es la idea del uso de clases.

Una clase es un objeto que nos dice qué "slots" tiene otro objeto. Se consideran entonces a las clases como "patrones" de los objetos relacionados con ella. Este sistema tiene una gran ventaja: no se repite información. Sin embargo, esta mejora se consigue a cambio de aumentar la complejidad.

Smalltalk es un lenguaje que hace esta distinción entre objeto y clase. Además, es un lenguaje con muchas sorpresas tanto sintácticas como semánticas. Pero este artículo se está haciendo demasiado largo y le dejo al lector el gozo de investigarlas.


jueves, 4 de febrero de 2010

Haciendo un intérprete de LISP (XVII)

El LISP es un lenguaje homoicónico. Es decir, las expresiones son valores en sí. Esto permite trabajar con el código como si fuera dato. Por esa razón he puesto el tag "programación genérica" en todos las entradas del intérprete lisp. En esta entrada vamos a ver qué podemos hacer gracias a esta propiedad.

Carga de ficheros

La carga de ficheros es bien simple. Lo cargamos como dato y, dado que los datos son también código, lo ejecutamos. Existen un gran inconveniente a esta forma de trabajar: Si queremos usar el código varias veces tendríamos que cargarlo y ejecutarlo varias veces. Esto es debido a que podríamos usar diferentes entornos de ejecución cada vez que carguemos el fichero. Al tener los símbolos distintos significados, cada ejecución tendría lugar a diferentes resultados.

Hay varias soluciones a esto.

  1. Admitirlo. Esto es lo que se ha llamado siempre incluir ficheros.
  2. Usar siempre el entorno global cuando se cargan ficheros.
  3. No permitir expresiones que usen nombres del entorno en el fichero a cargar.

En concreto, la tercera solución es muy atractiva. Encerrar el código en algún tipo de construcción de forma que los nombres se extraigan del entorno de uso, no del entorno de carga, nos lleva de forma natural al concepto de macro.

De las funciones a las macros

El gran problema del uso de datos como si fuera código es que perdemos el entorno. Si uso un nombre "x", dependiendo de donde lo use, significará una cosa u otra. Si sé que lo voy a usar inmediatamente está claro que se refiere al entorno actual, pero si voy a atrapar esa "x" en un trozo de dato que voy a usar luego... ¿qué valdrá esa "x" cuando se use? No lo sabemos.

Esta es una de las razones por las que Scheme usa las clausuras sintácticas a la hora de utilizar macros. De esta manera cuando convertimos código en dato también nos llevamos el entorno en los datos. Pero no seguiremos por ese camino. Miremos antes algo más simple. ¿Por qué no ocurren estos problemas con las funciones?

El código que se ejecuta en las funciones lo hace en tres posibles entornos. Esto ya está explicado aquí. Lo interesante de este modelo es que, use donde use cualquier nombre, éste ha de estar definido en el mismo trozo de código un poco más arriba. Tanto en la evaluación de sus argumentos como en la evaluación de la función.

Esto se observa en el siguiente diagrama.


En las funciones los entornos se evalúan donde se escriben, en el sitio de llamada (el entorno de uso). El cuerpo se evalúa donde se escribe también (en el entorno local). El resultado se usa tal cual.

En una macro lo que queremos es evaluar código en el entorno de uso. Tal como hacíamos en la inclusión. Es la parte de la derecha de la figura anterior. Como se observa, se evalúa el código generado en el entorno local fuera, en el entorno de uso. Además, se usan los argumentos sin evaluar. Esto lleva a todos los problemas conocidos de las macros (ver por ejemplo el libro de Paul Graham, On Lisp).

Realmente la evaluación de la macro se hace en un paso especial que se denomina macro expansión. Este paso es especial porque se tiene que ejecutar en tiempo de compilación mientras que la simple evaluación se compila. En nuestro caso, en el que tenemos un intérprete, esta diferencia es únicamente nominal.

Más allá de las macros

Viendo el diagrama, existen otras posibilidades de llamadas compuestas; aparte de las macros y las funciones. Además de las que evalúen algunos argumentos sí y otros no.

La mezcla de macro y función no es usual, pero las FEXPR sí que se ven de vez en cuando.

lunes, 1 de febrero de 2010

Haciendo un intérprete de LISP (XVI)

A partir de este punto consideramos el intérprete de LISP como completo en el sentido de que con él es posible evaluar interactivamente. Esto no significa que no podamos seguir añadiendo mejoras. A estas mejoras le dedicaremos los últimos cinco posts, aunque no añadiré ya código para implementarlas.

Cache de celdas y cadenas

Hasta ahora siempre que usábamos una celda de tipo CT_EMPTY, por ejemplo, siempre reservábamos memoria (via CreateEmpty() ). Es una tontería reservar varias veces la celda CT_EMPTY ya que no tiene estado y dos celdas de este tipo son idénticas.

La solución es bien sencilla. CreateEmpty() va a devolver siempre la misma celda. De esta forma ahorramos muchas celdas ya que todas las listas tienen un CT_EMPTY al final. La misma idea se puede usar para CT_BOOL cuando es true y cuando es false. Incluso, se podría usar para los números enteros más usados: el cero, el uno, el dos, etc.

Existe un impedimento para este tipo de técnica. Si queremos añadir a cada celda un localizador que nos diga en qué fichero fuente, en qué línea y en qué columna aparece esa celda; no tendremos más remedio que usar una celda distinta para cada aparición en el código.

En el caso de las cadenas es muy conveniente tener una única tabla de cadenas. De esta forma todas las celdas CT_STRING y CT_NAME no contienen la cadena en sí, sino una referencia a la tabla de cadenas. De esta manera aunque haya cien celdas CT_STRING con la misma cadena, sólo habrá una única copia de la cadena en nuestra tabla de cadenas.

Estas tablas asociativas se denominan comunmente cache.

Recolección de basura

Aún así tenemos el grandísimo problema de que celda que creemos es celda que perdemos. No podemos liberarla una vez no se use. Este problema ya surgió en los años 1960 cuando se creó el LISP. La solución consiste en usar una técnica llamada recolección de basura (garbage collection).

En su forma más simple es tal como se describe en el siguiente diagrama.

En primer lugar seleccionamos unas celdas las cuales sabemos que están siendo usadas. A estas celdas las llamamos el conjunto raíz. Un ejemplo de celda siempre usada es el entorno global. Estas celdas son las marcadas en (a).

En segundo lugar seguimos las referencias a otras celdas. Si una celda que sabemos usada referencia a otra celda, es posible llegar a usar esa celda referenciada y, por tanto, la consideramos usada también. Es lo que hacemos en (b). A este paso se le llama el marcado.

La idea es que las celdas no marcadas no van a poder ser usadas en el futuro porque no existe una referencia a ellas. Estas son las celdas blancas en (c). En este momento es cuando se liberan esas celdas no marcadas. A este paso se le denomina el barrido.

No es difícil averiguar por qué se denomina a este método de recolección de basura "marcado y barrido" (mark and sweep).

Existen muchísimos otros algoritmos de recolección de basura (conteo de referencias, marcado y barrido incremental, por generaciones, paralelo, etc.) No los veremos aquí.


miércoles, 27 de enero de 2010

Haciendo un intérprete de LISP (XV)

En esta entrega del intérprete LISP vamos a tratar la entrada/salida someramente. Nos dedicaremos a ver únicamente la rutina de lectura de expresiones y la de escritura de valores.

La rutina de lectura

Tampoco vamos a adentrarnos mucho en la rutina de lectura. De hecho, se puede usar una PEG fácilmente para las expresiones S. Tomado, y simplificado, de aquí.

Atom = {Char}+ 
<s-expression> ::= <quote>? Atom / <quote>? '('  <s-expression>* ')' 
<quote> ::= [']

Realmente lo interesante aquí es que los literales y los identificadores se pueden agrupar como átomos en la gramática y, luego, distinguirlos en la parte semántica.

La rutina de escritura

A diferencia de la rutina de lectura, la escritura debe servir para cualquier valor. Por ejemplo, una función lambda. Además, hemos de intentar formatear algo la salida para que la lectura sea agradable. Es lo que se denomina el prettyprinting.

No vamos a calentarnos mucho la cabeza. Usaremos una indentación para destacar el grado de anidamiento que tengan los valores. Todo eso se puede incluir en una misma rutina de la siguiente forma:

void Cell::Print(std::wostream& o, std::wstring const& indent, int depth)const
{
if(this==NULL)
throw std::logic_error("Null cell");

switch(cell_type)
{
case CT_UNUSED:
o << L"[unused]";
break;

case CT_EMPTY:
o << L"()";
break;

case CT_PAIR:
if(IsList())
{
if(depth>0)
{
o << L"(";
Cell const* c=this;
c->value.head->Print(o, indent+L" ", depth-1);
c=c->value.tail;
while(c->IsPair())
{
o << L"\n " << indent;
c->value.head->Print(o, indent+L" ", depth-1);
c=c->value.tail;
}
o << L")";
}
else
o << L"[list]";
}
else
{
if(depth>0)
{
o << L"[\n";
value.head->Print(o, indent+L" ");
o << L"\n";
value.tail->Print(o, indent+L" ");
o << L"]";
}
else
o << L"[pair]";
}
break;

case CT_INTEGER:
o << value.integer;
break;

case CT_REAL:
o << value.real;
break;

case CT_STRING:
o << L"\"" << *value.string_idx << L"\"";
break;

case CT_BOOLEAN:
o << (value.boolean? L"[true]" : L"[false]");
break;

case CT_NAME:
o << *value.string_idx;
break;

case CT_ENVIR:
o << L"[envir " << (void*)this;
if(depth>0)
{
o << L"\n";
value.environment->Print(o, indent+L" ", depth-1);
}
o << L"]";
break;

case CT_LAMBDA:
if(depth>0)
{
o << L"[lambda " << (void*)this << L" ";
value.lambda->Print(o, indent+L" ", depth-1);
o << L"]";
}
else
o << L"[lambda " << (void*)this << L"]";
break;

case CT_NATIVE:
o << L"[native " << (void*)this << L"]";
break;
}
}

En las celdas lambda y entorno delegamos al propio objeto, pero las rutinas de impresión son muy similares.

Con esto hemos acabado la parte inexcusable del LISP. A partir de aquí dedicaremos las siguientes entradas a extensiones y modificaciones. Empezaremos por la más necesaria: la recolección de basura, ya que hasta ahora creábamos celdas pero no las destruíamos.

domingo, 24 de enero de 2010

Haciendo un intérprete de LISP (XIV)

En esta parte de la serie sobre el intérprete LISP vamos a poner el código de algunas funciones nativas que pueden ser útiles.

Operaciones de lista

Tendríamos por ejemplo


Cell& FOL_Cons(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || args.GetTail().IsEmpty() || !args.GetTail().GetTail().IsEmpty())
throw std::runtime_error("Cons needs two arguments");

Cell& head=heap.Evaluate(args.GetHead(), envir);
Cell& tail=heap.Evaluate(args.GetTail().GetHead(), envir);

if(!tail.IsList())
throw std::runtime_error("Cons needs a list as second argument");

return heap.CreatePair(head, tail);
}

Cell& FOL_Car(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || !args.GetTail().IsEmpty())
throw std::runtime_error("Car requires one arguments");

Cell& head=heap.Evaluate(args.GetHead(), envir);
return head.GetHead();
}

Cell& FOL_Cdr(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || !args.GetTail().IsEmpty())
throw std::runtime_error("Cdr requires one arguments");

Cell& head=heap.Evaluate(args.GetHead(), envir);
return head.GetTail();
}

Cell& FOL_Second(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || !args.GetTail().IsEmpty())
throw std::runtime_error("Second requires one arguments");

Cell& head=heap.Evaluate(args.GetHead(), envir);
return head.GetTail().GetHead();
}

Cell& FOL_Third(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || !args.GetTail().IsEmpty())
throw std::runtime_error("Third requires one arguments");

Cell& head=heap.Evaluate(args.GetHead(), envir);
return head.GetTail().GetTail().GetHead();
}

Cell& FOL_Nth(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || args.GetTail().IsEmpty() || !args.GetTail().GetTail().IsEmpty())
throw std::runtime_error("Nth requires two arguments");

INTEGER at=heap.Evaluate(args.GetHead(), envir).GetInteger();
Cell& list=heap.Evaluate(args.GetTail().GetHead(), envir);
return list.ListIdx(at);
}

Cell& FOL_Length(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || !args.GetTail().IsEmpty())
throw std::runtime_error("Length requires one arguments");

Cell& list=heap.Evaluate(args.GetHead(), envir);
return heap.CreateInteger(list.ListLength());
}

Cell& FOL_List(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty())
return heap.CreateEmpty();

return heap.CreatePair( heap.Evaluate(args.GetHead(), envir)
, FOL_List(heap, args.GetTail(), envir) );
}

Cell& R_Append(Heap& heap, Cell& list1, Cell& list2)
{
if(list1.IsEmpty())
return list2;

return heap.CreatePair( list1.GetHead(), R_Append(heap, list1.GetTail(), list2) );
}

Cell& FOL_Append(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || args.GetTail().IsEmpty() || !args.GetTail().GetTail().IsEmpty())
throw std::runtime_error("Append requires two arguments");

Cell& list1=heap.Evaluate(args.GetHead(), envir);
Cell& list2=heap.Evaluate(args.GetTail().GetHead(), envir);

return R_Append(heap, list1, list2);
}

Cell& FOL_Reverse(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || !args.GetTail().IsEmpty())
throw std::runtime_error("Reverse requires one arguments");

Cell* r=&heap.CreateEmpty();
for(Cell* p=&heap.Evaluate(args.GetHead(), envir); p->IsPair(); p=&p->GetTail())
r=&heap.CreatePair( p->GetHead(), *r );

return *r;
}

Formas especiales

Algunas posibles son

Cell& FOL_Lambda(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || args.GetTail().IsEmpty())
throw std::runtime_error("Lambda needs two arguments at least");

Cell* params=&args.GetHead();
Cell* p;
for(p=params; p->IsPair(); p=&p->GetTail())
if(!p->GetHead().IsName())
throw std::runtime_error("Binding a non-name");

if(!p->IsEmpty())
throw std::runtime_error("Lambda needs a list as first argument");

return heap.CreateLambda(*new Lambda(*params, args.GetTail(), envir));
}


Cell& FOL_Defun(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || args.GetTail().IsEmpty())
throw std::runtime_error("Defun needs three arguments at least");

Cell& lambda=FOL_Lambda(heap, args.GetTail(), envir);
envir.GetEnvironment().Bind(heap, *args.GetHead().GetName(), lambda);
return lambda;
}

Cell& FOL_Quote(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || !args.GetTail().IsEmpty())
throw std::runtime_error("Quote needs one single argument");

return args.GetHead();
}


Cell& FOL_SetQ(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || args.GetTail().IsEmpty())
throw std::runtime_error("SetQ needs two arguments at least");

if(!args.GetHead().IsName())
throw std::runtime_error("SetQ requires a name as fist argument");

Cell& r=heap.EvaluateInSequence(args.GetTail(), envir);
envir.GetEnvironment().ChangeBond(heap, heap.GetStringFromPool(*args.GetHead().GetName()), r);
return r;
}

Cell& FOL_Define(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || args.GetTail().IsEmpty())
throw std::runtime_error("Define needs two arguments at least");

if(!args.GetHead().IsName())
throw std::runtime_error("Define requires a name as fist argument");

Cell& r=heap.EvaluateInSequence(args.GetTail(), envir);
envir.GetEnvironment().Bind(heap, *args.GetHead().GetName(), r);
return r;
}

Cell& FOL_Let(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || args.GetTail().IsEmpty())
throw std::runtime_error("Let needs two arguments at least");

Cell& envcell=heap.CreateEnvironment(&envir);
Environment& newenv=envcell.GetEnvironment();

//Bind to environment
for(Cell* qb=&args.GetHead(); qb->IsPair(); qb=&qb->GetTail())
{
Cell& binding=qb->GetHead();
if(binding.IsEmpty() || binding.GetTail().IsEmpty())
throw std::runtime_error("Bindings must have two elements at least");

newenv.Bind(heap, *binding.GetHead().GetName(), heap.EvaluateInSequence(binding.GetTail()
, envir)); // HERE!
}

//Evaluate in new environment
return heap.EvaluateInSequence(args.GetTail(), envcell);
}

Cell& FOL_LetInSeq(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || args.GetTail().IsEmpty())
throw std::runtime_error("Let* needs two arguments at least");

Cell& envcell=heap.CreateEnvironment(&envir);
Environment& newenv=envcell.GetEnvironment();

//Bind to environment
for(Cell* qb=&args.GetHead(); qb->IsPair(); qb=&qb->GetTail())
{
Cell& binding=qb->GetHead();
if(binding.IsEmpty() || binding.GetTail().IsEmpty())
throw std::runtime_error("Bindings must have two elements at least");

newenv.Bind(heap, *binding.GetHead().GetName(), heap.EvaluateInSequence(binding.GetTail()
, envcell)); // HERE!
}

//Evaluate in new environment
return heap.EvaluateInSequence(args.GetTail(), envcell);
}

Cell& FOL_Do(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || args.GetTail().IsEmpty() || args.GetTail().GetTail().IsEmpty())
throw std::runtime_error("Do needs three arguments at least");

Cell& envcell=heap.CreateEnvironment(&envir);
Environment& newenv=envcell.GetEnvironment();

//Initial bind to environment
for(Cell* qb=&args.GetHead(); qb->IsPair(); qb=&qb->GetTail())
{
Cell& binding=qb->GetHead();
if(binding.IsEmpty() || binding.GetTail().IsEmpty())
throw std::runtime_error("Bindings must have two elements at least");

newenv.Bind(heap, *binding.GetHead().GetName(), heap.Evaluate(binding.GetTail().GetHead()
, envir)); // HERE!
}

//Loop
Cell* r=NULL;
while(heap.Evaluate(args.GetTail().GetHead(), envcell).GetBoolean())
{
r=&heap.EvaluateInSequence(args.GetTail().GetTail(), envcell);

//Update
for(Cell* qb=&args.GetHead(); qb->IsPair(); qb=&qb->GetTail())
{
Cell& binding=qb->GetHead();
heap.EvaluateInSequence(binding.GetTail().GetTail(), envcell);
}
}

return r==NULL ? heap.CreateEmpty() : *r;
}

Cell& FOL_DoInSeq(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || args.GetTail().IsEmpty() || args.GetTail().GetTail().IsEmpty())
throw std::runtime_error("Do* needs three arguments at least");

Cell& envcell=heap.CreateEnvironment(&envir);
Environment& newenv=envcell.GetEnvironment();

//Initial bind to environment
for(Cell* qb=&args.GetHead(); qb->IsPair(); qb=&qb->GetTail())
{
Cell& binding=qb->GetHead();
if(binding.IsEmpty() || binding.GetTail().IsEmpty())
throw std::runtime_error("Bindings must have two elements at least");

newenv.Bind(heap, *binding.GetHead().GetName(), heap.Evaluate(binding.GetTail().GetHead()
, envcell)); // HERE!
}

//Loop
Cell* r=NULL;
while(heap.Evaluate(args.GetTail().GetHead(), envcell).GetBoolean())
{
r=&heap.EvaluateInSequence(args.GetTail().GetTail(), envcell);

//Update
for(Cell* qb=&args.GetHead(); qb->IsPair(); qb=&qb->GetTail())
{
Cell& binding=qb->GetHead();
heap.EvaluateInSequence(binding.GetTail().GetTail(), envcell);
}
}

return r==NULL ? heap.CreateEmpty() : *r;
}

Cell& FOL_DoList(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty())
throw std::runtime_error("DoList needs one arguments at least");

Cell& envcell=heap.CreateEnvironment(&envir);
Environment& newenv=envcell.GetEnvironment();

//Check the binding
Cell& binding=args.GetHead();
if(binding.IsEmpty() || binding.GetTail().IsEmpty())
throw std::runtime_error("Bindings must have two elements at least");

//Loop
Cell* r=NULL;
for(Cell* list= &heap.EvaluateInSequence(binding.GetTail(), envir); list->IsPair(); list=&list->GetTail())
{
newenv.Bind(heap, binding.GetHead().GetName(), list->GetHead());
r=&heap.EvaluateInSequence(args.GetTail(), envcell);
}

return r==NULL ? heap.CreateEmpty() : *r;
}

Operaciones y formas especiales con booleanos

Cell& FOL_Boolean_And(Heap& heap, Cell& args, Cell& envir)
{
for(Cell* qa=&args; qa->IsPair(); qa=&qa->GetTail())
if(!heap.Evaluate(qa->GetHead(), envir).GetBoolean())
return heap.CreateBoolean(false);

return heap.CreateBoolean(true);
}

Cell& FOL_Boolean_Or(Heap& heap, Cell& args, Cell& envir)
{
for(Cell* qa=&args; qa->IsPair(); qa=&qa->GetTail())
if(heap.Evaluate(qa->GetHead(), envir).GetBoolean())
return heap.CreateBoolean(true);

return heap.CreateBoolean(false);
}

Cell& FOL_Boolean_Not(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || !args.GetTail().IsEmpty())
throw std::runtime_error("Boolean not needs one single argument");

return heap.CreateBoolean(!heap.Evaluate(args.GetHead(), envir).GetBoolean());
}

Cell& FOL_Boolean_If(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty() || args.GetTail().IsEmpty() || args.ListLength()>3)
throw std::runtime_error("Lambda needs two or three arguments");

if(heap.Evaluate(args.GetHead(), envir).GetBoolean())
return heap.Evaluate(args.GetTail().GetHead(), envir);

return args.GetTail().GetTail().IsEmpty() ? heap.CreateEmpty()
: heap.Evaluate(args.GetTail().GetTail().GetHead(), envir);
}

Otras funciones

Cell& FOL_ProgN(Heap& heap, Cell& args, Cell& envir)
{
Cell* r=&args;
for(Cell* qa=&args; qa->IsPair(); qa=&qa->GetTail())
r=&heap.Evaluate(qa->GetHead(), envir);
return *r;
}

Cell& FOL_Prog1(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty())
return args;

Cell& r=heap.Evaluate(args.GetHead(), envir);
for(Cell* qa=&args.GetTail(); qa->IsPair(); qa=&qa->GetTail())
heap.Evaluate(qa->GetHead(), envir);

return r;
}

Cell& FOL_Eval(Heap& heap, Cell& args, Cell& envir)
{
if(args.IsEmpty())
throw std::runtime_error("The evaluator needs one argument at least");

return heap.Evaluate(heap.Evaluate(args.GetHead(), envir), envir);
}

Cell& FOL_Print(Heap& heap, Cell& args, Cell& envir)
{
if(heap.GetPrintOutput()!=NULL)
for(Cell* qa=&args; qa->IsPair(); qa=&qa->GetTail())
heap.Evaluate(qa->GetHead(), envir).Print(*heap.GetPrintOutput());

return heap.CreateEmpty();
}

Realmente podríamos seguir así creando bibliotecas y bibliotecas de funciones.