Mostrando entradas con la etiqueta interfaces. Mostrar todas las entradas
Mostrando entradas con la etiqueta interfaces. Mostrar todas las entradas
viernes, 4 de marzo de 2011
Estándar WebGL 1.0 publicado
Llevamos unos días con noticias sobre nuevos estándares que no paramos. Ayer, tres de marzo, salió otro estándar. Esta vez es WebGL, un contexto de renderización para el elemento CANVAS de HTML5. Cada vez los programadores de Javascript sobre la web tienen más y más recursos multimedia. ¿Será capaz el HTML5 de desbancar a otros sistemas como Flash o Silverlight como se proponía?

jueves, 20 de enero de 2011
¿Secuencial o Paralelo?
Este es un resumen de la charla de Guy Steele sobre paralelismo en Strange Loop.
Así que hay que hacer que el programador deje de pensar en acumuladores y pase a pensar en propiedades algebraicas. Es decir, usar catamorfismos en vez de bucles. Los catamorfismos no son más que funciones que toman una estructura de datos y devuelven un valor a partir de ella con la propiedad de que son morfismos. En el caso de sumar una lista de números sería algo así como convertir la concatenación en suma.
[$$ f( [ 3, 5 ] .. [4, 7] ) = f( [3,5] ) + f( [4, 7] ) $$]
Esto significa a su vez que hay que buscar una operación con las propiedades algebraicas que deseemos (o podamos obtener), lo cual puede llevar a comprender más profundamente el problema.
La especificación del catamorfismo es similar al uso de sumatorios en matemáticas. No se especifica el orden de la suma, sólo que hay que sumar los elementos.
[$$ \sum_{i=1}^{n} {x_i} $$]
En programación esto se tendría que hacer usando funciones de alto nivel como fold pero asumiendo la asociatividad.
Así el compilador podría optimizar usando paralelismo sin que el programador tuviera que luchar con sincronizaciones y demás.
| SECUENCIAL | PARALELO |
| Se ejecuta un código A, luego se usa el resultado de A en otro código B. | Se ejecutan los códigos A y B independientemente. Luego se mezclan los resultados. |
| Reusa el espacio. Sólo hay que almacenar un resultado. | Usa espacio extra para desacoplar los cálculos. |
| Procesa una cosa cada vez y va acumulando resultados. | Descompone y mezcla resultados. Divide y vencerás. |
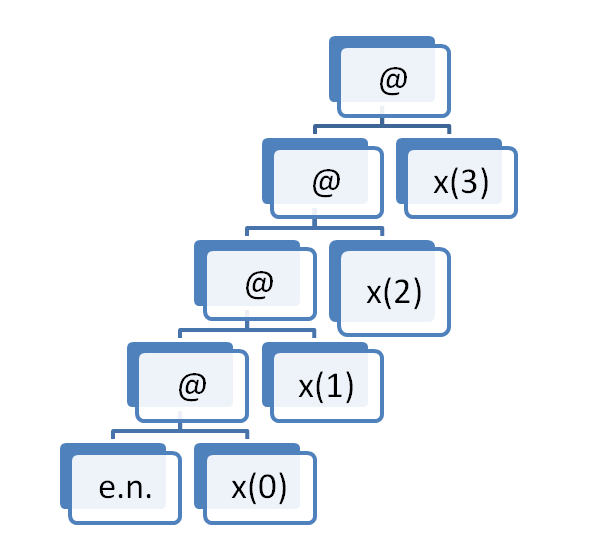
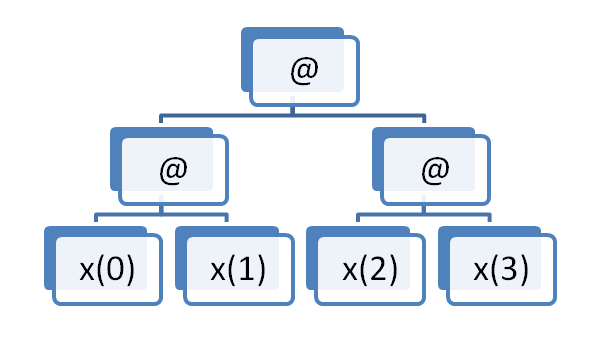
Requiere iniciar el acumulador con el elemento neutro de la operación.acc=elem_neutro; for(i=0; i<n; ++i) acc=acc @ x[i] | Requiere asociatividad en la operación para ir mezclando resultados. No se puede procesar en paralelo: [$$ x_0 \star (x_1 \star (... )) $$] |
 |  |
Se basa en trucos para optimizar.
| Se basa en propiedades algebraicas para optimizar.
|
Así que hay que hacer que el programador deje de pensar en acumuladores y pase a pensar en propiedades algebraicas. Es decir, usar catamorfismos en vez de bucles. Los catamorfismos no son más que funciones que toman una estructura de datos y devuelven un valor a partir de ella con la propiedad de que son morfismos. En el caso de sumar una lista de números sería algo así como convertir la concatenación en suma.
[$$ f( [ 3, 5 ] .. [4, 7] ) = f( [3,5] ) + f( [4, 7] ) $$]
Esto significa a su vez que hay que buscar una operación con las propiedades algebraicas que deseemos (o podamos obtener), lo cual puede llevar a comprender más profundamente el problema.
La especificación del catamorfismo es similar al uso de sumatorios en matemáticas. No se especifica el orden de la suma, sólo que hay que sumar los elementos.
[$$ \sum_{i=1}^{n} {x_i} $$]
En programación esto se tendría que hacer usando funciones de alto nivel como fold pero asumiendo la asociatividad.
fold_assoc( suma, [3, 5, 4, 7] )
Así el compilador podría optimizar usando paralelismo sin que el programador tuviera que luchar con sincronizaciones y demás.
martes, 13 de julio de 2010
Los estados corrientes de MIDI
MIDI
MIDI (Musical Instrument Digital Interface) es una interfaz multinivel (físico y enlace) ideado en 1982 que transmite información musical entre dispositivos compatibles. La forma de transmisión es mediante una comunicación serie.
La idea principal es que se transmite información musical, no de audio. Los mensajes que se transmiten los dispositivos son del tipo "toca esta nota" y "sube el volumen".
Lo más curioso del protocolo de enlace es que siempre se transmiten bytes, pero los hay de dos tipos.
La secuencia enviada por el cable sería:

Comprimiendo datos MIDI
La distinción entre códigos de estado y datos tiene otra función de compresión de la información. Es el llamado "running status" o, en una traducción a vuelapluma, los estados corrientes. Es bien sencillo. Si queremos transmitir dos notas, ¿para qué repetir el código de estado? Se asume el anterior. Entonces, la siguiente secuencia tendría este significado:
Finalmente, existe un ligero cambio en el significado de "tocar nota" para comprimir más aún los datos. Debido a que lo más común es tocar nota y parar nota, es posible parar notas usando velocidad cero en "tocar nota". De esta manera se evita enviar el código de estado para parar nota y volverlo a enviar para seguir tocando. El único inconveniente de este sistema es que no puedes decir la velocidad del parado de la nota que se toma por defecto 64.
Con este truco la secuencia de arriba quedaría:
Desgraciadamente, estos detalles perduran en el tiempo hasta hoy en día y, de vez en cuando, le da algún que otro quebradero de cabeza a los desarrolladores.
MIDI (Musical Instrument Digital Interface) es una interfaz multinivel (físico y enlace) ideado en 1982 que transmite información musical entre dispositivos compatibles. La forma de transmisión es mediante una comunicación serie.
La idea principal es que se transmite información musical, no de audio. Los mensajes que se transmiten los dispositivos son del tipo "toca esta nota" y "sube el volumen".
Lo más curioso del protocolo de enlace es que siempre se transmiten bytes, pero los hay de dos tipos.
- Los que tienen a 1 su bit más significativo son los llamados "códigos de estado".
- Los que tienen a 0 su bit más significativo son los datos de esos códigos de estado.
La secuencia enviada por el cable sería:
- 0b10010000 Código de estado: tocar nota
- 0b00111100 Nota do central
- 0b01010000 Volumen 80

Comprimiendo datos MIDI
La distinción entre códigos de estado y datos tiene otra función de compresión de la información. Es el llamado "running status" o, en una traducción a vuelapluma, los estados corrientes. Es bien sencillo. Si queremos transmitir dos notas, ¿para qué repetir el código de estado? Se asume el anterior. Entonces, la siguiente secuencia tendría este significado:
- 0b00010011 Dato inesperado: se ignora.
- 0b10010000 Código de estado: tocar nota
- 0b00111100 Nota do central
- 0b01010000 Velocidad 80
- 0b01000000 ¡Repetimos código de estado! Nota mi
- 0b00111100 Velocidad 80
- 0b01000011 ¡Repetimos código de estado! Nota sol
- 0b00111100 Velocidad 80
- 0b10000000 Código de estado: parar nota
- 0b00111001 Nota la
- 0b01000000 Velocidad 64
- 0b10010000 Código de estado: tocar nota
- 0b01001000 Nota do (siguiente octava)
- 0b01010000 Velocidad 80
Finalmente, existe un ligero cambio en el significado de "tocar nota" para comprimir más aún los datos. Debido a que lo más común es tocar nota y parar nota, es posible parar notas usando velocidad cero en "tocar nota". De esta manera se evita enviar el código de estado para parar nota y volverlo a enviar para seguir tocando. El único inconveniente de este sistema es que no puedes decir la velocidad del parado de la nota que se toma por defecto 64.
Con este truco la secuencia de arriba quedaría:
- 0b00010011 Dato inesperado: se ignora.
- 0b10010000 Código de estado: tocar nota
- 0b00111100 Nota do central
- 0b01010000 Velocidad 80
- 0b01000000 ¡Repetimos código de estado! Nota mi
- 0b00111100 Velocidad 80
- 0b01000011 ¡Repetimos código de estado! Nota sol
- 0b00111100 Velocidad 80
- 0b00111001 ¡Repetimos código de estado! Nota la
- 0b00000000 Velocidad 0 = parar nota la
- 0b01001000 ¡Repetimos código de estado! Nota do+
- 0b01010000 Velocidad 80
Desgraciadamente, estos detalles perduran en el tiempo hasta hoy en día y, de vez en cuando, le da algún que otro quebradero de cabeza a los desarrolladores.
jueves, 6 de mayo de 2010
Las guerras del RIA
Hace poco saltó la noticia de que Apple prohibía cualquier cosa que no estuviera hecha con C/C++, objective C o JavaScript en sus iPhone e iPad. El enfado ha sido monumental en muchos sitios, llamando a la nueva licencia, por ejemplo, la iNazi.
Uno de los grandes perjudicados ha sido Adobe, cuyo sistema RIA (Flash) no podrá ser portado. Teniendo en cuenta que esta portabilidad ha sido uno de los buques insignia de Adobe en este campo, le ha hecho mucho daño. El resultado ha sido una demanda por monopolio contra Apple.
A todo esto, el ganador podría ser el nuevo estándar HTML 5 que incluye bastantes características nuevas orientadas a RIA. Desarrollado por el W3C, es un estándar libre y, además, está siendo apoyado por Apple.
¿Me parece a mí o las tecnologías libres han encontrado una nueva utilidad: ser usadas como armas arrojadizas contra la competencia?
miércoles, 24 de marzo de 2010
La ley de Fitts
La ley de Fitts es muy simple:
Cuanto más cerca esté y más grande sea, más fácil es pulsar un botón.
Esta simple ley es la piedra angular del desarrollo de interfaces gráficas de usuario. Desafortunadamente, parece ser que no se sigue todo lo que debiera.
miércoles, 11 de noviembre de 2009
De objetos y TADs
Leo desde LtU un ensayo de W.R.Cook que explica por qué un objeto no es un tipo abstracto de datos (TAD o ADT en inglés).
Resumiendo las diferencias sería:
- Un objeto no necesita tipado estático. De hecho, hay muchos lenguajes orientados a objetos con tipado dinámico. Lo que necesitan los objetos es alguna forma de funciones de orden superior para la vinculación dinámica.
- Los objetos no soportan operaciones "complejas" que tengan que inspeccionar otros objetos. De hecho, los objetos sólo pueden inspeccionarse a ellos mismos (o, según el lenguaje, a otros de su misma clase). Esto es una desventaja al principio, pero luego permite una mayor escalabilidad.
- Los TAD permiten extender el comportamiento añadiendo nuevas funcionalidades y operaciones, mientras que los objetos extienden el comportamiento añadiendo nuevas representaciones.
En general, si mi comprensión no ha fallado, los TAD ocultan la representación y muestran las operaciones. Los objetos muestran la representación y ocultan las operaciones (que pasan a ser parte de la representación via vinculación dinámica).
martes, 22 de septiembre de 2009
Compatibilidad hacia atrás en lenguajes
Una cosa que nunca he entendido es la cerrazón de los diseñadores de lenguajes de programación en mantener la compatibilidad hacia atrás. Esto ha hecho que los lenguajes empiecen a tener complicaciones innecesarias y, como no se pueden quitar, cada vez habrá más complicaciones innecesarias.
¿Por qué no usar una opción en el compilador que regule la versión que queremos usar de una característica del lenguaje? Tenemos infinidad de opciones en el compilador: tipo de biblioteca en tiepo de ejecución, definición de símbolos, grado de optimización, juego de caracteres a usar, directorios de inclusión, etc. ¿Qué ocurriría si añadiésemos una más indicando la versión del código?
Quizás la única parte que no se debería tocar es la de las interfaces ya que tendrían que interoperar y eso implicaría mantener su versión, pero el resto es modificable. Así, los lenguajes irían refinándose. Los códigos antiguos (legacy) seguirían funcionando. ¿Qué problema hay que no atino a ver para que no se use esto?
sábado, 27 de junio de 2009
Consejos para APIs
Leo en el blog de lightsleeper unos consejos para hacer APIs.
- Deben ser intuitivas. Los nombres han de ser significativos y deben dar una idea de lo que hacen las funciones sin tener que leer los documentos.
- Deben ser simples. Es decir, seguir el principio KISS y si pueden hacer sólo una cosa en vez de dos, mejor. Cuantos menos parámetros mejor, cuantas menos funciones mejor, cuantos menos tipos mejor.
- Debe ser difícil equivocarse. Con pocos estados, pocos errores y con un tipado que evite que compile si se intentan hacer cosas mal. Los fallos se deben detectar en compilación y no en ejecución.
- No deben tener efectos secundarios. Realmente esto es parte de la simplicidad. Tener estados ocultos, variables globales perdidas y demás complica la cosa.
- Debe ser consistente. En el nombrado de funciones y parámetros, en el orden de las mismas, en la nomenclatura de tipos, variables y demás opciones estilísticas. También deben usarse las convenciones conocidas ("ptr" es puntero y no "poi", etc.)
Hay un par de puntos relativos a la hora de revisar las API que no voy a incluir porque prefiero este punto que leí en algún otro lado:
- La regla del tres: Haz tres programas que usen la API. Si usas uno, seguro que luego te van a faltar o sobrar cosas. Si usas dos te quedarán bugs y sutilezas. Con tres también, pero serán menos y la API será usable.
Finalmente, otro consejo que leí por ahí tiempo ha:
- Una API es un lenguaje. Cada palabra debe ser un concepto. Cuando dos desarrolladores hablen de tu API deben hacerlo en ese lenguaje especial que has inventado.
Suscribirse a:
Entradas (Atom)
