Mostrando entradas con la etiqueta manejo de memoria. Mostrar todas las entradas

martes, 19 de abril de 2011

miniSL parte 12 - Limitaciones y uso del recolector de basura

Hasta ahora hemos hablado del montículo, las celdas y  cómo crearlas. Sin embargo, no hemos visto cómo se usa la recolección de basura implementada y, tampoco, sus limitaciones.

La recolección de basura sirve para detectar celdas no usadas y marcarlas como tales. La forma de hacerlo es muy sencilla. Tenemos un conjunto raíz que son celdas que sabemos a ciencia cierta que son usadas de forma. A partir de ese conjunto exploramos qué otras celdas usan. El resto son celdas sin usar. Este algoritmo se denomina mark and sweep (marca y barre). El código para esto se adelantó en la parte 8, pero queda por saber cómo se usa exactamente.

Lo importante son las limitaciones del algoritmo de recolección de basura implementado en miniSL. Son las siguientes.

  • El algoritmo de mark and sweep usado detiene la ejecución. Aunque este es el menor de nuestros problemas como veremos más adelante.
  • El algoritmo usado sólo usa el entorno global (lo veremos con más detalle en la siguiente parte) como el conjunto raíz. Esto quiere decir que no podemos llamar el algoritmo en medio de la ejecución del código porque la celda que contiene el entorno local de la función no forma parte del conjunto raíz.
  • En concreto, no podríamos lanzar el recolector de basura cuando notemos que nos hemos quedado sin memoria. Por ejemplo, en el caso de entrar en la línea 6 de la función Script::CreateCell(). Por esa razón, hemos de reservar una nueva celda y no reutilizar una antigua.
  • La estructura del recolector de basura no es incremental. El algoritmo mark and sweep usa dos conjuntos de celdas: las marcadas (usadas) y las no marcadas (no usadas). Para poder hacer un recolector de basura incremental hacen falta tres conjuntos llamados de celdas blancas, grises y negras.
  • Debido a todo esto, el propio miniSL no puede llamar al recolector de basura. Lo tiene que hacer la aplicación que use el script.

Ni que decir tiene que estas limitaciones hacen el lenguaje miniSL inútil en la vida real, pero simplifican muchísimo el código. Nosotros lo que haremos será llamar al recolector de basura en cada ciclo del bucle de lectura-evaluación-impresión o (REPL).
Este bucle será ahora:

  • Lectura de una expresión.
  • Evaluación de la expresión.
  • Impresión del resultado.
  • Recolección de basura.

Veremos el REPL en la parte 32, ya que antes hemos de definir cómo evaluamos y cómo leemos una expresión. Hasta ahora sólo sabemos imprimir las celdas.

En la siguiente entrada nos centraremos en el conjunto raíz de nuestro recolector de basura. Es decir, en el entorno global que contiene los símbolos definidos más generales.

domingo, 13 de marzo de 2011

miniSL parte 11 - Operaciones sobre el montículo

Ya hemos descrito el montículo en la parte octava. Ahora vamos a realizar dos tipos de operaciones sobre él. El primer grupo es el de las operaciones de reserva de memoria, mientras que el segundo grupo son las operaciones de liberado de memoria. En este post veremos las del primer grupo.
Inicialmente tenemos la creación de una celda genérica con dos referencias.

CELL& Script::CreateCell(CELL_TYPE ct, CELL* first, CELL* second)
{
 CELL* p;
 if(m_FirstUnused==NULL)
 {
  CELL c;
  m_Cells.push_back(c);
  p=&m_Cells.back();
 }
 else
 {
  p=m_FirstUnused;
  m_FirstUnused=p->next_unused;
 }
 p->mark=false;
 p->type=ct;
 p->head=first;
 p->tail=second;
 return *p;
}

Somos astutos y antes de reservar memoria (con el push_back) vemos si tenemos alguna celda libre ya reservada. Esto es algo ineficiente porque la celda que reservemos no vuelve a liberarse realmente, sólo se apunta como liberada. Todo sea por ser simples en la implementación.
Para crear celdas de otros tipos, primero creamos una celda genérica con Script::CreateCell y luego cambiamos sus campos específicos. Por ejemplo, para una cadena no interna.

CELL& Script::CreateString(STRING const& val)
{
 CELL& c=CreateCell(STRING_LIT);
 c.string_val=new STRING(val);
 return c;
}

En el caso de una cadena interna hemos de recurrir a las técnicas comentadas en la parte séptima. En concreto, usaremos el mapa m_InternedStrings para comprobar si ya tenemos o no la cadena internada. Si es así, la usamos. Si no, la creamos y la guardamos en el m_InternedStrings.

CELL& Script::CreateName(STRING const& val)
{
 STRING_MAP::const_iterator i=m_InternedStrings.find(val);
 if(i==m_InternedStrings.end())
 {
  CELL& c=CreateCell(NAME_CODE);
  i=m_InternedStrings.insert(std::make_pair(val, &c)).first;
  c.string_val=&i->first;
 }
 return *i->second;
}

Aquí se ve el truco comentado en la parte séptima: se usa la propia clave del mapa como la cadena interna. Esto nos fuerza a realizar la inserción en dos partes. Primero la celda de tipo NAME_CODE sin ningún puntero iniciado y, luego, se inicia el puntero string_val a la dirección de la clave i->first.

Para crear un entorno necesitamos crear adicionalmente su tabla de símbolos.

CELL& Script::CreateEnvir(CELL* parent)
{
 CELL& c=CreateCell(ENVIR_VAL);
 c.envir_table=new ENVIR_TABLE;
 c.parent_envir=parent;
 return c;
}

Y más sencillo aún son las funciones nativas porque son trozos de código que no se elimina nunca. En este caso necesitamos una función especial meramente porque el tipo es NATIVE y no CELL.

CELL& Script::CreateNative(NATIVE native)
{
 CELL& c=CreateCell(NATIVE_VAL);
 c.native=native;
 return c;
}

Con esto está la creación de celdas completada. En el siguiente apartado veremos cómo se usa el recolector de basura (garbage collector) del cual ya adelantamos algo en la parte octava.

sábado, 15 de enero de 2011

miniSL parte 8 - El montículo

Llega el momento de pensar dónde y cómo almacenar las celdas en memoria. La forma en la que vamos a hacerlo es la siguiente. Usaremos un std::deque para reservar memoria. Los deques permiten ir añadiendo memoria conforme se necesite y no mueven los bloques de memoria una vez reservados.

De todas las celdas que hayamos reservado, usaremos unas y tendremos otras libres, sin usar. Utilizaremos la recolección de basura para pasar celdas antes usadas pero ahora ociosas a celdas sin usar y libres para su reciclado.

La recolección de basura es un procedimiento que puede ser o bien muy complejo o bien muy simple. En este caso, y teniendo en cuenta que miniSL intenta implementarlo todo de la forma más simple y reducida, nos inclinaremos por el algoritmo más simple de recolección de basura. El llamado mark and sweep (marca y barre).

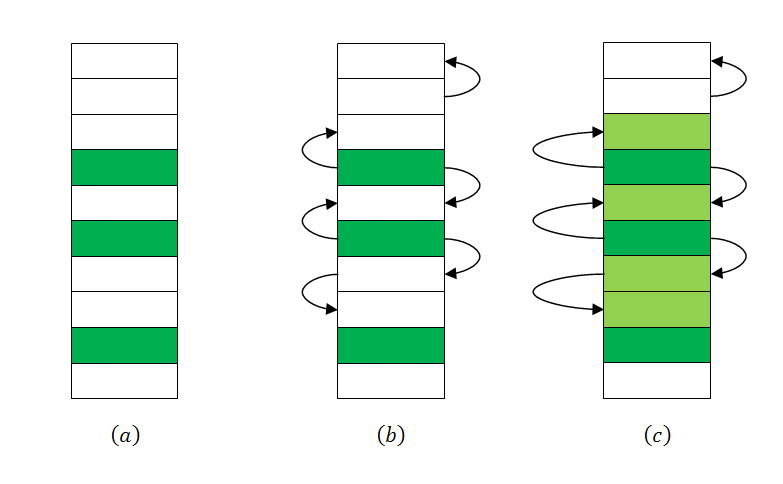
El mark and sweep funciona en dos pasos. El primer paso detecta las celdas en uso. ¿Cómo hace eso? Muy simple. O bien es una celda raíz (que siempre está en uso) o bien nos referencian desde otra celda en uso. Estas celdas en uso son marcadas. El segundo paso es barrer (=reciclar) todas las celdas que no están marcadas y limpiar la marca en las que sí.


La siguiente figura muestra a) el conjunto raíz, b) los punteros entre celdas y c) las marcas. Las celdas que en c) no estén marcadas (las blancas) serán las reclamadas por el recolector de basura y pasarán a estar libres para un posterior uso.

En la implementación lo primero que tenemos es el std::deque de almacenamiento de celdas.

CELL_STORAGE m_Cells;

Recordemos que definíamos CELL_STORAGE así:

typedef std::deque<CELL> CELL_STORAGE;

También necesitamos saber si hay celdas libres. Las pondremos todas en una lista simplemente enlazada que empieza en el campo m_FirstUnused.

CELL* m_FirstUnused;

Para reservar una celda primero vemos si hay alguna libre. Si no, aumentamos el std::deque reservando memoria para una celda más. Esto no es muy económico ya que lo interesante habría sido devolver la memoria usada por las celdas libres. Estamos actuando más bien como un pool que como un gestor de memoria.

CELL& Script::CreateCell(CELL_TYPE ct, CELL* first, CELL* second)
{
 CELL* p;
 if(m_FirstUnused==NULL)
 {
  CELL c;
  m_Cells.push_back(c);
  p=&m_Cells.back();
 }
 else
 {
  p=m_FirstUnused;
  m_FirstUnused=p->next_unused;
 }
 p->mark=false;
 p->type=ct;
 p->head=first;
 p->tail=second;
 return *p;
}

El algoritmo de marcado es recursivo de manera que explora todo el grafo de referencias (punteros entre celdas) en profundidad. Dependiendo del tipo de celda, alguno o ninguno de sus campos serán referencias que hay que explorar. Evitamos los posibles ciclos no volviendo a marcar las celdas ya marcadas.

void Script::GCMark(CELL* c)
{
 if(c==NULL || c->mark)
 return;

 c->mark=true;

 switch(c->type)
 {
 case UNUSED:  throw L"Marking unused cell";
 case CONS_CTOR:  GCMark(c->head); GCMark(c->tail);  break;
 case LAMBDA_VAL: GCMark(c->code); GCMark(c->closure);  break;
 case COMBINE_CODE: GCMark(c->op);  GCMark(c->operands); break;

 case ENVIR_VAL:
  GCMark(c->parent_envir);
  for(ENVIR_TABLE::const_iterator i=c->envir_table->begin(); i!=c->envir_table->end(); ++i)
  {
   GCMark(i->first);
   GCMark(i->second);
  }
  break;
 }
}

El caso más laborioso es el de los entornos. En ellos hay que iterar su contenido y explorarlo para el marcado.
El borrado ocurre en la rutina de barrido. Es simple y su única dificultad radica en las celdas especiales que contienen algún dato externo. Ya vimos uno de estos casos en las cadenas internas. Las cadenas normales y los entornos son otros casos similares. Cada uno de ellos ha de tener un borrado específico.

int Script::GCSweep()
{
 int count=0;
 for(CELL_STORAGE::iterator i=m_Cells.begin(); i!=m_Cells.end(); ++i)
 {
  if(i->mark)
  {
   i->mark=false;
   continue;
  }

  if(i->type==UNUSED)
   continue;

  ++count;

  switch(i->type)
  {
  case STRING_LIT: delete i->string_val;      break;
  case ENVIR_VAL:  delete i->envir_table;      break;
  case NAME_CODE:  m_InternedStrings.erase(*i->string_val); break;
  }

  i->type=UNUSED;
  i->next_unused=m_FirstUnused;
  m_FirstUnused=&*i;
 }
 return count;
}

Como conjunto raíz vamos a tener únicamente el entorno global. Añadimos una referencia a la celda de entorno de que lo contenga y lo marcamos en la recolección de basura.

int Script::GarbageCollect()
{
 GCMark(m_GlobalEnvir);
 return GCSweep();
}

A partir de aquí hemos de recordar que el entorno global es una celda destacada. De hecho, estará referenciada en la clase Script.

CELL* m_GlobalEnvir;

El lector atento habrá visto que hemos retornado el número de celdas barridas en el recolector de basura. El retorno del número de celdas es un buen sistema para depurar el recolector de basura, pero no es el único. De hecho, nos ofrece poca información. Otro sistema que va a ser útil no sólo para el recolector de basura sino también para observar los resultados de las evaluaciones es la impresión de celdas. En la siguiente entrada nos dedicaremos a esta tarea.

lunes, 25 de octubre de 2010

miniSL parte 3 - Celdas

Para cada una de las partes mencionadas anteriormente, tendremos que escribir un programa que tomará una entrada y devolverá una salida.
  • Escaneador: Caracteres a tokens.
  • Reconocedor: Tokens a AST.
  • Generador: AST a código intermedio (o máquina).
  • Ejecución: Código intermedio (o máquina) a valores de resultado.
Debido a que vamos a realizar un intérprete muy simple (el paso 3 se omite y la ejecución evalúa directamente el AST) durante ejecución necesitamos trabajar con dos tipos de objetos: el AST y los valores. Usaremos una misma estructura para almacenar ambos tipos: la celda (CELL). La celda es el nombre usual de la unidad de memoria cuando ésta es uniforme. Ayudará en el futuro para la recolección de basura.

Llamaremos valor a los posibles resultados de la evaluación de cierto código (código=AST). En principio, sólo podremos evaluar el código aunque existen valores que son código y se evalúan a ellos mismos: los literales como el entero 3 o la cadena "hola". Las celdas de valor entero serán del tipo INT_VAL y las cadenas STRING_VAL.


Es probable que necesitemos alguna celda especial de gestión del propio intérprete y que no será ni código ni valor (por ejemplo, una celda sin usar UNUSED). También (y coincidiendo con el LISP) tomaremos el constructor de lista (CONS_CTOR) como código y valor, aunque no es literal ya que lo evaluaremos. Así que, por ahora lo que tendría sería la siguiente clasificación de tipos de celdas.

enum CELL_TYPE
{
UNUSED, 

//Literals
INT_VAL, STRING_VAL,

//Value constructors

//Code constructors

//Value and code constructors
CONS_CTOR,
};

Para terminar de rellenar esta lista de tipos de celda necesitamos saber cómo construir código y eso requiere conocer la sintaxis. Por eso la siguiente entrada de esta serie se dedicará a elegir una sintaxis para nuestro lenguaje script.

jueves, 15 de abril de 2010

La cadena dinámica y la cadena estática

La cadena dinámica

Supongamos el siguiente código

f(x) { return g(x) }
g(y) { return h(y) }
h(z) { return z }

Cuando ejecutamos f(3), creamos un entorno con x=3 y evaluamos "return g(x)". Esto es una llamada a g(y) por lo que creamos otro entorno con y=3 y evaluamos "return h(y)". ¡Pero esto no es todo! De alguna manera debemos saber que cuando obtengamos el resultado de "h(y)" hemos de volver al entorno que llamó a "g(y)". Es decir, el entorno inicial con "x=3".

Esto produce una cadena de entornos que se va construyendo conforme el programa se va evaluando. En el caso de antes, cuando estamos en "return z" la cadena sería:

f(3), g(3), h(3)

Esto no es más que la pila de llamadas. Nada nuevo.

La cadena estática

Modifiquemos el código anterior de la siguiente manera.

f(x) { g(y) { h(z) { return z } ; return h(y) } ; return g(x) }

Muchos lenguajes no permiten esta construcción de funciones anidadas. Esto es debido a que en este caso hay que guardar el entorno de clausura de las funciones. Para entender la clausura lo más sencillo es introducir una variable que no esté declarada. Por ejemplo, cambiando la definición de "h" por

h(z) { return z+v }

El resultado es que como no conocemos el valor de "v", no podemos calcular "z+v" y, por ende, "h(z)". Cuando esto ocurre se dice que la expresión está abierta.

La forma de poder calcular lo anterior es cerrando la expresión dándole un valor a "v". Lo más natural es que ese valor esté en un entorno exterior.

{
v=3
...
h(z) { return z+v }
}

De alguna manera hay que disponer del entorno exterior en "h(z)". Si ahora volvemos al ejemplo del inicio de esta sección, podríamos usar en vez de "v", "x".

f(x) { g(y) { h(z) { return z+x } ; return h(y) } ; return g(x) }

¿Cómo sabe ahora "h(z)" el valor de "x" cuando sea llamada? Necesita un enlace, llamado el enlace estático, al entorno de "f(x)".  Sin embargo, las cosas no son tan simples por dos razones.

La primera es que el entorno de "f(x)" va a ser distinto según se cree en una llamada o en otra. Por ejemplo, en "f(3)" vamos a tener el entorno "x=3" y en "f(7)" pues "x=7".

La segunda es que podemos devolver una referencia a la propiar función. Supóngase:

f(x) { g(y) { return y+x } ; return g }

En este caso hemos de agrupar tanto la definición de la función "g" como el entorno en el que se definió en un único objeto. Como este objeto lo que hace es darle un valor a las variables no definidas de la función (en este caso la "x") lo que hace es la clausura de tal función. Por lo tanto a este tipo de objeto se le llama una clausura o una clausura léxica.

Pues bien, la cadena formada por todos los enlaces estáticos que atraviesa las clausuras léxicas de la función actual es la cadena estática.

Ni que decir tiene que la cadena estática es bastante más difícil de implementar que la dinámica. Para esta última basta una pila, pero para la anterior hace falta usar recolección de basura si se quiere usar en toda su capacidad. Es por esta razón que el LISP (el primer lenguaje con recolección de basura) fuera también el primero en implementar la cadena estática (el llamado "lexical scoping" del Scheme).

viernes, 11 de septiembre de 2009

Herencia y subtipo

Hoy en día en los lenguajes orientados a objetos es común hacer cosas del tipo

class A { int x; };

class B: public A { int y; };

Y decimos que la clase "B" hereda de la clase "A" y por lo tanto puedo usar "B" en cualquier sitio donde pueda usar "A". ¿Seguro?

Esto es erróneo y el ejemplo es claro arriba. La clase "A" ocupa el tamaño de un entero mientras que la clase "B"  ocupa el tamaño de dos por lo que es imposible usar la clase "B" en un espacio donde estaba la clase "A" porque no cabe.

Esto me lleva a pensar que subtipo (sustitución) y herencia (derivación de clases unas de las otras) no son completamente equivalentes. Muchos lenguajes lo ocultan mediante la prohibición de tener acceso directamente a las clases y sólo se pueden usar punteros o referencias a los objetos de las mismas (y el lenguaje se encarga de la gestión de memoria para que no podamos hacer cosas raras). Por ejemplo, Java y C# siguen este paradigma.

En otros lenguajes donde sí se puede acceder directamente a los objetos de las clases ocurren otros tipos de problemas indeseables como el slicing. Ahí están las grietas que separan subtipado de herencia. De hecho, la herencia ¡es una composición! La magia radica en que es una composición especial (usualmente la clase base es el primer miembro oculto de la clase hija) y los símbolos de la clase padre se importan subrepticiamente a la clase hija. De esta manera, cualquier uso de los miembros de la clase padre se corresponden con los mismos miembros de la clase hija. Esto es lo que da esa apariencia de sustitutibilidad.

martes, 23 de junio de 2009

¿Recolección de basura?

Leyendo barrapunto he llegado a una página donde muestran una gráfica sobre el consumo de memoria de los navegadores. La gráfica en cuestión es esta:


Lo primero que sorprende es la forma de diente de sierra del consumo de memoria. Rápidamente se me viene a la cabeza que se esté usando un recolector de basura y las caídas bruscas son cuando se realiza la limpieza. Por esa misma regla de tres, parece que el navegador Opera no realiza recolección de basura o que, incluso, pueda tener algún escape de memoria.

Es una pena que no tengamos información sobre el comportamiento de los programas cuando están en fase de limpieza. ¿Algún usuario de estos navegadores ha notado cuándo se ejecuta el recolector de basura? Y, otra cosa, ¿no había por ahí un navegador que se llamaba Explorer o algo así?