Los números complejos siempre me han parecido maravillosos. Descubro nuevas propiedades una y otra vez. La que traigo hoy es simple y misteriosa.
Supongamos que tengo una circunferencia [$C$] formada por los elementos [$z\in C$]. Entonces si hago la inversa de sus elementos, el conjunto que obtengo [$C'=\{1/z\mid z\in C\}$] es también una circunferencia.
La demostración se me ha resistido un poco, pero una vez descubierta, es hasta sencilla. Sea [$c$] el centro del círculo y [$R\ge 0$] su radio.[$$|z-c|=R$$][$$|z-c|^2=R^2$$] [$$(z-c)(z-c)^*=R^2$$][$$zz^*-cz^*-c^*z+cc^*=R^2$$]Ahora hago [$w=1/z$] por lo que llego a [$$\frac{1}{w} \frac{1}{w^*}-c \frac{1}{w^*} -c^* \frac{1}{w} +cc^*=R^2$$] Si asumo que [$w\ne 0$], es decir, [$z<\infty$], llego a [$$1-c w -c^*w^* +cc^*ww^*=R^2ww^*$$]Reordenando un poco [$$1-c w -c^*w^* +(cc^*- R^2 )ww^*=0$$] Y si asumo que [$cc^*\ne R^2$] (es decir [$|c|\ne R$]) llego hasta [$$ww^*-\frac{c w}{cc^*- R^2}-\frac{c^*w^*}{ (cc^*- R^2)^2 } + \frac{1}{ cc^*- R^2 } =0$$] [$$\left(w-\frac{c^*}{cc^*- R^2}\right) \left(w-\frac{c^*}{cc^*- R^2}\right)^*-\frac{cc^*}{ (cc^*- R^2)^2 } + \frac{1}{ cc^*- R^2 } =0$$] [$$\left(w-\frac{c^*}{cc^*- R^2}\right) \left(w-\frac{c^*}{cc^*- R^2}\right)^* = \frac{R^2}{(cc^*- R^2)^2 }$$] ¡Y ya lo tenemos! [$$\left|w-\frac{c^*}{cc^*- R^2}\right|^2 = \frac{R^2}{ (cc^*- R^2)^2 }$$] [$$\left|w-\frac{c^*}{cc^*- R^2}\right| = \frac{R}{ cc^*- R^2 }$$]
La nueva circunferencia tiene de centro [$ \frac{c^*}{cc^*- R^2}$] y de radio [$ \frac{R}{ cc^*- R^2 } $].
Para los curiosos, las hipótesis de que [$z<\infty$] y que [$|c|\ne R$] aparecen porque estamos restringiéndonos a circunferencias. Si no las tomamos, llegamos a que circunferencias o rectas se transforman en circunferencias o rectas. Las rectas pueden ser vistas comocircunferencias con el centro en el infinito y por tanto se dice que transformamos circunferencias generalizadas en circunferencias generalizadas.
La mejor forma de ver esto es mediante la esfera de Riemann, pero ya lo dejamos para otro día.
Mostrando entradas con la etiqueta matemáticas. Mostrar todas las entradas
Mostrando entradas con la etiqueta matemáticas. Mostrar todas las entradas
lunes, 21 de octubre de 2013

viernes, 2 de marzo de 2012
Pequeña introdución al álgebra geométrica
Operaciones del cálculo vectorial y su simplificación
Supongo que el lector sabe que el cálculo vectorial añade dos operaciones a las propias de un espacio vectorial. Las operaciones propias de un espacio vectorial son el producto por un escalar ([$\lambda a$]) y la suma de vectores ([$a+b$]). Las añadidas por el cálculo vectorial son el producto escalar ([$a\cdot b$]) y el producto vectorial ([$a\times b$]).
¿Existirá alguna manera de simplificar este esquema volviendo únicamente a dos operaciones? Bueno, es fácil sobrecargar el producto para que, si uno de sus factores es escalar, se comporte como el producto por un escalar. Ahora queda pensar en cómo aglutinar el producto escalar y el vectorial. La idea básica surge de la forma en la que estos productos tratan los vectores proporcionales y ortogonales.
| [$a$] y [$b_\parallel$] son proporcionales | [$a\cdot b_\parallel=b_\parallel\cdot a$] | [$a\times b_\parallel=0$] |
| [$a$] y [$b_\bot$] son ortogonales | [$a\cdot b_\bot=0$] | [$a\times b_\bot=-b_\bot\times a$] |
Como todo vector puede ser descompuesto en una parte proporcional y otra ortogonal, lo que tenemos al final es que si [$b=b_\parallel+b_\bot$][$$a\cdot b=a\cdot (b_\parallel+b_\bot )=a\cdot b_\parallel+a\cdot b_\bot=a\cdot b_\parallel+0=a\cdot b_\parallel$$][$$a\times b=a\times (b_\parallel+b_\bot )=a\times b_\parallel+a\times b_\bot=0+a\times b_\bot=a\times b_\bot$$]Si de alguna manera el nuevo producto fuera similar a una suma de tanto el producto escalar como el producto vectorial, podríamos unificarlos en un mismo producto simplificado al que llamaremos producto geométrico.[$$ab=a(b_\parallel+b_\bot )=ab_\parallel+ab_\bot$$]Donde la parte [$ab_\parallel$] estará relacionada con el producto escalar y la parte [$ab_\bot$] con el producto vectorial. Lo único que hemos requerido es la propiedad distributiva que, de todas las maneras, debe tener un producto lineal.
Debido a que queremos que la parte [$ab_\parallel$] siga las propiedades del producto escalar, tendrá que ser simétrica; y debido a que queremos que la parte [$ab_\bot$] siga las propiedades del producto vectorial, tendrá que ser antisimétrica: [$$ab_\parallel=b_\parallel a$$][$$ab_\bot=-b_\bot a$$] Y, a partir de ellas llegamos a: [$$ba=(b_\parallel+b_\bot )a=b_\parallel a+b_\bot a=ab_\parallel-ab_\bot$$] Este resultado es muy interesante ya que nos va a permitir obtener la parte relacionada con el producto escalar y la parte relacionada con el producto vectorial a partir del nuevo producto geométrico. [$$ab+ba=2ab_\parallel$$][$$ab-ba=2ab_\bot$$]Esta es la idea. Sustituimos dos productos por uno del que, de la forma arriba vista, puede volver a extraerse la información de cada uno de esos dos productos iniciales.
Definiendo el producto geométrico
La forma usual que tenemos de analizar una operación en un espacio vectorial es descomponiendo los vectores como una combinación lineal de los vectores de una base. Bastará ver cómo opera el producto con estos vectores de la base.
Cuando una base [$\{e_1,e_2,e_3\}$] de un espacio vectorial [$V$] es ortonormal el producto escalar se comporta tal como se expresa en la siguiente tabla de Cayley.
| [$\cdot$] | [$e_1$] | [$e_2$] | [$e_3$] |
|---|---|---|---|
| [$e_1$] | [$1$] | [$0$] | [$0$] |
| [$e_2$] | [$0$] | [$1$] | [$0$] |
| [$e_3$] | [$0$] | [$0$] | [$1$] |
| [$\times$] | [$e_1$] | [$e_2$] | [$e_3$] |
|---|---|---|---|
| [$e_1$] | [$0$] | [$e_3$] | [$e_2$] |
| [$e_2$] | [$-e_3$] | [$0$] | [$e_1$] |
| [$e_3$] | [$-e_2$] | [$-e_1$] | [$0$] |
En el caso del producto geométrico vamos a tener una mezcla de ambos tipos de producto, con ciertas particularidades. La primera es que incluimos el [$1$] como un componente de la base, ya que queremos subsumir el producto por escalar en el producto geométrico. Esto diluye la diferencia entre el cero escalar y el cero vectorial. El resultado es la siguiente tabla de Cayley.
| [$1$] | [$e_1$] | [$e_2$] | [$e_3$] | |
|---|---|---|---|---|
| [$1$] | [$1$] | [$e_1$] | [$e_2$] | [$e_3$] |
| [$e_1$] | [$e_1$] | [$1$] | [$e_1 e_2$] | [$e_1 e_3$] |
| [$e_2$] | [$e_2$] | [$e_2 e_1=-e_1 e_2$] | [$1$] | [$e_2 e_3$] |
| [$e_3$] | [$e_3$] | [$e_3 e_1=-e_1 e_3$] | [$e_3 e_2=-e_2 e_3$] | [$1$] |
Las signaturas del producto escalar, vectorial y geométrico son:[$$ \_\cdot\_:V\times V \to \mathbb{K}$$][$$ \_\times\_ : V\times V \to V $$][$$ \_\ \_:\Lambda(V)\times\Lambda(V)\to\Lambda(V)$$]
Ahora bien, ¿qué componentes tendrá la base de este espacio [$\Lambda(V)$]? ¿Faltará alguno más? Podemos volver a repetir el producto sobre [$e_1 e_2$] y obtener cosas como [$e_1 e_3 e_2$] o [$e_2 e_3 e_1 e_2$], lo que ocurre es que al final se simplifican o bien a [$e_1 e_2 e_3$] o a otra de las combinaciones vistas hasta ahora. Lo único que se requiere es asociatividad y la propiedad de elemento neutro escalar [$1A=A$].[$$ e_1 e_3 e_2=e_1 (e_3 e_2 )=-e_1 (e_2 e_3 )=-e_1 e_2 e_3$$][$$e_2 e_3 e_1 e_2=-e_2 e_3 e_2 e_1=e_2 e_2 e_3 e_1=1e_3 e_1=e_3 e_1$$]Así que, el nuevo espacio vectorial [$\Lambda(V)$] donde opera el producto geométrico tendrá la siguiente base.[$$\{1,e_1,e_2,e_3,e_1 e_2,e_1 e_3,e_2 e_3,e_1 e_2 e_3 \}$$] Por ejemplo: El valor [$5+4e_1-7e_1 e_3$] es un vector de este espacio. Sus coeficientes en la base de arriba serían [$(5,4,0,0,0,-7,0,0)$].
Notaremos los elementos de [$\Lambda(V)$] con letras mayúsculas [$A,B,C$] mientras que continuamos usando las minúsculas [$a,b,c$] para los elementos de [$V$] y las griegas [$\alpha, \beta, \gamma$] para los escalares.
El producto geométrico es cerrado sobre el espacio [$\Lambda(V)$] que, a su vez, contiene el espacio [$V$] como subespacio vectorial con su base [$\{e_1,e_2,e_3 \}$]. La tabla que define el producto geométrico es la que sigue, aunque no es más que lo que hemos visto hasta ahora ampliado a la base completa.
| [$1$] | [$e_1$] | [$e_2$] | [$e_3$] | [$e_1 e_2$] | [$e_1 e_3$] | [$e_2 e_3$] | [$e_1 e_2 e_3$] | |
|---|---|---|---|---|---|---|---|---|
| [$1$] | [$1$] | [$e_1$] | [$e_2$] | [$e_3$] | [$e_1 e_2$] | [$e_1 e_3$] | [$e_2 e_3$] | [$e_1 e_2 e_3$] |
| [$e_1$] | [$e_1$] | [$1$] | [$e_1 e_2$] | [$e_1 e_3$] | [$e_2$] | [$e_3$] | [$e_1 e_2 e_3$] | [$e_2 e_3$] |
| [$e_2$] | [$e_2$] | [$-e_1 e_2$] | [$1$] | [$e_2 e_3$] | [$-e_1$] | [$-e_1 e_2 e_3$] | [$e_3$] | [$-e_1 e_3$] |
| [$e_3$] | [$e_3$] | [$-e_1 e_3$] | [$-e_2 e_3$] | [$1$] | [$e_1 e_2 e_3$] | [$-e_1$] | [$-e_2$] | [$e_1 e_2$] |
| [$e_1 e_2$] | [$e_1 e_2$] | [$-e_2$] | [$e_1$] | [$e_1 e_2 e_3$] | [$-1$] | [$-e_2 e_3$] | [$e_1 e_3$] | [$-e_3$] |
| [$e_1 e_3$] | [$e_1 e_3$] | [$-e_3$] | [$-e_1 e_2 e_3$] | [$e_1$] | [$e_2 e_3$] | [$-1$] | [$-e_1 e_2$] | [$e_2$] |
| [$e_2 e_3$] | [$e_2 e_3$] | [$e_1 e_2 e_3$] | [$-e_3$] | [$e_2$] | [$-e_1 e_3$] | [$e_1 e_2$] | [$-1$] | [$-e_1$] |
| [$e_1 e_2 e_3$] | [$e_1 e_2 e_3$] | [$e_2 e_3$] | [$-e_1 e_3$] | [$e_1 e_2$] | [$-e_3$] | [$e_2$] | [$-e_1$] | [$-1$] |
[$$(5+4e_1-7e_1 e_3 )(e_2+e_1 e_2 e_3 )=5e_2+5e_1 e_2 e_3+4e_1 e_2+4e_2 e_3+7e_1 e_2 e_3-7e_2=$$]
[$$=-2e_2+4e_1 e_2+4e_2 e_3+12e_1 e_2 e_3$$]
Curiosamente, el valor [$e_1 e_2 e_3$] cumple que [$(e_1 e_2 e_3 )^2=-1$]. Por similitud con la unidad imaginaria se nota con [$I=e_1 e_2 e_3$] y se le da el nombre de pseudoescalar. Si nos restringimos a vectores de [$\Lambda(V)$] de la forma [$\alpha+\beta I$], todo el cálculo complejo aparece en este subespacio.
Así que el producto geométrico no sólo aúna los productos escalares y vectoriales, sino que también los números complejos.
Sorpresas algebraicas
El producto geométrico de un vector [$a$] de [$V$] por sí mismo es un escalar, y además positivo. Obviamente, llamaremos esta multiplicación por sigo mismo, potenciar al cuadrado.[$$a^2=(\alpha_1 e_1+\alpha_2 e_2+\alpha_3 e_3 )(\alpha_1 e_1+\alpha_2 e_2+\alpha_3 e_3 )=\alpha_1^2+\alpha_2^2+\alpha_3^2$$] Eso significa que se puede definir la inversa de un vector respecto al producto geométrico. [$$a^{-1}=a/a^2$$] Se comprueba que, efectivamente, es una inversa. Basta con tener cuidado de saber que [$a^2$] es un escalar y por eso podemos calcular [$1/a^2$] en el cuerpo de [$V$].
Aunque todos los vectores no nulos de [$V$] tienen inversa, no todos los elementos del espacio completo [$\Lambda(V)$] tienen inversa. Por ejemplo, [$1+e_1$] no la tiene ya que es un divisor de cero [$(1+e_1 )(1-e_1 )=1-e_1+e_1-1=0$]. Si tuviera inversa llegaríamos a que [$1-e_1=0$] lo cual es contradictorio.
Un uso inmediato de la inversa de vectores es la obtención de la parte proporcional y la parte ortogonal de un vector respecto a otro.[$$b_\parallel=a^{-1} ab_\parallel=a^{-1} (ab+ba)/2$$][$$b_\bot=a^{-1} ab_\bot=a^{-1} (ab-ba)/2$$]Podemos seguir potenciando vectores [$a^k=aa^(k-1)$]. Sin embargo, nos encontramos con una propiedad muy interesante cuando potenciamos cualquier elemento de la base de [$\Lambda(V)$].
| [$E=$] | [$1$] | [$e_1$] | [$e_2$] | [$e_3$] | [$e_1 e_2$] | [$e_1 e_3$] | [$e_2 e_3$] | [$e_1 e_2 e_3$] |
|---|---|---|---|---|---|---|---|---|
| [$E^0=$] | [$1$] | [$1$] | [$1$] | [$1$] | [$1$] | [$1$] | [$1$] | [$1$] |
| [$E^1=$] | [$1$] | [$e_1$] | [$e_2$] | [$e_3$] | [$e_1 e_2$] | [$e_1 e_3$] | [$e_2 e_3$] | [$e_1 e_2 e_3$] |
| [$E^2=$] | [$1$] | [$1$] | [$1$] | [$1$] | [$-1$] | [$-1$] | [$-1$] | [$-1$] |
| [$E^3=$] | [$1$] | [$e_1$] | [$e_2$] | [$e_3$] | [$-e_1 e_2$] | [$-e_1 e_3$] | [$-e_2 e_3$] | [$-e_1 e_2 e_3$] |
| [$E^4=$] | [$1$] | [$1$] | [$1$] | [$1$] | [$1$] | [$1$] | [$1$] | [$1$] |
| [$E^5=$] | [$1$] | [$e_1$] | [$e_2$] | [$e_3$] | [$e_1 e_2$] | [$e_1 e_3$] | [$e_2 e_3$] | [$e_1 e_2 e_3$] |
| [$⋮$] | [$⋮$] | [$⋮$] | [$⋮$] | [$⋮$] | [$⋮$] | [$⋮$] | [$⋮$] | [$⋮$] |
Tener un producto geométrico cerrado en [$\Lambda(V)$] permite definir la exponencial en este espacio.[$$\exp(A)=\sum_i{\frac{A^i}{i!}}$$] Es fácil comprobar que [$\exp(a+b)=\exp(a)\exp(b)$]. Además, gracias a la involución de los vectores de la base de [$\Lambda(V)$] llegamos a las siguientes ecuaciones:[$$\exp(\alpha)=\cosh(\alpha )+1 \sinh(\alpha )=e^α$$][$$\exp(\alpha e_i )=\cosh(\alpha )+ e_i \sinh(\alpha )$$][$$\exp(\alpha e_i e_j )=\cos(\alpha )+e_i e_j \sin(\alpha )$$][$$\exp(\alpha I)=\cos(\alpha )+I \sin(\alpha )$$] Esta última expresión no es otra que la fórmula de Euler. Además, la penúltima expresión nos da a entender que los elementos de la forma [$\exp (\alpha e_i e_j )$] tienen algo que ver con las rotaciones.
Como ocurría con la potenciación, la exponenciación de elementos generales de [$\Lambda(V)$] no es inmediata y requiere bastantes cálculos. Sin embargo, para vectores [$$\exp \left(\sum_{i=1}^3{\alpha_i e_i}\right)=\prod_{i=1}^3{[\cosh (\alpha_i )+e_i \sinh (\alpha_i ) ]}$$]
Sorpresas geométricas
Probemos a usar [$\exp(\alpha e_1 e_2 )$] para intentar rotar un vector con la intuición que hemos ganado arriba. En el caso de [$\alpha=\pi/2$] la expresión de arriba nos dará [$$\exp \left(\frac{\pi}{2} e_1 e_2 \right)=e_1 e_2=R$$] Este valor [$R$] no rota de por sí un vector. Sin embargo, la expresión [$–RaR$] sí consigue lo que queríamos, aunque el ángulo de la rotación es el doble (debido a que hay dos [$R$]).
Por ejemplo, en el caso de querer rotar [$e_3$], si estamos rotando en el plano formado por [$e_1 e_2$], el resultado ha de ser invariante. Efectivamente:[$$-Re_3 R=-e_1 e_2 e_3 e_1 e_2=-e_1 e_2 e_1 e_2 e_3=e_3$$] Por otra parte, rotar un vector [$a$] en el plano [$e_1 e_2$] media vuelta debe ponerlo en la posición [$-a$].[$$-RaR=-e_1 e_2 (\alpha_1 e_1+\alpha_2 e_2 ) e_1 e_2=-(\alpha_1 e_1 e_2 e_1 e_1 e_2+\alpha_2 e_1 e_2 e_2 e_1 e_2 )=-a$$] Así que la expresión para rotar un ángulo [$\theta$] un vector [$a$] en el plano formado por los vectores ortonormales [$b$] y [$c$] es [$$ -\exp\left(\frac{\theta}{2}bc\right)a \exp\left(\frac{\theta}{2} bc\right)=-RaR$$]
Simple.
¿Qué ocurre si en vez de usar un valor [$R=bc$] usamos un [$R=b$]? Lo que obtenemos entonces es una reflexión. Es sencillo observar que si [$R=e_1$] entonces [$$R e_1 R=e_1,R e_2 R=-e_2,R e_3 R=-e_3$$][$$RaR=R(\alpha_1 e_1+\alpha_2 e_2+\alpha_3 e_3 )R=\alpha_1 e_1-\alpha_2 e_2-\alpha_3 e_3$$] Esto último no es más que la simetría en el eje de la dirección [$e_1$]. Se puede generalizar a cualquier vector unitario y, además, coincide con la idea intuitiva de que una rotación es equivalente a dos reflexiones.
Pensamientos finales
Quedan muchas más cosas por descubrir en el álgebra y el cálculo geométrico. Por ejemplo, se unifican los operadores diferenciales de gradiente, divergencia y rotacional a un único operador diferencial que los engloba. Sin embargo, este artículo ya está quedando largo y sólo me queda dirigir al lector a la Wikipedia y los libros que allí se referencian.
viernes, 28 de octubre de 2011
El combinador Y en C++ (y II)
La primera parte de esta serie está aquí.
Como se comentó en la primera parte, el combinador Y toma una función g que representa un paso de recursión y devuelve una función p que es el punto fijo de g. Esto del punto fijo no es más que la función recursiva obtenida aplicando g a sí misma infinitas veces. El problema con este planteamiento es que currificar en C++ es difícil. Por esta razón usaremos una versión de g que no esté currificada. El prototipo de esta función sería:
Y(g)=g(Y(g))
Como ahora tengo a g sin currificar, he de añadir un argumento extra. Queda así:
Y(g)=[](x){g(Y(g),x)}
Entonces, el código del combinador Y para los enteros sería
Realmente la parte difícil es la de los tipos, aunque se pueden obtener poco a poco estudiando la expresión.
Cambiar los int por un tipo genérico nos da el combinador Y genérico en C++:
Ahora sólo tenemos que usarlo. Definimos para eso la función g del factorial y lo volcamos a la salida. El código final es el que sigue:
En este punto sólo queda advertir al lector que es necesario usar un compilador compatible con el estándar de C++ de 2011.
Como se comentó en la primera parte, el combinador Y toma una función g que representa un paso de recursión y devuelve una función p que es el punto fijo de g. Esto del punto fijo no es más que la función recursiva obtenida aplicando g a sí misma infinitas veces. El problema con este planteamiento es que currificar en C++ es difícil. Por esta razón usaremos una versión de g que no esté currificada. El prototipo de esta función sería:
#include <functional>

int g(std::function<int(int)> f,int v);
El tipo de los objetos función en C++ es muy largo y escribir "std::function" cada vez va a emborronar el código. Usaré una macro para aligerar la notación.
#include <functional> //F(X,Y) es X->Y #define F(X,Y) std::function<Y(X)> //F(X,Y,Z) es (X,Y)->Z #define F2(X,Y,Z) std::function≶Z(X,Y)> int g(F(int,int) f,int v);Ahora vamos a tratar de definir el combinador Y. La mejor forma de hacerlo es, en vez de usar las funciones lambda de C++ que son muy tediosas, usando la ecuación recursiva que obtuvimos en la primera parte.
Y(g)=g(Y(g))
Como ahora tengo a g sin currificar, he de añadir un argumento extra. Queda así:
Y(g)=[](x){g(Y(g),x)}
Entonces, el código del combinador Y para los enteros sería
F(int,int) Y(  F2( F(int,int) ,int,int)  f)
{
    return [=](int x){return f(Y(f),x);};
}
Realmente la parte difícil es la de los tipos, aunque se pueden obtener poco a poco estudiando la expresión.
Cambiar los int por un tipo genérico nos da el combinador Y genérico en C++:
template<typename T>
F(T,T) Y(  F2( F(T,T) ,T,T)  f)
{
    return [=](T x){return f(Y(f),x);};
}
Ahora sólo tenemos que usarlo. Definimos para eso la función g del factorial y lo volcamos a la salida. El código final es el que sigue:
#include <functional>
#include <iostream>
//F(X,Y) es X->Y
#define F(X,Y) std::function<Y(X)>
//F(X,Y,Z) es (X,Y)->Z
#define F2(X,Y,Z) std::function≶Z(X,Y)>
int g(F(int,int) f,int v)
{
return v==0 ? 1 : v * f(v-1);
}
template<typename T>
F(T,T) Y( F2( F(T,T) ,T,T) f)
{
return [=](T x){return f(Y(f),x);};
}
int main(int argc,char** argv)
{
std::cout << Y<int>(g)(5) << std::endl;
return 0;
}En este punto sólo queda advertir al lector que es necesario usar un compilador compatible con el estándar de C++ de 2011.
miércoles, 21 de septiembre de 2011
La intuición tras la transformada de Laplace
Imaginemos que queremos hacer una derivada de una señal [$x(t)$].[$$\frac{d}{dt}x(t)$$] Las derivadas son operadores lineales. Eso quiere decir que si dividimos la señal en dos términos [$A_1 x_1(t)+A_2 x_2(t)$] tenemos [$$ \frac{d}{dt}x(t)= A_1 \frac{d}{dt}x_1(t) + A_2 \frac{d}{dt}x_2(t) $$] Ya que estamos, seamos astutos. Busquémonos unos términos que se deriven con facilidad. Por ejemplo, [$A e^{st}$]. Si estos fueran los términos, tendríamos [$$x(t)=A_1 e^{s_1t} + A_2 e^{s_2t}$$] y entonces [$$ \frac{d}{dt}x(t)= A_1 \frac{d}{dt}x_1(t) + A_2 \frac{d}{dt}x_2(t) = A_1 s_1 e^{s_1t} + A_2 s_2 e^{s_2t} $$]Mucho más fácil.
Todo esto está muy bien; pero es raro que una señal sea suma de dos exponenciales (bueno, quizás no sea tan raro). Una opción es hacer la suma infinita, lo cual abarca muchas más señales. Sin embargo, la opción buena, buena, buena es que sea una suma de densidades. Una integral. [$$ x(t)=\int_C{A(s)e^{st}ds}$$] El único truquillo es que la amplitud depende de la constante [$s$] que usemos en la exponencial. El contorno de integración [$C$] no nos interesa ahora. Cuando este contorno existe es que la señal puede representarse así. A veces, no existe. Es decir, que tampoco abarcamos todas las señales posibles, pero sí muchísimas. Todas las de interés.
¿Qué pasa cuando derivamos la señal [$x(t)$] descompuesta como una integral de exponenciales? La integral es lineal, la derivada también, la variable de derivación no está relacionada con la variable del diferencial... Todo esto nos permite mover la derivada bajo el signo de la integral. [$$ \frac{d}{dt}x(t)= \frac{d}{dt}\int_C{A(s)e^{st}ds} = \int_C{ \frac{d}{dt} A(s)e^{st}ds} $$] Y ya tenemos lo que queríamos, la derivada de una exponencial que es ella misma por la derivada de su exponente. [$$ \frac{d}{dt}x(t)= \int_C{A(s)\ s\ e^{st}ds} $$] Buscando la similitud con [$$ x(t)=\int_C{A(s)e^{st}ds}$$] es fácil ver que la derivada lo único que hace es multiplicar [$A(s)$] por [$s$]. ¡Mucho más fácil multiplicar que hacer la derivada!
Esa [$A(s)$] es casi la transformada de Laplace. Digo casi porque el contorno [$C$] introduce un factor de [$2\pi j$] que hay que compensar. Entonces, si llamo [$\mathcal{L}_{x(t)}(s)$] a la transformada de Laplace de [$x(t)$], tendré que [$$ x(t)=\frac{1}{2\pi j}\int_C{ \mathcal{L} _{x(t)}(s)e^{st}ds}$$] Concretamente la expresión de arriba es la transformada inversa de Laplace. La transformada directa es más sencilla. [$$ \mathcal{L}_{x(t)}(s)=\int_0^\infty{x(t)e^{-st}dt}$$]
Todo esto está muy bien; pero es raro que una señal sea suma de dos exponenciales (bueno, quizás no sea tan raro). Una opción es hacer la suma infinita, lo cual abarca muchas más señales. Sin embargo, la opción buena, buena, buena es que sea una suma de densidades. Una integral. [$$ x(t)=\int_C{A(s)e^{st}ds}$$] El único truquillo es que la amplitud depende de la constante [$s$] que usemos en la exponencial. El contorno de integración [$C$] no nos interesa ahora. Cuando este contorno existe es que la señal puede representarse así. A veces, no existe. Es decir, que tampoco abarcamos todas las señales posibles, pero sí muchísimas. Todas las de interés.
¿Qué pasa cuando derivamos la señal [$x(t)$] descompuesta como una integral de exponenciales? La integral es lineal, la derivada también, la variable de derivación no está relacionada con la variable del diferencial... Todo esto nos permite mover la derivada bajo el signo de la integral. [$$ \frac{d}{dt}x(t)= \frac{d}{dt}\int_C{A(s)e^{st}ds} = \int_C{ \frac{d}{dt} A(s)e^{st}ds} $$] Y ya tenemos lo que queríamos, la derivada de una exponencial que es ella misma por la derivada de su exponente. [$$ \frac{d}{dt}x(t)= \int_C{A(s)\ s\ e^{st}ds} $$] Buscando la similitud con [$$ x(t)=\int_C{A(s)e^{st}ds}$$] es fácil ver que la derivada lo único que hace es multiplicar [$A(s)$] por [$s$]. ¡Mucho más fácil multiplicar que hacer la derivada!
Esa [$A(s)$] es casi la transformada de Laplace. Digo casi porque el contorno [$C$] introduce un factor de [$2\pi j$] que hay que compensar. Entonces, si llamo [$\mathcal{L}_{x(t)}(s)$] a la transformada de Laplace de [$x(t)$], tendré que [$$ x(t)=\frac{1}{2\pi j}\int_C{ \mathcal{L} _{x(t)}(s)e^{st}ds}$$] Concretamente la expresión de arriba es la transformada inversa de Laplace. La transformada directa es más sencilla. [$$ \mathcal{L}_{x(t)}(s)=\int_0^\infty{x(t)e^{-st}dt}$$]
jueves, 25 de agosto de 2011
Lo que nunca me enseñaron: Los filtros de Cauer (y parte IV)
Partes anteriores: 1, 2 y 3.
Las funciones elípticas de Jacobi
Las funciones elípticas de Jacobi son una generalización de las funciones trigonométricas. Hay doce funciones elípticas de Jacobi, pero sólo vamos a usar una que se llama [$cd$] y está relacionada con el coseno. Si bien el argumento de las funciones trigonométricas son ángulos, el argumento de las funciones elípticas de Jacobi es un valor [$u$] que no tiene una relación inmediata ni con los ángulos, ni áreas ni longitudes de arco.
El valor [$k^'$] se llama el comódulo elíptico y se relaciona con la excentricidad de la elipse [$k$], también llamada el módulo elíptico, de la siguiente forma. [$$ k^2+(k^')^2=1$$] Dependiendo de la excentricidad de la elipse sobre la que trabajemos las funciones de Jacobi cambian por lo que es usual presentarlas con dos argumentos.[$$cd(u,k),\ \ \ \ sd(u,k),\ \ \ \ nd(u,k)$$] En concreto, la función [$cd(u,k)$] es muy parecida al coseno cuando se observa su inversa. [$$ arccd(u,k)=\int_u^1{\frac{dt}{\sqrt{1-t^2}\sqrt{1-k^2 t^2}}}$$] Investigaremos el recorrido que hace esta función cuando [$u$] se mueve desde [$0$] hasta infinito. Empieza en [$$ arccd(0,k)=\int_0^1{\frac{dt}{\sqrt{1-t^2} \sqrt{1-k^2 t^2}}}$$] Este valor es conocido como la integral elíptica completa de primera especie de módulo [$k$] y se escribe usualmente como [$K(k)$].
Conforme aumente [$u$] por los reales, decrecerá el [$arccd$] hasta que lleguemos a [$u=1$] donde los límites de la integral van a coincidir por lo que su valor será cero. Si hacemos el recorrido simétrico hacia los valores negativos, llegaremos a [$u=-1$] donde el valor de su [$arccd$] será [$2K(k)$].
A partir de este punto, seguir integrando significa que la raíz [$\sqrt{1-t^2}$] va a resultar en valores imaginarios. Nuestro recorrido pasará a moverse verticalmente por la gráfica hasta que [$u=\frac{1}{k}$]. A partir de este valor, la raíz [$\sqrt{1-k^2 t^2}$] también se hace imaginaria. El valor del [$arccd$] en [$u=\frac{1}{k}$] es fácilmente calculable mediante un cambio de variables. [$$ arccd \left(\frac{1}{k},k\right)=\int_{\frac{1}{k}}^1{\frac{dt}{\sqrt{1-t^2}\sqrt{1-k^2 t^2}}}=\int_0^1{\frac{dt}{\sqrt{t^2-1}\sqrt{1-(k^')^2 t^2}}}=jK(k^' )$$] Trazando estos segmentos verticales del recorrido obtenemos el siguiente diagrama.
Finalmente, continuamos a partir de [$\frac{1}{k}$]. Ahora las dos raíces tienen el radicando negativo y son por tantos imaginarias, como [$j^2=-1$] el sentido de nuestro recorrido ha de ser opuesto al que inicialmente tenía. En el límite hacia el infinito será: [$$arccd(\infty,k)\rightarrow \int_\infty^1{\frac{dt}{\sqrt{1-t^2}\sqrt{1-k^2 t^2}}}=K(k)+jK(k^' )$$] Así que terminamos el recorrido de la siguiente manera.
Sabiendo que al seguir este recorrido sobre la función [$cd(u,k)$] debemos obtener la función identidad, ganamos perspectiva de cómo es la función [$cd(u,k)$].
Secciones de cd
Su diagrama de polos y ceros se presenta a continuación y observamos que tiene dos periodos. El usual de [$4K(k)$] que se correspondería con el [$2\pi$] de las funciones trigonométricas y otro imaginario de [$2iK(k^' )$] que aparece por esa segunda raíz cuadrada en la integral. La zona sombreada es la que se repite periódicamente tanto horizontal como verticalmente.
Como hicimos con la función coseno, vamos a ver cómo es la función [$cd(u,k)$] en las tres secciones del recorrido de [$arccd(u,k)$]. Recordemos que en estas rectas la función [$cd(u,k)$] es real.
Para la rama negativa tenemos que [$$ cd(u+2K(k),k)=-cd(u,k)$$] Además, existe una propiedad de simetría entre [$cd(t,k)$] y [$cd(t+jK(k^' ),k)$] que usaremos más adelante. [$$cd(u+jK^' (k),k)=\frac{1}{k\ cd(u,k)}$$] En la DLMF podemos ver en 3D la función [$cd$] con sus polos bien distinguidos.
http://dlmf.nist.gov/22.3.F19.mag
La función racional elíptica
El lector astuto ya habrá imaginado que lo siguiente que vamos a hacer es [$$cd(n\ arccd(u ,k),k)$$] Como hicimos con los polinomios de Chebyshev, el recorrido del [$arccd$] queda ampliado [$n$] veces. Siguiéndolo, nos haremos una idea de cómo es esta función. Como antes, sólo seguiremos los valores positivos ya que los negativos son simétricos.
El resultado es una oscilación entre +1 y -1 en el primer segmento, otra oscilación entre 1 y 1/k en el segundo segmento y otra oscilación entre 1/k e infinito (cambiando de signo en cada infinito) en el tercer segmento.
Esta función no nos sirve como función [$F^2 (\omega)$] porque tendría oscilaciones en la banda de paso.
Afortunadamente tenemos dos [$k$] a nuestra disposición, la del [$arccd$] que llamaremos [$k_a$] y la del [$cd$] que llamaremos [$k_c$]. Entonces, se define la función racional elíptica de la siguiente forma:[$$R_n (u,k_a,k_c )=cd\left(n\ \frac{K(k_c )}{K(k_a )} arccd(u ,k_a ),k_c \right)$$] La aparición del cociente [$\frac{K(k_c )}{K(k_a )}$] es necesaria para convertir el periodo real del [$arccd$] en el periodo real del [$cd$] que ahora son distintos al tener módulos distintos. Bueno, exactamente [$n$] veces ese periodo.
Por otra parte, ese n no lo queremos en el periodo imaginario. Querríamos tener [$$ R_n (u,k_a,k_c )=cd\left(\frac{K(k_c^' )}{K(k_a^' )} arccd(u ,k_a ),k_c \right)$$] ¡Y podemos tener ambas condiciones si elegimos con cuidado! [$$ n=\frac{K(k_a )K(k_c^' )}{K(k_a^' )K(k_c )} $$] De esta forma el recorrido queda multiplicado sólo en la dirección horizontal.
La gráfica de esta función es como sigue. En ella aparece tanto la [$k_a$] como la [$k_c$] explícitamente.
Como ocurría con los polinomios de Chebyshev, esta función es real, aunque esta vez no puede expresarse como un polinomio ya que tiene polos (los infinitos). Debe expresarse como un cociente entre polinomios, de ahí que se llame función racional elíptica.
El filtro de Cauer
El filtro de Cauer o filtro elíptico es el que toma esa función racional elíptica como [$F(\omega)$]. La gráfica de su cuadrado es la que sigue.
Ajustando para que se cumplan los requisitos de un filtro tenemos que [$$ F^2 (\omega)=\epsilon_p^2 R_n^2 \left(\frac{\omega}{\omega_p} ,\frac{\omega_p}{\omega_s} ,\epsilon_p \epsilon_s \right)$$] Donde hemos usado [$$k_a=\frac{\omega_p}{\omega_s}$$][$$ k_c=\epsilon_p \epsilon_s$$]
Así que un filtro de Cauer de orden [$n$] tiene la siguiente respuesta en frecuencia al cuadrado. [$$ |H(j\omega) |^2=\frac{1}{1+\epsilon_p^2 R_n^2 \left( \frac{\omega}{\omega_p} ,\frac{\omega_p}{\omega_s} ,\epsilon_p \epsilon_s \right)}$$] Realmente, su banda de transición es mucho más pequeña que lo trazado en las gráficas anteriores. La siguiente gráfica muestra la respuesta en frecuencia bien escalada.
Además, la condición de la no oscilación en la banda base y ajuste de periodos es precisamente la cota del orden del filtro. [$$ n\ge \frac{K(\frac{\omega_p}{\omega_s}) K^' (\epsilon_p \epsilon_s )}{K^' ( \frac{\omega_p}{\omega_s} )K( \epsilon_p \epsilon_s )}$$] Donde [$K^' (k)=K(k^' )$].
Ojo: una vez hallado [$n$] con la desigualdad, hemos de modificar algún requisito para que se cumpla la igualdad. Debemos tener la igualdad si no queremos oscilaciones en la banda de transición.
La búsqueda de la función de transferencia
Para obtener la función de transferencia necesitamos conocer los polos y los ceros de la misma. Ambos son sencillos de calcular. Hagamos el cambio [$\omega=-js$] y empecemos por los ceros de la función de transferencia. Ocurrirán cuando [$R_n^2$] tienda a infinito. Es decir, en los polos de [$R_n^2$]. [$$R_n^2 \left(\frac{-js_{cero}}{\omega_p} ,\frac{\omega_p}{\omega_s} ,\epsilon_p \epsilon_s \right)=\infty$$] [$$n \frac{K(\epsilon_p \epsilon_s )}{K(\frac{\omega_p}{\omega_s} )} arccd\left(\frac{-js_{cero}}{\omega_p} ,\frac{\omega_p}{\omega_s} \right)=arccd(\infty,\epsilon_p \epsilon_s )$$]
El miembro de la derecha es la localización de los polos de [$cd$]. Recordemos que hay dos periodos y, por la dirección del recorrido del [$arccd$] en la zona de los ceros, nos interesa el periodo real.[$$n \frac{K(\epsilon_p \epsilon_s )}{K(\frac{\omega_p}{\omega_s})} arccd\left(\frac{-js_{cero\ m}}{\omega_p} ,\frac{\omega_p}{\omega_s}\right)=(2m+1)K(\epsilon_p \epsilon_s )+jK^' (\epsilon_p \epsilon_s )$$]
Despejando llegamos a la expresión siguiente. [$$ s_{cero\ m}=j\omega_p cd\left(\frac{2m+1}{n} K\left(\frac{\omega_p}{\omega_s}\right)+jK^' \left(\frac{\omega_p}{\omega_s}\right),\frac{\omega_p}{\omega_s} \right)$$]Por la propiedad de simetría, se simplifica aún más. [$$ s_{cero\ m}=\frac{j \omega_s}{cd\left(\frac{2m+1}{n} K(\frac{\omega_p}{\omega_s}),\frac{\omega_p}{\omega_s} \right)}$$]
Para los ceros con los que nos quedamos en H(s), el valor de [$m$] se debe mover entre [$0$] y [$n-1$]. En algunos casos el cero aparecerá en el infinito. Eso significa que no debemos tenerlo en cuenta.
Para los polos hay que igualar [$\epsilon_p^2 R_n^2$] a menos uno. [$$ \epsilon_p^2 R_n^2 \left(\frac{\omega_{polo}}{\omega_p} , \frac{\omega_p}{\omega_s} ,\epsilon_p \epsilon_s \right)=-1$$][$$ R_n \left( \frac{\omega_{polo}}{\omega_p} , \frac{\omega_p}{\omega_s} ,\epsilon_p \epsilon_s \right) =\frac{j}{\epsilon_p}$$] Obtenemos una expresión similar a la que teníamos para los ceros. [$$ cd\left(n\ \frac{K(\epsilon_p \epsilon_s )}{K(\frac{\omega_p}{\omega_s})} arccd \left(\frac{-js_{polo}}{\omega_p} ,\frac{\omega_p}{\omega_s} \right),\epsilon_p \epsilon_s \right)=\frac{j}{\epsilon_p}$$]De nuevo elegimos el periodo real.[$$ n \frac{K(\epsilon_p \epsilon_s )}{K(\frac{\omega_p}{\omega_s})} arccd \left(\frac{-js_{polo\ m}}{\omega_p} ,\frac{\omega_p}{\omega_s}\right)=arccd\left(\frac{j}{\epsilon_p} ,\epsilon_p \epsilon_s \right)+2mK(\epsilon_p \epsilon_s )$$]Y despejamos[$$s_{polo\ m}=j \omega_p cd\left(\frac{K(\frac{\omega_p}{\omega_s})}{n\ K(\epsilon_p \epsilon_s ) } \left[arccd\left(\frac{j}{\epsilon_p} ,\epsilon_p \epsilon_s \right)+2mK(\epsilon_p \epsilon_s ) \right] ,\frac{\omega_p}{\omega_s}\right )$$]
Así podemos construir la magnitud de la función de transferencia al cuadrado a falta de la constante multiplicativa. [$$ |H(s) |^2=A^2 \frac{\prod{(s-s_{cero\ m})}}{\prod{(s-s_{polo\ m})}}$$] La constante se halla haciendo [$s=0$] en la expresión de [$|H(s) |^2$] basada en [$R_n^2$] e igualándola con la de arriba. [$$ |H(0) |^2=A^2 \frac{\prod{(0-s_{cero\ m})}}{\prod{(0-s_{polo\ m})}}=\frac{1}{1+\epsilon_p^2 R_n^2 (0,\frac{\omega_p}{\omega_s} ,\epsilon_p \epsilon_s ) }$$] Finalmente, se toman los polos con parte real menor que cero para conseguir que pueda ser realizado en la práctica.
Epílogo
Si el lector compara, para un mismo conjunto de especificaciones, los órdenes que se requieren de los filtros, verá que el filtro de Cauer mejora los otros dos tipos de filtros.
Debido a que el orden del filtro está relacionado con el número de componentes que se necesitan para hacer un circuito eléctrico del filtro, es inmediato llegar a la conclusión de que los filtros de Cauer son más económicos.
Esa es la razón por la que Cauer conseguía un filtro con las mismas prestaciones, pero con una bobina menos.
Las funciones elípticas de Jacobi
Las funciones elípticas de Jacobi son una generalización de las funciones trigonométricas. Hay doce funciones elípticas de Jacobi, pero sólo vamos a usar una que se llama [$cd$] y está relacionada con el coseno. Si bien el argumento de las funciones trigonométricas son ángulos, el argumento de las funciones elípticas de Jacobi es un valor [$u$] que no tiene una relación inmediata ni con los ángulos, ni áreas ni longitudes de arco.
 |
| Trigonometría en la elipse usando las funciones elípticas de Jacobi [$sd$], [$nd$] y [$cd$]. Hay más funciones elípticas de Jacobi, pero sólo nos será de utilidad la [$cd$]. |
El valor [$k^'$] se llama el comódulo elíptico y se relaciona con la excentricidad de la elipse [$k$], también llamada el módulo elíptico, de la siguiente forma. [$$ k^2+(k^')^2=1$$] Dependiendo de la excentricidad de la elipse sobre la que trabajemos las funciones de Jacobi cambian por lo que es usual presentarlas con dos argumentos.[$$cd(u,k),\ \ \ \ sd(u,k),\ \ \ \ nd(u,k)$$] En concreto, la función [$cd(u,k)$] es muy parecida al coseno cuando se observa su inversa. [$$ arccd(u,k)=\int_u^1{\frac{dt}{\sqrt{1-t^2}\sqrt{1-k^2 t^2}}}$$] Investigaremos el recorrido que hace esta función cuando [$u$] se mueve desde [$0$] hasta infinito. Empieza en [$$ arccd(0,k)=\int_0^1{\frac{dt}{\sqrt{1-t^2} \sqrt{1-k^2 t^2}}}$$] Este valor es conocido como la integral elíptica completa de primera especie de módulo [$k$] y se escribe usualmente como [$K(k)$].
 |
| Diagrama representando el valor real resultado de la integral completa de primera especie que es el valor del [$arccd$] de cero. |
Conforme aumente [$u$] por los reales, decrecerá el [$arccd$] hasta que lleguemos a [$u=1$] donde los límites de la integral van a coincidir por lo que su valor será cero. Si hacemos el recorrido simétrico hacia los valores negativos, llegaremos a [$u=-1$] donde el valor de su [$arccd$] será [$2K(k)$].
 |
| Recorrido del valor de [$arccd$] con argumentos desde cero hasta uno (y simétrico por los negativos). |
A partir de este punto, seguir integrando significa que la raíz [$\sqrt{1-t^2}$] va a resultar en valores imaginarios. Nuestro recorrido pasará a moverse verticalmente por la gráfica hasta que [$u=\frac{1}{k}$]. A partir de este valor, la raíz [$\sqrt{1-k^2 t^2}$] también se hace imaginaria. El valor del [$arccd$] en [$u=\frac{1}{k}$] es fácilmente calculable mediante un cambio de variables. [$$ arccd \left(\frac{1}{k},k\right)=\int_{\frac{1}{k}}^1{\frac{dt}{\sqrt{1-t^2}\sqrt{1-k^2 t^2}}}=\int_0^1{\frac{dt}{\sqrt{t^2-1}\sqrt{1-(k^')^2 t^2}}}=jK(k^' )$$] Trazando estos segmentos verticales del recorrido obtenemos el siguiente diagrama.
 |
| Recorrido del valor de [$arccd$] con argumentos desde cero hasta [$\frac{1}{k}$] (y simétrico por los negativos) |
 |
| Recorrido completo del valor de [$arccd$] con argumentos reales. |
Sabiendo que al seguir este recorrido sobre la función [$cd(u,k)$] debemos obtener la función identidad, ganamos perspectiva de cómo es la función [$cd(u,k)$].
Secciones de cd
Su diagrama de polos y ceros se presenta a continuación y observamos que tiene dos periodos. El usual de [$4K(k)$] que se correspondería con el [$2\pi$] de las funciones trigonométricas y otro imaginario de [$2iK(k^' )$] que aparece por esa segunda raíz cuadrada en la integral. La zona sombreada es la que se repite periódicamente tanto horizontal como verticalmente.
 |
| Diagrama de polos, ceros y valores destacados de [$cd$]. |
Como hicimos con la función coseno, vamos a ver cómo es la función [$cd(u,k)$] en las tres secciones del recorrido de [$arccd(u,k)$]. Recordemos que en estas rectas la función [$cd(u,k)$] es real.
 |
| Tres secciones de la función [$cd$] por las rectas que va a seguir su [$arccd$]. En estas rectas el valor de [$cd$] es real y se representa a su derecha. |
Para la rama negativa tenemos que [$$ cd(u+2K(k),k)=-cd(u,k)$$] Además, existe una propiedad de simetría entre [$cd(t,k)$] y [$cd(t+jK(k^' ),k)$] que usaremos más adelante. [$$cd(u+jK^' (k),k)=\frac{1}{k\ cd(u,k)}$$] En la DLMF podemos ver en 3D la función [$cd$] con sus polos bien distinguidos.
http://dlmf.nist.gov/22.3.F19.mag
La función racional elíptica
El lector astuto ya habrá imaginado que lo siguiente que vamos a hacer es [$$cd(n\ arccd(u ,k),k)$$] Como hicimos con los polinomios de Chebyshev, el recorrido del [$arccd$] queda ampliado [$n$] veces. Siguiéndolo, nos haremos una idea de cómo es esta función. Como antes, sólo seguiremos los valores positivos ya que los negativos son simétricos.
 |
| Recorrido de [$arccd$] ampliado tres veces sobre el diagrama de polos y ceros de [$cd$]. |
El resultado es una oscilación entre +1 y -1 en el primer segmento, otra oscilación entre 1 y 1/k en el segundo segmento y otra oscilación entre 1/k e infinito (cambiando de signo en cada infinito) en el tercer segmento.
 |
| Gráfica de la función [$cd(3\ arccd(x, k), k)$] con cada uno de los tramos coloreados. |
Esta función no nos sirve como función [$F^2 (\omega)$] porque tendría oscilaciones en la banda de paso.
 |
| La función anterior al cuadrado como intento de aproximación a [$F^2(\omega)$]. La banda de transición es muy ancha y tiene oscilaciones. |
Afortunadamente tenemos dos [$k$] a nuestra disposición, la del [$arccd$] que llamaremos [$k_a$] y la del [$cd$] que llamaremos [$k_c$]. Entonces, se define la función racional elíptica de la siguiente forma:[$$R_n (u,k_a,k_c )=cd\left(n\ \frac{K(k_c )}{K(k_a )} arccd(u ,k_a ),k_c \right)$$] La aparición del cociente [$\frac{K(k_c )}{K(k_a )}$] es necesaria para convertir el periodo real del [$arccd$] en el periodo real del [$cd$] que ahora son distintos al tener módulos distintos. Bueno, exactamente [$n$] veces ese periodo.
Por otra parte, ese n no lo queremos en el periodo imaginario. Querríamos tener [$$ R_n (u,k_a,k_c )=cd\left(\frac{K(k_c^' )}{K(k_a^' )} arccd(u ,k_a ),k_c \right)$$] ¡Y podemos tener ambas condiciones si elegimos con cuidado! [$$ n=\frac{K(k_a )K(k_c^' )}{K(k_a^' )K(k_c )} $$] De esta forma el recorrido queda multiplicado sólo en la dirección horizontal.
 |
| El recorrido que tomamos en la función elíptica racional con unos parámetros adecuados para que sólo se mueva medio periodo imaginario. |
La gráfica de esta función es como sigue. En ella aparece tanto la [$k_a$] como la [$k_c$] explícitamente.
 |
| Gráfica de la función elíptica racional con módulos [$k_a$] y [$k_c$] (y la [$n$] adecuada según se comentó arriba). |
Como ocurría con los polinomios de Chebyshev, esta función es real, aunque esta vez no puede expresarse como un polinomio ya que tiene polos (los infinitos). Debe expresarse como un cociente entre polinomios, de ahí que se llame función racional elíptica.
El filtro de Cauer
El filtro de Cauer o filtro elíptico es el que toma esa función racional elíptica como [$F(\omega)$]. La gráfica de su cuadrado es la que sigue.
 |
| La función racional elíptica como función [$F(\omega)$] de un filtro. |
Ajustando para que se cumplan los requisitos de un filtro tenemos que [$$ F^2 (\omega)=\epsilon_p^2 R_n^2 \left(\frac{\omega}{\omega_p} ,\frac{\omega_p}{\omega_s} ,\epsilon_p \epsilon_s \right)$$] Donde hemos usado [$$k_a=\frac{\omega_p}{\omega_s}$$][$$ k_c=\epsilon_p \epsilon_s$$]
 |
| La función racional elíptica como función [$F(\omega)$] de un filtro con los parámetros ajustados a las especificaciones del filtro. |
 |
| Respuesta en frecuencia de un filtro de Cauer |
Además, la condición de la no oscilación en la banda base y ajuste de periodos es precisamente la cota del orden del filtro. [$$ n\ge \frac{K(\frac{\omega_p}{\omega_s}) K^' (\epsilon_p \epsilon_s )}{K^' ( \frac{\omega_p}{\omega_s} )K( \epsilon_p \epsilon_s )}$$] Donde [$K^' (k)=K(k^' )$].
Ojo: una vez hallado [$n$] con la desigualdad, hemos de modificar algún requisito para que se cumpla la igualdad. Debemos tener la igualdad si no queremos oscilaciones en la banda de transición.
La búsqueda de la función de transferencia
Para obtener la función de transferencia necesitamos conocer los polos y los ceros de la misma. Ambos son sencillos de calcular. Hagamos el cambio [$\omega=-js$] y empecemos por los ceros de la función de transferencia. Ocurrirán cuando [$R_n^2$] tienda a infinito. Es decir, en los polos de [$R_n^2$]. [$$R_n^2 \left(\frac{-js_{cero}}{\omega_p} ,\frac{\omega_p}{\omega_s} ,\epsilon_p \epsilon_s \right)=\infty$$] [$$n \frac{K(\epsilon_p \epsilon_s )}{K(\frac{\omega_p}{\omega_s} )} arccd\left(\frac{-js_{cero}}{\omega_p} ,\frac{\omega_p}{\omega_s} \right)=arccd(\infty,\epsilon_p \epsilon_s )$$]
El miembro de la derecha es la localización de los polos de [$cd$]. Recordemos que hay dos periodos y, por la dirección del recorrido del [$arccd$] en la zona de los ceros, nos interesa el periodo real.[$$n \frac{K(\epsilon_p \epsilon_s )}{K(\frac{\omega_p}{\omega_s})} arccd\left(\frac{-js_{cero\ m}}{\omega_p} ,\frac{\omega_p}{\omega_s}\right)=(2m+1)K(\epsilon_p \epsilon_s )+jK^' (\epsilon_p \epsilon_s )$$]
Despejando llegamos a la expresión siguiente. [$$ s_{cero\ m}=j\omega_p cd\left(\frac{2m+1}{n} K\left(\frac{\omega_p}{\omega_s}\right)+jK^' \left(\frac{\omega_p}{\omega_s}\right),\frac{\omega_p}{\omega_s} \right)$$]Por la propiedad de simetría, se simplifica aún más. [$$ s_{cero\ m}=\frac{j \omega_s}{cd\left(\frac{2m+1}{n} K(\frac{\omega_p}{\omega_s}),\frac{\omega_p}{\omega_s} \right)}$$]
Para los ceros con los que nos quedamos en H(s), el valor de [$m$] se debe mover entre [$0$] y [$n-1$]. En algunos casos el cero aparecerá en el infinito. Eso significa que no debemos tenerlo en cuenta.
Para los polos hay que igualar [$\epsilon_p^2 R_n^2$] a menos uno. [$$ \epsilon_p^2 R_n^2 \left(\frac{\omega_{polo}}{\omega_p} , \frac{\omega_p}{\omega_s} ,\epsilon_p \epsilon_s \right)=-1$$][$$ R_n \left( \frac{\omega_{polo}}{\omega_p} , \frac{\omega_p}{\omega_s} ,\epsilon_p \epsilon_s \right) =\frac{j}{\epsilon_p}$$] Obtenemos una expresión similar a la que teníamos para los ceros. [$$ cd\left(n\ \frac{K(\epsilon_p \epsilon_s )}{K(\frac{\omega_p}{\omega_s})} arccd \left(\frac{-js_{polo}}{\omega_p} ,\frac{\omega_p}{\omega_s} \right),\epsilon_p \epsilon_s \right)=\frac{j}{\epsilon_p}$$]De nuevo elegimos el periodo real.[$$ n \frac{K(\epsilon_p \epsilon_s )}{K(\frac{\omega_p}{\omega_s})} arccd \left(\frac{-js_{polo\ m}}{\omega_p} ,\frac{\omega_p}{\omega_s}\right)=arccd\left(\frac{j}{\epsilon_p} ,\epsilon_p \epsilon_s \right)+2mK(\epsilon_p \epsilon_s )$$]Y despejamos[$$s_{polo\ m}=j \omega_p cd\left(\frac{K(\frac{\omega_p}{\omega_s})}{n\ K(\epsilon_p \epsilon_s ) } \left[arccd\left(\frac{j}{\epsilon_p} ,\epsilon_p \epsilon_s \right)+2mK(\epsilon_p \epsilon_s ) \right] ,\frac{\omega_p}{\omega_s}\right )$$]
Así podemos construir la magnitud de la función de transferencia al cuadrado a falta de la constante multiplicativa. [$$ |H(s) |^2=A^2 \frac{\prod{(s-s_{cero\ m})}}{\prod{(s-s_{polo\ m})}}$$] La constante se halla haciendo [$s=0$] en la expresión de [$|H(s) |^2$] basada en [$R_n^2$] e igualándola con la de arriba. [$$ |H(0) |^2=A^2 \frac{\prod{(0-s_{cero\ m})}}{\prod{(0-s_{polo\ m})}}=\frac{1}{1+\epsilon_p^2 R_n^2 (0,\frac{\omega_p}{\omega_s} ,\epsilon_p \epsilon_s ) }$$] Finalmente, se toman los polos con parte real menor que cero para conseguir que pueda ser realizado en la práctica.
Epílogo
Si el lector compara, para un mismo conjunto de especificaciones, los órdenes que se requieren de los filtros, verá que el filtro de Cauer mejora los otros dos tipos de filtros.
Debido a que el orden del filtro está relacionado con el número de componentes que se necesitan para hacer un circuito eléctrico del filtro, es inmediato llegar a la conclusión de que los filtros de Cauer son más económicos.
Esa es la razón por la que Cauer conseguía un filtro con las mismas prestaciones, pero con una bobina menos.
lunes, 22 de agosto de 2011
Lo que nunca me enseñaron: Los filtros de Cauer (parte III)
La primera parte está aquí y la segunda parte aquí.
Los viajes del arcocoseno
Hasta aquí todo lo visto ha sido para entender el proceso de realización de un filtro. A partir de aquí empezamos a acercarnos a los filtros elípticos. Sin embargo, antes debemos pararnos a explorar los filtros de Chebyshev. Los filtros de Chebyshev son más simples porque usan para su expresión matemática la circunferencia en vez de la elipse. Deberían llamarse filtros circulares, pero ya se ha quedado el nombre de Chebyshev.
Lo primero que necesitamos para entender los filtros de Chebyshev es la definición de arcocoseno. [$$arccos(x)=\int_x^1{\frac{dt}{\sqrt{1-t^2}}}$$] Esta integral no es más que la longitud de arco de una circunferencia unitaria desde una abscisa [$x$]. (Nota: Por supuesto, es una función multivaluada. Tomaremos sólo la rama de la raíz principal aquí).
Lo sorprendente es que esta integral, el arcocoseno, tiene sentido cuando [$x$] va más allá de [$\pm 1$]. Eso sí, hemos de usar números complejos porque el radicando que aparece en la raíz se hace negativo.
Dibujaremos el valor que toma el arcocoseno en el plano de Argand conforme [$x$] tome valores reales. Empezaremos por el arcocoseno de cero que es [$\pi/2$].
Si vamos aumentando [$x$], llegamos hasta [$arccos(1)=0$] obteniendo únicamente números reales. Es el arcocoseno clásico. Igualmente, si disminuimos [$x$], llegamos hasta [$arccos(-1)=\pi$]. Esta simetría continuará por lo que no hablaremos más de los valores negativos de [$x$].
En el punto [$arccos(1)=0$] ocurre que la raíz del integrando se anula. [$$\sqrt{1-t^2 }=0$$] Si seguimos moviendo [$x$] por la recta real, el arcocoseno entrará en el eje imaginario. A partir de aquí tenemos otras dos ramas, la raíz positiva y la negativa. Elegimos la positiva y recordamos para luego que hay simetrías.
Las olas del coseno
En los complejos, el coseno es una función holomorfa. Una de sus particularidades es la periodicidad en el eje real. Si trazamos su diagrama de ceros (no tiene polos) y añadimos algunos puntos destacados en la línea real obtenemos lo siguiente.
Si recorremos el plano de Argand por la línea real [$x=\sigma$], obtenemos la función coseno clásica. El lado más oscuro corresponde a los valores negativos.
Si recorremos el coseno por la recta imaginaria obtenemos el coseno hiperbólico. Es importante darse cuenta que por estos dos recorridos el coseno siempre proporciona un valor real.
Como era de esperar, al ser el arcocoseno la función inversa del coseno, si hacemos el recorrido del arcocoseno desde 0 hasta infinito, vamos visitando los argumentos cuyo coseno se mueve desde 0 hasta infinito.
Los polinomios de Chebyshev
Los polinomios de Chebyshev se definen así: [$$C_n (x)=cos(n\ arccos(x) )$$] Para ver cómo son, observemos el recorrido de [$n\ arccos(x)$] sobre la función coseno. Es muy sencillo porque lo único que hacemos al multiplicar por [$n$] es ampliar fotográficamente [$n$] veces el recorrido del arcocoseno. En el siguiente diagrama usamos [$n=3$].
Ampliar tres veces el recorrido no cambia mucho el valor del coseno por la recta imaginaria. Lo hace más abrupto porque nos movemos más rápidamente hacia el infinito. En donde sí que hay un cambio es en la parte real donde tenemos tres cuartos de pi en vez de uno. Esto hace que se oscile en esa parte.
Recordemos que en estas rectas todos los valores del coseno son reales y que hay otra parte simétrica cuando [$t\lt 0$]. Con esto en mente podemos dibujar [$C_3$].
Observando con cuidado el recorrido de arriba, vemos que atraviesa exactamente 3 ceros del coseno: el [$\pi/2$] y su simétrico en [$5 \pi/2$] y el [$3 \pi/2$] que es su propio simétrico. Además, no es casual que los puntos donde [$x=\pm 1$] tome el valor [$y= \pm 1$] ya que son los puntos de arcocoseno nulo.
Una manera fácil de calcular los polinomios de Chebyshev es la siguiente. [$$C_{n+1} (x)=cos(n\ arccos(x)+arccos(x) )=x C_n (x)+sin(n\ arccos(x) ) sin(arccos (x) )$$][$$ C_{n-1}(x)=cos(n\ arccos(x)-arccos(x) )=x C_n (x)-sin(n\ arccos(x) ) sin(arccos(x) )$$] Sumando se llega a [$C_{n+1} (x)+C_{n-1} (x)=2 x C_n (x)$] y despejando [$C_{n+1} (x)$] se obtiene la siguiente fórmula recursiva. [$$C_{n+1} (x)=2 C_n (x) - C_{n-1} (x)$$] Usando la definición se obtiene que [$C_0 (x)=1$] y [$C_1 (x)=x$] con lo que tenemos todos los datos para calcular el polinomio de Chebyshev del orden que queramos.
El filtro de Chebyshev
La función [$C_n^2 (\omega)$] es una buena aproximación de [$F^2 (\omega)$]. Dibujemos su gráfica para n=3.
Para que cumpla los requisitos de un filtro hay que ajustarla un poco. [$$ F^2 (\omega)=\epsilon_p^2 C_n^2 \left(\frac{\omega}{\omega_p} \right)$$]
Así que un filtro de Chebyshev es el que tiene la siguiente respuesta en frecuencia al cuadrado. [$$ |H(j\omega) |^2=\frac{1}{1+\epsilon_p^2 C_n^2 \left(\frac{\omega}{\omega_p} \right)}$$] A partir de aquí procedemos como en el filtro de Butterworth. Calculamos [$\epsilon_s$], despejamos [$n$] para el orden; calculamos los polos de [$|H(s) |^2$] (este filtro no tiene ceros) y separamos los polos para obtener [$H(s)$].
Todo esto lo dejaremos para el lector que observará, entre otras cosas, que el orden requerido es menor en un filtro de Chebyshev que en un filtro de Butterworth para los mismos requisitos.
El lector curioso queda emplazado para explorar los filtros inversos de Chebyshev e intentar usar la misma técnica de inversión para los filtros de Butterworth.
Continúa y acaba en la cuarta parte.
Los viajes del arcocoseno
Hasta aquí todo lo visto ha sido para entender el proceso de realización de un filtro. A partir de aquí empezamos a acercarnos a los filtros elípticos. Sin embargo, antes debemos pararnos a explorar los filtros de Chebyshev. Los filtros de Chebyshev son más simples porque usan para su expresión matemática la circunferencia en vez de la elipse. Deberían llamarse filtros circulares, pero ya se ha quedado el nombre de Chebyshev.
Lo primero que necesitamos para entender los filtros de Chebyshev es la definición de arcocoseno. [$$arccos(x)=\int_x^1{\frac{dt}{\sqrt{1-t^2}}}$$] Esta integral no es más que la longitud de arco de una circunferencia unitaria desde una abscisa [$x$]. (Nota: Por supuesto, es una función multivaluada. Tomaremos sólo la rama de la raíz principal aquí).
 |
| El arcocoseno no es más que la longitud del arco marcado. |
Lo sorprendente es que esta integral, el arcocoseno, tiene sentido cuando [$x$] va más allá de [$\pm 1$]. Eso sí, hemos de usar números complejos porque el radicando que aparece en la raíz se hace negativo.
Dibujaremos el valor que toma el arcocoseno en el plano de Argand conforme [$x$] tome valores reales. Empezaremos por el arcocoseno de cero que es [$\pi/2$].
 |
| El arcocoseno de cero es [$\pi/2$]. |
Si vamos aumentando [$x$], llegamos hasta [$arccos(1)=0$] obteniendo únicamente números reales. Es el arcocoseno clásico. Igualmente, si disminuimos [$x$], llegamos hasta [$arccos(-1)=\pi$]. Esta simetría continuará por lo que no hablaremos más de los valores negativos de [$x$].
 |
| El recorrido desde el arcocoseno de cero al arcocoseno de uno (y menos uno). |
En el punto [$arccos(1)=0$] ocurre que la raíz del integrando se anula. [$$\sqrt{1-t^2 }=0$$] Si seguimos moviendo [$x$] por la recta real, el arcocoseno entrará en el eje imaginario. A partir de aquí tenemos otras dos ramas, la raíz positiva y la negativa. Elegimos la positiva y recordamos para luego que hay simetrías.
 |
| El recorrido del valor del arcoseno de los números reales. |
Las olas del coseno
En los complejos, el coseno es una función holomorfa. Una de sus particularidades es la periodicidad en el eje real. Si trazamos su diagrama de ceros (no tiene polos) y añadimos algunos puntos destacados en la línea real obtenemos lo siguiente.
 |
| Los valores destacados que toma el coseno cuando su argumento es un número complejo. |
Si recorremos el plano de Argand por la línea real [$x=\sigma$], obtenemos la función coseno clásica. El lado más oscuro corresponde a los valores negativos.
 |
| Los valores del coseno cuando su argumento es un número real ([$\omega=0$]) |
Si recorremos el coseno por la recta imaginaria obtenemos el coseno hiperbólico. Es importante darse cuenta que por estos dos recorridos el coseno siempre proporciona un valor real.
 |
| Los valores del coseno cuando su argumento es un número imaginario ([$\sigma=0$]) |
Como era de esperar, al ser el arcocoseno la función inversa del coseno, si hacemos el recorrido del arcocoseno desde 0 hasta infinito, vamos visitando los argumentos cuyo coseno se mueve desde 0 hasta infinito.
 |
| Los valores del arcocoseno recorren los argumentos del coseno cuyo resultado es el argumento del arcocoseno. Son funciones inversas una de otra. |
Los polinomios de Chebyshev
Los polinomios de Chebyshev se definen así: [$$C_n (x)=cos(n\ arccos(x) )$$] Para ver cómo son, observemos el recorrido de [$n\ arccos(x)$] sobre la función coseno. Es muy sencillo porque lo único que hacemos al multiplicar por [$n$] es ampliar fotográficamente [$n$] veces el recorrido del arcocoseno. En el siguiente diagrama usamos [$n=3$].
 |
| El polinomio de Chebyshev de orden tres se obtiene ampliando por tres el recorrido del arcocoseno (la gráfica de abajo) y, luego, realizar el coseno (las dos gráficas de arriba). |
Ampliar tres veces el recorrido no cambia mucho el valor del coseno por la recta imaginaria. Lo hace más abrupto porque nos movemos más rápidamente hacia el infinito. En donde sí que hay un cambio es en la parte real donde tenemos tres cuartos de pi en vez de uno. Esto hace que se oscile en esa parte.
Recordemos que en estas rectas todos los valores del coseno son reales y que hay otra parte simétrica cuando [$t\lt 0$]. Con esto en mente podemos dibujar [$C_3$].
 |
| Polinomio de Chebyshev de orden tres. |
Observando con cuidado el recorrido de arriba, vemos que atraviesa exactamente 3 ceros del coseno: el [$\pi/2$] y su simétrico en [$5 \pi/2$] y el [$3 \pi/2$] que es su propio simétrico. Además, no es casual que los puntos donde [$x=\pm 1$] tome el valor [$y= \pm 1$] ya que son los puntos de arcocoseno nulo.
Una manera fácil de calcular los polinomios de Chebyshev es la siguiente. [$$C_{n+1} (x)=cos(n\ arccos(x)+arccos(x) )=x C_n (x)+sin(n\ arccos(x) ) sin(arccos (x) )$$][$$ C_{n-1}(x)=cos(n\ arccos(x)-arccos(x) )=x C_n (x)-sin(n\ arccos(x) ) sin(arccos(x) )$$] Sumando se llega a [$C_{n+1} (x)+C_{n-1} (x)=2 x C_n (x)$] y despejando [$C_{n+1} (x)$] se obtiene la siguiente fórmula recursiva. [$$C_{n+1} (x)=2 C_n (x) - C_{n-1} (x)$$] Usando la definición se obtiene que [$C_0 (x)=1$] y [$C_1 (x)=x$] con lo que tenemos todos los datos para calcular el polinomio de Chebyshev del orden que queramos.
El filtro de Chebyshev
La función [$C_n^2 (\omega)$] es una buena aproximación de [$F^2 (\omega)$]. Dibujemos su gráfica para n=3.
 |
| El polinomio de Chebyshev de tercer grado al cuadrado como aproximación a [$F^2(\omega)$]. |
Para que cumpla los requisitos de un filtro hay que ajustarla un poco. [$$ F^2 (\omega)=\epsilon_p^2 C_n^2 \left(\frac{\omega}{\omega_p} \right)$$]
 |
| La función [$F^2(\omega)$] de un filtro de Chebyshev. |
Así que un filtro de Chebyshev es el que tiene la siguiente respuesta en frecuencia al cuadrado. [$$ |H(j\omega) |^2=\frac{1}{1+\epsilon_p^2 C_n^2 \left(\frac{\omega}{\omega_p} \right)}$$] A partir de aquí procedemos como en el filtro de Butterworth. Calculamos [$\epsilon_s$], despejamos [$n$] para el orden; calculamos los polos de [$|H(s) |^2$] (este filtro no tiene ceros) y separamos los polos para obtener [$H(s)$].
Todo esto lo dejaremos para el lector que observará, entre otras cosas, que el orden requerido es menor en un filtro de Chebyshev que en un filtro de Butterworth para los mismos requisitos.
El lector curioso queda emplazado para explorar los filtros inversos de Chebyshev e intentar usar la misma técnica de inversión para los filtros de Butterworth.
Continúa y acaba en la cuarta parte.
viernes, 19 de agosto de 2011
Lo que nunca me enseñaron: Los filtros de Cauer (parte II)
Parte 1 aquí.
El filtro de Butterworth
Aproximar la función [$F^2 (\omega)$] que debería valer 0 si [$\omega < \omega_p$] e infinito si [$\omega > \omega_s$] es muy sencillo. Todas las funciones monótonas (siempre crecientes) lo aproximan con más o menos éxito.
Una [$F^2 (\omega)$] muy usada es [$$F^2 (\omega)= \epsilon _p^2 \left(\frac{ \omega }{ \omega_p } \right)^{2n}$$] Este es el llamado filtro de Butterwoth. El número [$n$] es el orden del filtro. Debido a que debemos trabajar con polinomios, las potencias han de ser números naturales y, por tanto, el orden del filtro n debe ser un número natural. El orden del filtro está relacionado con el número de componentes eléctricos que va a tener nuestro circuito.
Construyamos su respuesta en frecuencia al cuadrado. [$$ |H(j\omega)|^2=\frac{1}{1+\epsilon_p^2 \left(\omega/\omega_p \right)^{2n}}$$] El filtrado de frecuencias que hace este filtro se muestra a continuación. Esta gráfica es la original del artículo de Butterworth de 1930 y representa [$|H(j\omega)|$] con [$\omega_p=1$].
El valor [$\epsilon_p$] está explícitamente escrito en la ecuación, pero no sabemos nada de [$\epsilon_s$]. Hemos de usar la expresión de [$|H(j\omega) |^2$] para deducir qué valor tendremos para [$\epsilon_s$]. Bastará calcular la respuesta en frecuencia a la frecuencia [$\omega_s$]. [$$|H(j\omega_s ) |^2=\frac{1}{1+\epsilon_p^2 \left(\omega_s/\omega_p\right)^{2n}} = \frac{\epsilon_s^2}{1+\epsilon_s^2}$$][$$ \frac{1}{\epsilon_s^2}=\epsilon_p^2 \left(\frac{\omega_s}{\omega_p}\right)^{2n},\ \ \ \ \epsilon_s \epsilon_p=\left( \frac{\omega_p}{\omega_s}\right) ^n$$] Esta última expresión, muy simple gracias a la introducción de los épsilon en la parte anterior, relaciona el orden del filtro con los requisitos. Como el orden del filtro ha de ser un natural, es usual escribir la ecuación como una cota. [$$ n \ge \frac{log(\epsilon_s \epsilon_p)}{log \left( \frac{\omega_p}{\omega_s} \right) } $$]
Polos y ceros
La función [$|H(j\omega) |^2$] está relacionada con la respuesta en frecuencia del filtro [$|H(j\omega) |$] sin cuadrado, pero lo que nos interesa para poder implementar el filtro es la función de transferencia [$H(s)$] que abarca todos los complejos. Los pasos son los siguientes.
Primero, con un cambio de variables [$\omega=-js$], convertimos [$|H(j\omega) |^2$] en [$|H(s) |^2$]. [$$ |H(s)|^2=\frac{1}{1+\epsilon_p^2 \left(-js/\omega_p \right)^{2n}}$$]
A continuación, obtendremos la función [$|H(s) |^2$] como un cociente de dos polinomios. Escribiremos los polinomios factorizando sus raíces. [$$|H(s) |^2=A^2 \frac{\prod{s-s_{cero m} }}{\prod{s-s_{polo m} }}$$] Las raíces del numerador se llaman ceros porque cuando [$s$] sea un [$s_{cero}$], tendremos que [$|H(s) |^2=0$]. Las raíces del denominador se llaman polos porque cuando [$s$] tienda a un [$s_{polo}$], todo [$|H(s) |^2$] tiende a infinito. El por qué se llaman polos es obvio cuando se hace la gráfica en tres dimensiones.
Los filtros de Butterworth no tienen ceros. Esto ocurre porque el numerador de [$|H(s) |^2$] es uno. Pero sí tienen polos cuando el denominador se anula. Es decir, cuando [$F^2 (\omega)=-1$].[$$F^2 (-js_{polo} )=-1$$][$$\epsilon_p^2 \left(\frac{-js_{polo}}{\omega_p}\right)^{2n}=-1$$][$$\epsilon_p \left(\frac{-js_{polo}}{\omega_p}\right)^n=j$$][$$ \sqrt[n]{\epsilon_p}\frac{-js_{polo}}{\omega_p}=\sqrt[n]{j}$$][$$s_{polo}=\frac{j \omega_p}{\sqrt[n]{\epsilon_p}} \sqrt[n]{j}$$]
Usando las raíces de la unidad, llegamos a que los polos de [$|H(s) |^2$] yacen en un círculo. Como hay más de uno, los numeramos con un subíndice [$m$]. [$$s_{polo\ m}=\omega_p \epsilon_p^{\frac{-1}{n}} e^{j\left[\frac{p}{2}+\frac{p}{2n}+\frac{2p}{n} m\right]}$$] Es interesante localizar los polos en el plano de Argand (plano complejo). El siguiente diagrama muestra los polos de [$|H(s) |^2$] de un filtro de Butterworth de orden tres.
Obteniendo la función de transferencia
La simetría que aparece en el diagrama anterior es usual en [$|H(s) |^2$] y se llama simetría cuadrantal. Ocurre que [$$|H(s) |^2=|H(-s) |^2=|H(s^* ) |^2$$] por lo que la función [$|H(s) |^2$] queda completamente definida por lo que pase en sólo uno de sus cuadrantes. Esta simetría se usa para obtener [$H(s)$] a partir de [$|H(s) |^2$] mediante la siguiente ecuación: [$$|H(s) |^2=H(s)H(-s)$$] Recordemos que [$|H(s) |^2$] estaba descrita como un producto de polos y ceros. Entonces, podemos separar los polos que van para [$H(s)$] y los que van para [$H(-s)$].[$$ A^2 \frac{\prod{(s-s_{cero\ m})}}{\prod{(s-s_{polo\ m})}}=\left[A \frac{\prod{(s-s_{cero\ de\ H(s)\ m})}}{\prod{(s-s_{polo\ de\ H(s)\ m} )}}\right]\left[A \frac{\prod{(s-s_{cero\ de\ H(-s)\ m} )} }{\prod{(s-s_{polo\ de\ H(-s)\ m}) } }\right]$$] Lo que sí que hay que decidir es qué polos van para [$H(s)$] y qué polos van para [$H(-s)$]. Es fácil. Para que [$H(s)$] sea realizable físicamente y estable, hay que escoger los polos cuya parte real sea negativa. Y para que el filtro sea de fase mínima (menor dispersión) también cogeremos los ceros que tengan su parte real negativa.
Una vez tenemos [$H(s)$] podemos usar alguna de las técnicas de síntesis de circuitos para realizar el filtro.
Continúa en la parte tres.
El filtro de Butterworth
Aproximar la función [$F^2 (\omega)$] que debería valer 0 si [$\omega < \omega_p$] e infinito si [$\omega > \omega_s$] es muy sencillo. Todas las funciones monótonas (siempre crecientes) lo aproximan con más o menos éxito.
Una [$F^2 (\omega)$] muy usada es [$$F^2 (\omega)= \epsilon _p^2 \left(\frac{ \omega }{ \omega_p } \right)^{2n}$$] Este es el llamado filtro de Butterwoth. El número [$n$] es el orden del filtro. Debido a que debemos trabajar con polinomios, las potencias han de ser números naturales y, por tanto, el orden del filtro n debe ser un número natural. El orden del filtro está relacionado con el número de componentes eléctricos que va a tener nuestro circuito.
Construyamos su respuesta en frecuencia al cuadrado. [$$ |H(j\omega)|^2=\frac{1}{1+\epsilon_p^2 \left(\omega/\omega_p \right)^{2n}}$$] El filtrado de frecuencias que hace este filtro se muestra a continuación. Esta gráfica es la original del artículo de Butterworth de 1930 y representa [$|H(j\omega)|$] con [$\omega_p=1$].
 |
| Respuesta en frecuencia de un filtro de Butterworth tal cual aparecía en su artículo de 1930. |
El valor [$\epsilon_p$] está explícitamente escrito en la ecuación, pero no sabemos nada de [$\epsilon_s$]. Hemos de usar la expresión de [$|H(j\omega) |^2$] para deducir qué valor tendremos para [$\epsilon_s$]. Bastará calcular la respuesta en frecuencia a la frecuencia [$\omega_s$]. [$$|H(j\omega_s ) |^2=\frac{1}{1+\epsilon_p^2 \left(\omega_s/\omega_p\right)^{2n}} = \frac{\epsilon_s^2}{1+\epsilon_s^2}$$][$$ \frac{1}{\epsilon_s^2}=\epsilon_p^2 \left(\frac{\omega_s}{\omega_p}\right)^{2n},\ \ \ \ \epsilon_s \epsilon_p=\left( \frac{\omega_p}{\omega_s}\right) ^n$$] Esta última expresión, muy simple gracias a la introducción de los épsilon en la parte anterior, relaciona el orden del filtro con los requisitos. Como el orden del filtro ha de ser un natural, es usual escribir la ecuación como una cota. [$$ n \ge \frac{log(\epsilon_s \epsilon_p)}{log \left( \frac{\omega_p}{\omega_s} \right) } $$]
Polos y ceros
La función [$|H(j\omega) |^2$] está relacionada con la respuesta en frecuencia del filtro [$|H(j\omega) |$] sin cuadrado, pero lo que nos interesa para poder implementar el filtro es la función de transferencia [$H(s)$] que abarca todos los complejos. Los pasos son los siguientes.
Primero, con un cambio de variables [$\omega=-js$], convertimos [$|H(j\omega) |^2$] en [$|H(s) |^2$]. [$$ |H(s)|^2=\frac{1}{1+\epsilon_p^2 \left(-js/\omega_p \right)^{2n}}$$]
A continuación, obtendremos la función [$|H(s) |^2$] como un cociente de dos polinomios. Escribiremos los polinomios factorizando sus raíces. [$$|H(s) |^2=A^2 \frac{\prod{s-s_{cero m} }}{\prod{s-s_{polo m} }}$$] Las raíces del numerador se llaman ceros porque cuando [$s$] sea un [$s_{cero}$], tendremos que [$|H(s) |^2=0$]. Las raíces del denominador se llaman polos porque cuando [$s$] tienda a un [$s_{polo}$], todo [$|H(s) |^2$] tiende a infinito. El por qué se llaman polos es obvio cuando se hace la gráfica en tres dimensiones.
 |
| Visión 3D de la función de transferencia de un filtro de Butterworth. Se observan los polos y la respuesta en frecuencia cuya parte positiva está remarcada en rojo. |
Los filtros de Butterworth no tienen ceros. Esto ocurre porque el numerador de [$|H(s) |^2$] es uno. Pero sí tienen polos cuando el denominador se anula. Es decir, cuando [$F^2 (\omega)=-1$].[$$F^2 (-js_{polo} )=-1$$][$$\epsilon_p^2 \left(\frac{-js_{polo}}{\omega_p}\right)^{2n}=-1$$][$$\epsilon_p \left(\frac{-js_{polo}}{\omega_p}\right)^n=j$$][$$ \sqrt[n]{\epsilon_p}\frac{-js_{polo}}{\omega_p}=\sqrt[n]{j}$$][$$s_{polo}=\frac{j \omega_p}{\sqrt[n]{\epsilon_p}} \sqrt[n]{j}$$]
Usando las raíces de la unidad, llegamos a que los polos de [$|H(s) |^2$] yacen en un círculo. Como hay más de uno, los numeramos con un subíndice [$m$]. [$$s_{polo\ m}=\omega_p \epsilon_p^{\frac{-1}{n}} e^{j\left[\frac{p}{2}+\frac{p}{2n}+\frac{2p}{n} m\right]}$$] Es interesante localizar los polos en el plano de Argand (plano complejo). El siguiente diagrama muestra los polos de [$|H(s) |^2$] de un filtro de Butterworth de orden tres.
 |
| Distribución de los polos de la función de transferencia al cuadrado de un filtro de Butterworth de orden tres. |
Obteniendo la función de transferencia
La simetría que aparece en el diagrama anterior es usual en [$|H(s) |^2$] y se llama simetría cuadrantal. Ocurre que [$$|H(s) |^2=|H(-s) |^2=|H(s^* ) |^2$$] por lo que la función [$|H(s) |^2$] queda completamente definida por lo que pase en sólo uno de sus cuadrantes. Esta simetría se usa para obtener [$H(s)$] a partir de [$|H(s) |^2$] mediante la siguiente ecuación: [$$|H(s) |^2=H(s)H(-s)$$] Recordemos que [$|H(s) |^2$] estaba descrita como un producto de polos y ceros. Entonces, podemos separar los polos que van para [$H(s)$] y los que van para [$H(-s)$].[$$ A^2 \frac{\prod{(s-s_{cero\ m})}}{\prod{(s-s_{polo\ m})}}=\left[A \frac{\prod{(s-s_{cero\ de\ H(s)\ m})}}{\prod{(s-s_{polo\ de\ H(s)\ m} )}}\right]\left[A \frac{\prod{(s-s_{cero\ de\ H(-s)\ m} )} }{\prod{(s-s_{polo\ de\ H(-s)\ m}) } }\right]$$] Lo que sí que hay que decidir es qué polos van para [$H(s)$] y qué polos van para [$H(-s)$]. Es fácil. Para que [$H(s)$] sea realizable físicamente y estable, hay que escoger los polos cuya parte real sea negativa. Y para que el filtro sea de fase mínima (menor dispersión) también cogeremos los ceros que tengan su parte real negativa.
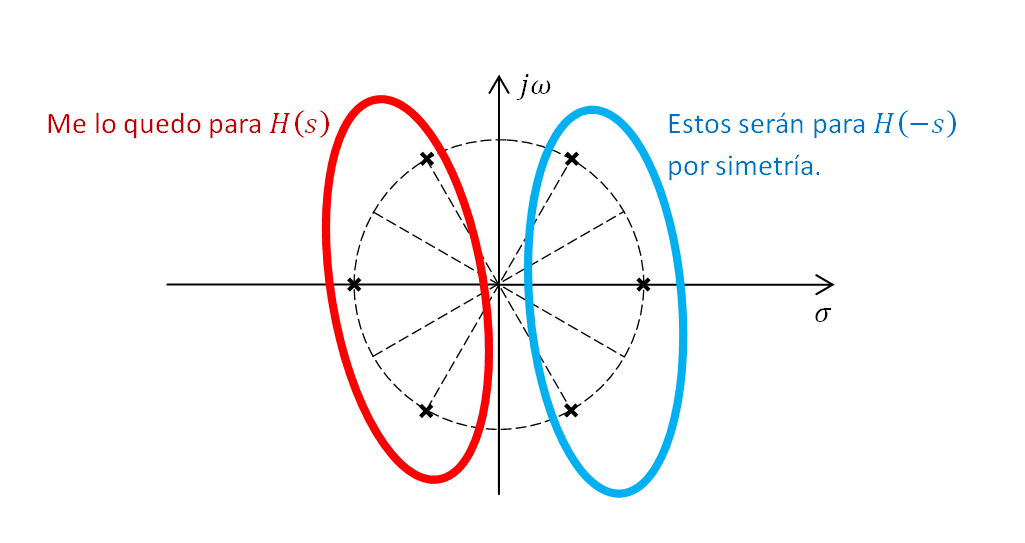 |
| Separación de los polos de [$|H(s)|^2$] que van para [$H(s)$] de los que van para [$H(-s)$]. |
Una vez tenemos [$H(s)$] podemos usar alguna de las técnicas de síntesis de circuitos para realizar el filtro.
Continúa en la parte tres.
miércoles, 17 de agosto de 2011
Lo que nunca me enseñaron: Los filtros de Cauer (parte I)
Introducción
Según cuenta Van Valkenburg (ver "Analog Filter Design" 1982, página 379), sobre 1935 los ingenieros de Bell Laboratories se llevaron una desagradable sorpresa. Su competencia alemana había sacado un teléfono al mercado que igualaba la calidad de sonido del suyo, pero usaba un inductor menos en los filtros.
En 1935 los inductores no eran lo que hoy. Un inductor pesaba su cuarto de kilo y costaba bastante. El que los alemanes hubieran conseguido eliminarlo sin deteriorar las características del dispositivo podría llevar la empresa americana a la ruina y no era época para tonterías con los alemanes.
Pero esa ruina no ocurrió. El inventor del método de diseño que hacía capaz ese ahorro, Wilhelm Cauer, estaba necesitado de dinero (supongo) y quiso vender sus patentes. Para eso dio unas conferencias y los muy avispados matemáticos de Bell Laboratories tomaron nota. Una familia de funciones matemáticas se mencionó varias veces: las funciones elípticas de Jacobi.
Cuenta la leyenda que durante las dos semanas siguientes el departamento entero de matemáticas de Bell Laboratories se encerró en la biblioteca pública de Nueva York, estudiando tales funciones. Si mal no recuerda Darlington, que lo sufrió en sus propias carnes, allí encontró el artículo original de Jacobi de 1829 escrito en latín. En él estaba todo: tablas, transformaciones, aproximaciones… ¡todo!
A fin de cuentas, Cauer fue estudiante de Hilbert en Göttingen. Dada la prominencia del maestro, seguramente había visto de sobra estas funciones elípticas y, simplemente, les había encontrado otra aplicación. Por ese motivo, a este tipo de filtros se los denomina filtros elípticos o filtros de Cauer.
Los filtros
Un filtro eléctrico no es más que un dispositivo que toma una señal eléctrica como la del teléfono y elimina algunas frecuencias. De esta manera podemos oír la voz sin los ruidos raros del ADSL introduciendo un filtro que elimine las frecuencias que usa el ADSL. Lógicamente, podremos usar otro filtro para quedarnos con el ADSL y quitar la voz. Así que, por un mismo cable y gracias a un par de filtros, tengo voz y datos.
Esta no es más que una de las aplicaciones de los filtros. Hay muchísimas más: multiplexar, eliminar el aliasing, hacer efectos de sonido y ecualizar, compensar desfases, modular, demodular… y un sinfín más que no vamos a enumerar aquí porque lo que nos interesa es el trasfondo teórico de los filtros.
La función de transferencia y la respuesta en frecuencia
La forma que tienen los filtros de procesar las señales es mediante una función de transferencia [$H(s)$]. Esta función está definida en los números complejos y, para que pueda ser construida físicamente, ha de ser racional (P y Q son polinomios). [$$H(s)=\frac{P(s)}{Q(s)}$$] La magnitud de la función de transferencia en el eje imaginario es la respuesta en frecuencia. Esta respuesta es lo que nuestro filtro multiplicará a la amplitud cada frecuencia. Si su valor a una frecuencia es mayor que uno, esa frecuencia se amplifica. Si es menor que uno, se atenúa. Escribiremos esta magnitud así:[$$|H(j\omega)|$$] Donde [$\omega$] no es más que [$2\pi$] veces la frecuencia ([$\omega=2\pi f$]) para no tener que escribir [$2\pi$] cada vez que vayamos a usar un seno, coseno o exponencial compleja. La [$j$] es la constante imaginaria que, en ingeniería, se usa para no confundirla con la intensidad de corriente [$i$].
Es importante señalar aquí que para realizar el filtro necesitamos la función [$H(s)$] con [$s$] en todo el plano complejo, pero la respuesta en frecuencia que deseamos es sólo esa función en la recta imaginaria [$|H(j\omega)|\ \ $]. Gran parte del problema estriba en pasar de [$|H(j\omega)|\ \ $], lo que queremos, a [$H(s)$], cómo hacerlo.
Pero primero veamos qué queremos.
El filtro ideal y los filtros reales
Nos interesaría que la respuesta en frecuencia fuera ideal: todo lo que haya por encima de una frecuencia de corte [$\omega_c$] se elimina (se multiplica por 0 en la banda de rechazo) y todo lo que haya por debajo se preserva (se multiplica por 1 en la banda de paso). Eso significa que el [$|H(j\omega)|$] ideal tendría esta forma:
Sin embargo, esto no es posible porque las únicas funciones de transferencia que podemos realizar eléctricamente son funciones racionales (recordemos: cocientes de dos polinomios) y son funciones continuas excepto en asíntotas verticales. No es posible hacer el escalón discontinuo que vemos en la gráfica de arriba. Hay que transigir y permitir no tener exactamente un 1 o un 0 (a esto se le denomina rizado) y dejar una banda de transición entre las bandas de paso y de rechazo.
Ya no tenemos una frecuencia de corte, sino una frecuencia de paso [$\omega_p$] por debajo de la cual las frecuencias no se van a tocar mucho (entre [$1$] y [$r_p$]) y una frecuencia de rechazo [$\omega_s$] por encima de la cual no van a sobrevivir muchas frecuencias (como mucho se multiplica por [$r_s$] que será todo lo cercano a cero posible).
Nota: El subíndice s viene del inglés stopband.
Complicando para simplificar
Como vemos, todo el rango de trabajo está entre el [$0$] y el [$1$]. Si elevamos al cuadrado, seguimos estando entre [$0$] y [$1$]. Esto permite trabajar con la magnitud al cuadrado que es más sencilla de calcular y siempre es real positiva. [$$ |H(j\omega)|^2=H(j\omega) H^*(j\omega)=H(j \omega )H(-j \omega )$$] El asterisco indica complejo conjugado. La última igualdad saca provecho a que [$H(s)$] es racional con coeficientes reales y, por tanto, su parte imaginaria ha de ser hermítica.
Trabajar entre [$0$] e infinito es también más sencillo. ¿Por qué? Si el límite es el [$1$], nos podemos pasar de [$1$] y eso sería erróneo. Nos tendríamos que dedicar a comprobar que nuestros cálculos nunca superasen el uno y los complicaría. En cambio, si el límite es infinito, ¡no hay límite! Los cálculos no tienen necesidad de asegurar que haya un límite y se simplifican.
Forzaremos que la función [$|H(j\omega)|^2$] tenga esta forma: [$$ |H(j\omega)|^2=\frac{1}{1+F^2 ( \omega )}$$]Ahora, la función [$F^2 ( \omega )$] no tiene límite superior. A cambio, hemos de recalcular los rizados.
Estos nuevos parámetros [$\epsilon_s$] y [$\epsilon_p$] se relacionan con los rizados originales así: [$$r_p=\sqrt{\frac{1}{1+\epsilon_p^2}},\ \ \ \ r_s=\sqrt{\frac{\epsilon_s^2}{1+ \epsilon _s^2}}$$] Llamaremos a [$\omega_p,\epsilon_p,\omega_s$] y [$\epsilon_s$] los requisitos del filtro.
Hay que destacar que la función [$F^2 (\omega)$] sigue siendo una función racional y deberá ser el cociente de dos polinomios.
Continúa en parte dos.
Según cuenta Van Valkenburg (ver "Analog Filter Design" 1982, página 379), sobre 1935 los ingenieros de Bell Laboratories se llevaron una desagradable sorpresa. Su competencia alemana había sacado un teléfono al mercado que igualaba la calidad de sonido del suyo, pero usaba un inductor menos en los filtros.
En 1935 los inductores no eran lo que hoy. Un inductor pesaba su cuarto de kilo y costaba bastante. El que los alemanes hubieran conseguido eliminarlo sin deteriorar las características del dispositivo podría llevar la empresa americana a la ruina y no era época para tonterías con los alemanes.
 |
| Teléfono de 1930 |
Pero esa ruina no ocurrió. El inventor del método de diseño que hacía capaz ese ahorro, Wilhelm Cauer, estaba necesitado de dinero (supongo) y quiso vender sus patentes. Para eso dio unas conferencias y los muy avispados matemáticos de Bell Laboratories tomaron nota. Una familia de funciones matemáticas se mencionó varias veces: las funciones elípticas de Jacobi.
Cuenta la leyenda que durante las dos semanas siguientes el departamento entero de matemáticas de Bell Laboratories se encerró en la biblioteca pública de Nueva York, estudiando tales funciones. Si mal no recuerda Darlington, que lo sufrió en sus propias carnes, allí encontró el artículo original de Jacobi de 1829 escrito en latín. En él estaba todo: tablas, transformaciones, aproximaciones… ¡todo!
A fin de cuentas, Cauer fue estudiante de Hilbert en Göttingen. Dada la prominencia del maestro, seguramente había visto de sobra estas funciones elípticas y, simplemente, les había encontrado otra aplicación. Por ese motivo, a este tipo de filtros se los denomina filtros elípticos o filtros de Cauer.
 |
| David Hilbert y Wilhelm Cauer |
Los filtros
Un filtro eléctrico no es más que un dispositivo que toma una señal eléctrica como la del teléfono y elimina algunas frecuencias. De esta manera podemos oír la voz sin los ruidos raros del ADSL introduciendo un filtro que elimine las frecuencias que usa el ADSL. Lógicamente, podremos usar otro filtro para quedarnos con el ADSL y quitar la voz. Así que, por un mismo cable y gracias a un par de filtros, tengo voz y datos.
 |
| Splitter de ADSL que no es más que un filtro para que no se oiga el ruido de los datos de ADSL en el audio del teléfono. |
Esta no es más que una de las aplicaciones de los filtros. Hay muchísimas más: multiplexar, eliminar el aliasing, hacer efectos de sonido y ecualizar, compensar desfases, modular, demodular… y un sinfín más que no vamos a enumerar aquí porque lo que nos interesa es el trasfondo teórico de los filtros.
La función de transferencia y la respuesta en frecuencia
La forma que tienen los filtros de procesar las señales es mediante una función de transferencia [$H(s)$]. Esta función está definida en los números complejos y, para que pueda ser construida físicamente, ha de ser racional (P y Q son polinomios). [$$H(s)=\frac{P(s)}{Q(s)}$$] La magnitud de la función de transferencia en el eje imaginario es la respuesta en frecuencia. Esta respuesta es lo que nuestro filtro multiplicará a la amplitud cada frecuencia. Si su valor a una frecuencia es mayor que uno, esa frecuencia se amplifica. Si es menor que uno, se atenúa. Escribiremos esta magnitud así:[$$|H(j\omega)|$$] Donde [$\omega$] no es más que [$2\pi$] veces la frecuencia ([$\omega=2\pi f$]) para no tener que escribir [$2\pi$] cada vez que vayamos a usar un seno, coseno o exponencial compleja. La [$j$] es la constante imaginaria que, en ingeniería, se usa para no confundirla con la intensidad de corriente [$i$].
Es importante señalar aquí que para realizar el filtro necesitamos la función [$H(s)$] con [$s$] en todo el plano complejo, pero la respuesta en frecuencia que deseamos es sólo esa función en la recta imaginaria [$|H(j\omega)|\ \ $]. Gran parte del problema estriba en pasar de [$|H(j\omega)|\ \ $], lo que queremos, a [$H(s)$], cómo hacerlo.
Pero primero veamos qué queremos.
El filtro ideal y los filtros reales
Nos interesaría que la respuesta en frecuencia fuera ideal: todo lo que haya por encima de una frecuencia de corte [$\omega_c$] se elimina (se multiplica por 0 en la banda de rechazo) y todo lo que haya por debajo se preserva (se multiplica por 1 en la banda de paso). Eso significa que el [$|H(j\omega)|$] ideal tendría esta forma:
 |
| Un filtro ideal que elimina las frecuencias de la banda de rechazo y deja intactas las frecuencias de la banda de paso. |
Sin embargo, esto no es posible porque las únicas funciones de transferencia que podemos realizar eléctricamente son funciones racionales (recordemos: cocientes de dos polinomios) y son funciones continuas excepto en asíntotas verticales. No es posible hacer el escalón discontinuo que vemos en la gráfica de arriba. Hay que transigir y permitir no tener exactamente un 1 o un 0 (a esto se le denomina rizado) y dejar una banda de transición entre las bandas de paso y de rechazo.
 |
| Forma de un filtro real donde se han especificado los requisitos del mismo: frecuencia de paso [$\omega_p$], frecuencia de rechazo [$\omega_s$], rizado de paso [$r_p$] y rizado de rechazo [$r_s$]. |
Ya no tenemos una frecuencia de corte, sino una frecuencia de paso [$\omega_p$] por debajo de la cual las frecuencias no se van a tocar mucho (entre [$1$] y [$r_p$]) y una frecuencia de rechazo [$\omega_s$] por encima de la cual no van a sobrevivir muchas frecuencias (como mucho se multiplica por [$r_s$] que será todo lo cercano a cero posible).
Nota: El subíndice s viene del inglés stopband.
Complicando para simplificar
Como vemos, todo el rango de trabajo está entre el [$0$] y el [$1$]. Si elevamos al cuadrado, seguimos estando entre [$0$] y [$1$]. Esto permite trabajar con la magnitud al cuadrado que es más sencilla de calcular y siempre es real positiva. [$$ |H(j\omega)|^2=H(j\omega) H^*(j\omega)=H(j \omega )H(-j \omega )$$] El asterisco indica complejo conjugado. La última igualdad saca provecho a que [$H(s)$] es racional con coeficientes reales y, por tanto, su parte imaginaria ha de ser hermítica.
Trabajar entre [$0$] e infinito es también más sencillo. ¿Por qué? Si el límite es el [$1$], nos podemos pasar de [$1$] y eso sería erróneo. Nos tendríamos que dedicar a comprobar que nuestros cálculos nunca superasen el uno y los complicaría. En cambio, si el límite es infinito, ¡no hay límite! Los cálculos no tienen necesidad de asegurar que haya un límite y se simplifican.
Forzaremos que la función [$|H(j\omega)|^2$] tenga esta forma: [$$ |H(j\omega)|^2=\frac{1}{1+F^2 ( \omega )}$$]Ahora, la función [$F^2 ( \omega )$] no tiene límite superior. A cambio, hemos de recalcular los rizados.
 |
| La misma respuesta en frecuencia de antes, pero con la transformación mencionada para trabajar entre [$0$] e infinito. Hay que hacer notar cómo se han modificado los parámetros que especificaban los rizados. |
Estos nuevos parámetros [$\epsilon_s$] y [$\epsilon_p$] se relacionan con los rizados originales así: [$$r_p=\sqrt{\frac{1}{1+\epsilon_p^2}},\ \ \ \ r_s=\sqrt{\frac{\epsilon_s^2}{1+ \epsilon _s^2}}$$] Llamaremos a [$\omega_p,\epsilon_p,\omega_s$] y [$\epsilon_s$] los requisitos del filtro.
Hay que destacar que la función [$F^2 (\omega)$] sigue siendo una función racional y deberá ser el cociente de dos polinomios.
Continúa en parte dos.
viernes, 17 de junio de 2011
El lío de las composiciones
La composición en las relaciones
Una relación [$\le$] entre [$A$] y [$B$] es un subconjunto del conjunto cartesiano.[$$\le \subseteq A\times B$$]Cuando dos elementos [$a\in A$] y [$b\in B$] están relacionados escribimos [$$ a \le b \Leftrightarrow (a,b)\in \le$$] La composición de dos relaciones [$\le_1$] entre [$A$] y [$B$]; y [$\le_2$] entre [$B$] y [$C$] es [$\le_1 \circ \le_2$] definida así [$$ a \le_1\circ \le_2 c \Leftrightarrow \exists b\in B.a\le_1 b\le_2 c $$] Es interesante ver el parecido natural entre [$$ a \le_1\circ \le_2 c$$] y [$$ a\le_1 b\le_2 c $$] como si el [$\circ$] representase un elemento indefinido a buscar.
La composición en las funciones
Una función [$f:A\to B$] no es más que una relación en la cual [$$\forall a\in A.\exists ! b\in B. a f b $$] Para los que no lo hayan visto nunca [$\exists !$] significa "existe un único".
Bien, los problemas empiezan porque si existe un único [$b$] lo natural es representarlo por [$f$] y [$a$]. La forma de hacerlo es esta: [$$f(a)=b \Leftrightarrow a f b$$] ¿Por qué es problemático? Porque si pienso que una función es una relación y defino la composición de funciones como una composición de relaciones obtenemos [$$ (f\circ g)(a)=g(f(a)) $$] Invirtiéndose el orden de [$f$] y [$g$], lo que lía muchísimo. Así que lo que se hace es definir al revés la composición de funciones. [$$ (f\circ g)(a)=f(g(a)) $$] Por lo que deja de ser igual que la composición de relaciones.
Soluciones
Las que se me ocurren así a bote pronto son:
Una relación [$\le$] entre [$A$] y [$B$] es un subconjunto del conjunto cartesiano.[$$\le \subseteq A\times B$$]Cuando dos elementos [$a\in A$] y [$b\in B$] están relacionados escribimos [$$ a \le b \Leftrightarrow (a,b)\in \le$$] La composición de dos relaciones [$\le_1$] entre [$A$] y [$B$]; y [$\le_2$] entre [$B$] y [$C$] es [$\le_1 \circ \le_2$] definida así [$$ a \le_1\circ \le_2 c \Leftrightarrow \exists b\in B.a\le_1 b\le_2 c $$] Es interesante ver el parecido natural entre [$$ a \le_1\circ \le_2 c$$] y [$$ a\le_1 b\le_2 c $$] como si el [$\circ$] representase un elemento indefinido a buscar.
La composición en las funciones
Una función [$f:A\to B$] no es más que una relación en la cual [$$\forall a\in A.\exists ! b\in B. a f b $$] Para los que no lo hayan visto nunca [$\exists !$] significa "existe un único".
Bien, los problemas empiezan porque si existe un único [$b$] lo natural es representarlo por [$f$] y [$a$]. La forma de hacerlo es esta: [$$f(a)=b \Leftrightarrow a f b$$] ¿Por qué es problemático? Porque si pienso que una función es una relación y defino la composición de funciones como una composición de relaciones obtenemos [$$ (f\circ g)(a)=g(f(a)) $$] Invirtiéndose el orden de [$f$] y [$g$], lo que lía muchísimo. Así que lo que se hace es definir al revés la composición de funciones. [$$ (f\circ g)(a)=f(g(a)) $$] Por lo que deja de ser igual que la composición de relaciones.
Soluciones
Las que se me ocurren así a bote pronto son:
- Usar una notación postfija para las funciones [$(a)f$] en vez de [$f(a)$]. De esta manera [$ (a)(f\circ g) =((a)f)g$] y el orden coincide con la composición de relaciones.
- Invertir una de las dos composiciones. O bien [$ (f\circ g)(a)=g(f(a)) $] o bien [$ a \le_2\circ \le_1 c \Leftrightarrow \exists b\in B.a\le_1 b\le_2 c $]. Hagas lo que hagas, estás invirtiendo el orden natural de la notación y vas a liarte (el elemento [$a$] va primero a [$f$] y a [$\le_1$] que están lejos de él).
- Usar dos notaciones. Por ejemplo, usar [$\le_1 ; \le_2 = \le_2 \circ \le_1$] y [$ f \circ g = g ; f $]. Esta solución la suele usar alguno que otro autor.
- Definir las funciones al revés, [$\forall a\in A.\exists ! b\in B. b f a $] de forma que [$b=f(a) \Leftrightarrow b f a$]. Claro que también así vamos en contra de unos cuantos siglos de historia y habría que darle la vuelta a muchas definiciones como relaciones inyectivas.
jueves, 9 de junio de 2011
Exponenciando la derivación
Realmente para definir la exponencial (o cualquier otra función analítica) mediante una serie de potencias hacen falta pocas cosas.
[$$ e^x = \sum_{k=0}^\infty \frac{x^k}{k!} $$]
Los operadores lineales cumplen todas estas condiciones tomando la potencia como composición iterada.
[$$f^0=Id; f^{n+1}=f\circ f^n$$]
Un caso clásico es cuando las operaciones lineales están representadas por matrices.
Otro de estos operadores lineales es la derivación, que escribiremos [$D$]. Se puede realizar la exponencial de la derivación.
[$$e^D = \sum_{k=0}^\infty \frac{D^k}{k!} $$]
Para ver mejor sus efectos, aplicaremos el resultado de [$\alpha$] veces esta exponencial sobre [$x^n$].
[$$e^{\alpha D} x^n = \sum_{k=0}^\infty \frac{\alpha^k D^k}{k!} x^n $$]
Podemos derivar hasta [$n$] veces [$x^n$]
[$$\sum_{k=0}^n \frac{n! \alpha^k x^{n-k} }{k! (n-k)!}$$]
Es interesantísimo ver que lo obtenido es justamente el binomio de Newton.
[$$ \sum_{k=0}^n \frac{n! \alpha^k x^{n-k} }{k! (n-k)!} = (x+\alpha)^n $$]
Debido a que estamos trabajando con operadores lineales, podemos volver a usar una serie de potencias para aplicar la exponencial de la derivación sobre una función analítica arbitraria.
[$$ (e^{\alpha D} f)(x) = e^{\alpha D} \sum_{i=0}^\infty {a_i x^i} = \sum_{i=0}^\infty {a_i e^{\alpha D} x^i} = \sum_{i=0}^\infty {a_i (x+\alpha)^i} = f(x+\alpha) $$]
Así que la exponencial de la derivación no es más que una traslación.
Los físicos me dicen que acabo de descubrir que el operador de momento genera las traslaciones. ¡Vaya! Pues no lo sabía.
- Una operación de multiplicación por escalar
- Una operación de suma
- Una operación de potencia
[$$ e^x = \sum_{k=0}^\infty \frac{x^k}{k!} $$]
Los operadores lineales cumplen todas estas condiciones tomando la potencia como composición iterada.
[$$f^0=Id; f^{n+1}=f\circ f^n$$]
Un caso clásico es cuando las operaciones lineales están representadas por matrices.
Otro de estos operadores lineales es la derivación, que escribiremos [$D$]. Se puede realizar la exponencial de la derivación.
[$$e^D = \sum_{k=0}^\infty \frac{D^k}{k!} $$]
Para ver mejor sus efectos, aplicaremos el resultado de [$\alpha$] veces esta exponencial sobre [$x^n$].
[$$e^{\alpha D} x^n = \sum_{k=0}^\infty \frac{\alpha^k D^k}{k!} x^n $$]
Podemos derivar hasta [$n$] veces [$x^n$]
[$$\sum_{k=0}^n \frac{n! \alpha^k x^{n-k} }{k! (n-k)!}$$]
Es interesantísimo ver que lo obtenido es justamente el binomio de Newton.
[$$ \sum_{k=0}^n \frac{n! \alpha^k x^{n-k} }{k! (n-k)!} = (x+\alpha)^n $$]
Debido a que estamos trabajando con operadores lineales, podemos volver a usar una serie de potencias para aplicar la exponencial de la derivación sobre una función analítica arbitraria.
[$$ (e^{\alpha D} f)(x) = e^{\alpha D} \sum_{i=0}^\infty {a_i x^i} = \sum_{i=0}^\infty {a_i e^{\alpha D} x^i} = \sum_{i=0}^\infty {a_i (x+\alpha)^i} = f(x+\alpha) $$]
Así que la exponencial de la derivación no es más que una traslación.
Los físicos me dicen que acabo de descubrir que el operador de momento genera las traslaciones. ¡Vaya! Pues no lo sabía.
jueves, 26 de mayo de 2011
Espacios proyectivos
| Espacio Vectorial | Espacio Proyectivo |
| [$\mathbb{R}^2$] | [$P(\mathbb{R})$] |
| Los elementos de [$\mathbb{R}^2$], en coordenadas cartesianas, son pares de números reales [$(x,y)$] que representan puntos. | Los elementos de [$P(\mathbb{R})$], en coordenadas homogéneas, son pares de números reales [$(x,y)$] que representan rectas que pasan por el origen. |
 |  |
| Dos puntos [$P=(x,y)$] y [$P'=(x',y')$] son iguales si y sólo si [$$x=x',\ y=y'$$] y lo escribiremos [$P=P'$]. | Dos puntos [$P=(x,y)$] y [$P'=(x',y')$] están en la misma recta si y sólo si existe un [$k\in\mathbb{R}$] tal que [$$x=kx',\ y=ky'$$] y lo escribiremos [$P\equiv P'$]. |
| [$$\mathbb{R}^2=\{(x,y)∣x,y\in\mathbb{R}\}$$] | [$$P(\mathbb{R})=(\mathbb{R}^2-\{(0,0)\})/\equiv $$] Si [$x=y=0$] no tenemos una recta por eso se ha excluido el punto [$(0,0)$] que no forma una recta. |
| Cada punto tiene dos grados de libertad, la abscisa [$x$] y la ordenada [$y$]. | Cada recta sólo tiene un grado de libertad. La equivalencia entre rectas [$\equiv$] le quita un grado de libertad a [$(x,y)$] (precisamente, es el valor de [$k$] que hemos de hallar). |
| Usar una matriz para transformar puntos en otros genera aplicaciones lineales. [$$P'=AP$$] | Usar una matriz para transformar rectas en otras genera colineaciones. [$$P'≡AP$$] Es decir, existe un [$k\in\mathbb{R}$] tal que [$$P'=kAP$$] |
| Una matriz tiene cuatro grados de libertad cuando representa una aplicación lineal. | Una matriz tiene tres grados de libertad cuando representa una colineación. |
 |  |
| Si la matriz es regular (no singular, con determinante no nulo), la transformación lineal es invertible. | Si la matriz es regular, la colineación se denomina homografía y representa proyecciones cónicas. |
| Al ser invertible forma un grupo. Concretamente el [$GL(2,\mathbb{R})$]. | Al ser invertible forma un grupo. Concretamente el [$PGL(2,\mathbb{R})$]. |
Es posible y deseable normalizar los puntos. Una forma de hacerlo es elegir de cada recta el punto cuya última coordenada sea uno. En este caso [$y=1$]. [$$(x,y)≡k(x,y)=\frac{1}{y}(x,y)=(\frac{x}{y},1)$$] | |
Se comprueba con facilidad que esta normalización es una proyección perspectiva donde la línea [$y=1$] es el plano de proyección. | |
| Todo esto se puede extender a 3 dimensiones usando [$\mathbb{R}^3$]. | Todo esto se puede extender de proyectar en una línea en [$P(\mathbb{R})$] a proyectar en un plano en [$P^2(\mathbb{R})$]. Este plano sería, por ejemplo, la pantalla del monitor o el CCD de una cámara. |
lunes, 2 de mayo de 2011
La multiplicación de Gauss
¿Cómo realizar una multiplicación compleja usando sólo tres productos reales?
La multiplicación usual requiere cuatro:
[$$ (a+bi)(c+di) = ac-bd + (ad+bc)i $$]
El truco lo descubrió Gauss por 1805
[$$ ac-bd = ac +bc -bc -bd = c(a+b) - b(c+d) $$]
[$$ ad+bc = ad +ac-ac +bc = c(a+b) +a(d-c) $$]
Como vemos, se reusa la multiplicación [$c(a+b)$].
Esto me lleva a recordar el algoritmo de Strassen para multiplicar matrices, pero ese es otro tema.
La multiplicación usual requiere cuatro:
[$$ (a+bi)(c+di) = ac-bd + (ad+bc)i $$]
El truco lo descubrió Gauss por 1805
[$$ ac-bd = ac +bc -bc -bd = c(a+b) - b(c+d) $$]
[$$ ad+bc = ad +ac-ac +bc = c(a+b) +a(d-c) $$]
Como vemos, se reusa la multiplicación [$c(a+b)$].
Esto me lleva a recordar el algoritmo de Strassen para multiplicar matrices, pero ese es otro tema.
sábado, 23 de abril de 2011
Divisiones y módulos enteros
Supongamos que queremos saber si un número es impar. ¿Bastaría este código?
Veamos. Introducimos el valor 5, hacemos la división por 2 y obtenemos el resto 1. Efectivamente, es impar. Ahora introduzcamos el valor -3, hacemos la división por 2 y obtenemos ¿qué resto? En mi implementación obtengo -1. Eso es un problema, pero ¿por qué sale -1? ¿No debería salir 1?
El operador de módulo % está muy relacionado con la división entera. La división entera se define de la siguiente manera. Sean cuatro números enteros [$n, d, c$] y [$r$] que llamaremos dividendo, divisor, cociente y resto. Esos cuatro números cumplen la siguiente ecuación.
[$$ n = dc + r $$]
Si, además, imponemos la siguiente inecuación, el cociente y el resto son únicos para cada par de dividendo y divisor.
[$$ 0\le r \lt \left| d \right| $$]
Esto es, básicamente, la llamada división euclídea. Matemáticamente este procedimiento de división es muy interesante y tiene muchas propiedades, pero carece de otras. En concreto, con esta división entera multiplicar divisor y dividendo por menos uno altera el resultado.
[$$ \frac{a}{b} \ne \frac{-a}{-b} $$]
Se puede probar con, por ejemplo, [$ \frac{7}{3} $] el cociente será [$2$] y el resto [$1$] mientras que [$ \frac{-7}{-3} $] tiene cociente [$3$] y resto [$2$]. No puedo obtener cociente [$2$] porque el resto tiene que ser positivo.
Entonces, usemos una división más intuitiva. Por ejemplo, hacemos la división en los reales y luego redondeamos. Ahora bien, hay varios tipos de redondeo. Los más usuales son el redondeo por truncamiento, por defecto, por exceso y al entero más cercano (con varias estrategias de desempate).
Según usemos un tipo de división u otra, obtendremos el resto (es decir, el resultado del operador %) de una forma u otra, pero todas mediante la ecuación anterior para mantener consistencia. Despejamos de ella el resto y esa es nuestra definición del operador %.
[$$ n\%d = r = n - dc = n - d \left[ \frac{n}{d} \right] $$]
La división entre corchetes representa el cociente que cambiará según elijamos uno u otro redondeo. El resumen está en esta tabla.
Hay tres hechos importantes en esta tabla:
Nota: La división que utilizamos cuando usamos el AND binario (&) para calcular rápidamente un módulo [$ a\% 2^n = a \& (2^n -1) $] es o bien la por defecto o la euclídea (tanto el divisor como el resto son positivos en este caso).
Ahora sólo queda ver qué lenguaje de programación usa qué tipo de división y módulo. La siguiente tabla extraída de la Wikipedia lo lista.
También existe el mismo problema relacionado con la operación equivalente en los reales (flotantes). Esta es la tabla en este caso.
Bueno. Entonces. Al final. ¿Cómo sé si un número es impar o no? Lo mejor es aprovechar que el resto cero es igual en todas las implementaciones y hacer algo así.
bool impar(int n)
{
 return (n%2) == 1;
}
Veamos. Introducimos el valor 5, hacemos la división por 2 y obtenemos el resto 1. Efectivamente, es impar. Ahora introduzcamos el valor -3, hacemos la división por 2 y obtenemos ¿qué resto? En mi implementación obtengo -1. Eso es un problema, pero ¿por qué sale -1? ¿No debería salir 1?
El operador de módulo % está muy relacionado con la división entera. La división entera se define de la siguiente manera. Sean cuatro números enteros [$n, d, c$] y [$r$] que llamaremos dividendo, divisor, cociente y resto. Esos cuatro números cumplen la siguiente ecuación.
[$$ n = dc + r $$]
Si, además, imponemos la siguiente inecuación, el cociente y el resto son únicos para cada par de dividendo y divisor.
[$$ 0\le r \lt \left| d \right| $$]
Esto es, básicamente, la llamada división euclídea. Matemáticamente este procedimiento de división es muy interesante y tiene muchas propiedades, pero carece de otras. En concreto, con esta división entera multiplicar divisor y dividendo por menos uno altera el resultado.
[$$ \frac{a}{b} \ne \frac{-a}{-b} $$]
Se puede probar con, por ejemplo, [$ \frac{7}{3} $] el cociente será [$2$] y el resto [$1$] mientras que [$ \frac{-7}{-3} $] tiene cociente [$3$] y resto [$2$]. No puedo obtener cociente [$2$] porque el resto tiene que ser positivo.
Entonces, usemos una división más intuitiva. Por ejemplo, hacemos la división en los reales y luego redondeamos. Ahora bien, hay varios tipos de redondeo. Los más usuales son el redondeo por truncamiento, por defecto, por exceso y al entero más cercano (con varias estrategias de desempate).
Según usemos un tipo de división u otra, obtendremos el resto (es decir, el resultado del operador %) de una forma u otra, pero todas mediante la ecuación anterior para mantener consistencia. Despejamos de ella el resto y esa es nuestra definición del operador %.
[$$ n\%d = r = n - dc = n - d \left[ \frac{n}{d} \right] $$]
La división entre corchetes representa el cociente que cambiará según elijamos uno u otro redondeo. El resumen está en esta tabla.
| Redondeo por truncamiento | Redondeo por defecto | Redondeo por exceso | Redondeo al más cercano | División euclídea | |
|---|---|---|---|---|---|
| [$$\frac{3}{5}$$] | c=0 r=3 | c=0 r=3 | c=1 r=-2 | c=1 r=-2 | c=0 r=3 |
| [$$\frac{-3}{5}$$] | c=0 r=-3 | c=-1 r=2 | c=0 r=-3 | c=-1 r=2 | c=-1 r=2 |
| [$$\frac{3}{-5}$$] | c=0 r=3 | c=-1 r=-2 | c=0 r=3 | c=-1 r=-2 | c=0 r=3 |
| [$$\frac{-3}{-5}$$] | c=0 r=-3 | c=0 r=-3 | c=1 r=2 | c=1 r=2 | c=1 r=2 |
Hay tres hechos importantes en esta tabla:
- En el redondeo por truncamiento el signo del resto coincide con el signo del dividendo.
- En el redondeo por defecto el signo del resto coincide con el signo del divisor (y en el redondeo por exceso con su opuesto).
- En el redondeo al entero más cercano el resto es el más cercano a cero posible.
Nota: La división que utilizamos cuando usamos el AND binario (&) para calcular rápidamente un módulo [$ a\% 2^n = a \& (2^n -1) $] es o bien la por defecto o la euclídea (tanto el divisor como el resto son positivos en este caso).
Ahora sólo queda ver qué lenguaje de programación usa qué tipo de división y módulo. La siguiente tabla extraída de la Wikipedia lo lista.
| Lenguaje | Operador | El resultado tiene el mismo signo que |
|---|---|---|
| ActionScript | % | Dividendo |
| Ada | mod | Divisor |
| rem | Dividendo | |
| ASP | Mod | No definido |
| ALGOL-68 | %× | Euclídea |
| AMPL | mod | Dividendo |
| AppleScript | mod | Dividendo |
| BASIC | Mod | No definido |
| bc | % | Dividendo |
| bash | % | Dividendo |
| C (ISO 1990) | % | Depende de implementación |
| C (ISO 1999) | % | Dividendo |
| C++ | % | Depende de implementación |
| C# | % | Dividendo |
| CLARION | % | Dividendo |
| Clojure | mod | Divisor |
| ColdFusion | % | Dividendo |
| Common Lisp | mod | Divisor |
| rem | Dividendo | |
| D | % | Dividendo |
| Eiffel | \\ | Dividendo |
| Erlang | rem | Dividendo |
| Euphoria | mod | Divisor |
| remainder | Dividendo | |
| FileMaker | Mod | Divisor |
| Fortran | mod | Dividendo |
| modulo | Divisor | |
| GML (Game Maker) | mod | Dividendo |
| Go | % | Dividendo |
| Haskell | mod | Divisor |
| rem | Dividendo | |
| J | |~ | Divisor |
| Java | % | Dividendo |
| JavaScript | % | Dividendo |
| Just Basic | MOD | Dividendo |
| Lua 5 | % | Divisor |
| Lua 4 | mod(x,y) | Divisor |
| Liberty Basic | MOD | Dividendo |
| MathCad | mod(x,y) | Divisor |
| Maple (software) | e mod m | Divisor |
| Mathematica | Mod | Divisor |
| Microsoft Excel | =MOD() | Divisor |
| MATLAB | mod | Divisor |
| rem | Dividendo | |
| Oberon | MOD | Divisor |
| Objective Caml | mod | Dividendo |
| Occam | \ | Dividendo |
| Pascal (Delphi) | mod | Dividendo |
| Pascal (ISO-7185 and ISO-10206) | mod | Euclídea |
| Perl | % | Divisor |
| PHP | % | Dividendo |
| PL/I | mod | Divisor (ANSI PL/I) |
| PowerBuilder | mod(x,y) | ? |
| PowerShell | % | Dividendo |
| Prolog (ISO 1995) | mod | Divisor |
| rem | Dividendo | |
| Python | % | Divisor |
| RealBasic | MOD | Dividendo |
| R | %% | Divisor |
| RPG | %REM | Dividendo |
| Ruby | %, modulus() | Divisor |
| remainder() | Dividendo | |
| Scheme | modulo | Divisor |
| remainder | Dividendo | |
| Scheme R6RS | mod | Euclídea |
| mod0 | Más cercano a cero | |
| SenseTalk | modulo | Divisor |
| rem | Dividendo | |
| Smalltalk | \\ | Divisor |
| SQL (SQL:1999) | mod(x,y) | Dividendo |
| Standard ML | mod | Divisor |
| Int.rem | Dividendo | |
| Stata | mod(x,y) | Euclídea |
| Tcl | % | Divisor |
| Torque Game Engine | % | Dividendo |
| Turing (programming language) | mod | Divisor |
| Verilog (2001) | % | Dividendo |
| VHDL | mod | Divisor |
| rem | Dividendo | |
| Visual Basic | Mod | Dividendo |
| x86 Assembly | IDIV | Dividendo |
| ADEP_AUTO language | MODULO(x,y) | Divisor |
También existe el mismo problema relacionado con la operación equivalente en los reales (flotantes). Esta es la tabla en este caso.
| Lenguaje | Operador | El resultado tiene el mismo signo que |
|---|---|---|
| C (ISO 1990) | fmod | ? |
| C (ISO 1999) | fmod | Dividendo |
| remainder | Más cercano a cero | |
| C++ | std::fmod | ? |
| C# | % | Dividendo |
| D | % | ? |
| Common Lisp | mod | Divisor |
| rem | Dividendo | |
| Go | math.Fmod | Dividendo |
| Haskell (GHC) | Data.Fixed.mod' | Divisor |
| Java | % | Dividendo |
| JavaScript | % | Dividendo |
| Objective Caml | mod_float | Dividendo |
| Perl | POSIX::fmod | Dividendo |
| PHP | fmod | Dividendo |
| Python | % | Divisor |
| math.fmod | Dividendo | |
| Ruby | %, modulus() | Divisor |
| remainder() | Dividendo | |
| Scheme R6RS | flmod | Euclídea |
| flmod0 | Más cercano a cero | |
| Standard ML | Real.rem | Dividendo |
Bueno. Entonces. Al final. ¿Cómo sé si un número es impar o no? Lo mejor es aprovechar que el resto cero es igual en todas las implementaciones y hacer algo así.
bool impar(int n)
{
 return (n%2) != 0;
 }
Suscribirse a:
Entradas (Atom)
