Mostrando entradas con la etiqueta iteradores. Mostrar todas las entradas

domingo, 19 de mayo de 2013

Álgebras y coálgebras

He encontrado varias veces por Internet la pregunta de qué es un coálgebra y las respuestas han sido más o menos liosas. El motivo es que en computación al hablar de (co)álgebras nos referimos a las F-(co)álgebras. Lo que implica explicar qué es la F y esa F es un funtor. Un funtor es una operación en categorías y hay que introducir parte de la teoría de categorías para explicarlo.

Puede hacerse más simple.

El producto cartesiano generalizado

Estrictamente hablando el producto cartesiano es una operación entre dos conjuntos.[$$A\times B$$]El resultado es otro conjunto y sus elementos son los pares ordenados de forma que el primer elemento se obtenga del primer conjunto y el segundo elemento del segundo. En notación matemática:[$$A\times B = \{ (a,b) \mid a\in A, b\in B \}$$] Cuando hacemos dos productos cartesianos, surge la duda de si es asociativo o no.[$$A\times (B \times C) \overset{?}{=} (A\times B)\times C$$] En general el producto cartesiano no es asociativo, ya que [$(a,(b,c))\ne((a,b),c)$], pero nada impide usar un producto cartesiano generalizado (que escribiré entre paréntesis) en el cual el producto de tres conjuntos no sean pares, sino triplas. [$$(A\times B \times C) = \{ (a,b,c) \mid a\in A, b\in B, c\in C \}$$] El de cuatro conjuntos serían cuadruplas y el de [$n$] conjuntos lo que llamaremos [$n$]-tuplas. [$$(A_1\times\cdots\times A_n) = \{(a_1,\dots,a_n) \mid a_1\in A_1,\dots,a_n\in A_n \}$$] Usaremos este producto cartesiano generalizado.

Antes de acabar este apartado sólo resta destacar un caso particular. El del producto cartesiano de cero conjuntos. Llamaremos a este conjunto [$1$] y sólo contiene un elemento que es la tupla vacía [$()$].

Esta definición no debe ser extraña si seguimos la siguiente secuencia. [$$(A\times B \times C) = \{ (a,b,c) \mid a\in A, b\in B, c\in C \}$$][$$(A\times B) = \{ (a,b) \mid a\in A, b\in B \}$$][$$(A) = \{ (a) \mid a\in A \}$$][$$1 = \{ () \}$$]

Algebras

La idea de usar álgebras proviene de tomar un tipo de datos como sus valores y las operaciones que los construyen por inducción. Por ejemplo, en el caso de una lista, estos constructores serían.
  • La lista vacía. Lo que se ha venido a llamar la constante nil.
  • Añadir un elemento a la lista. Función que se llama cons.
Las constantes se expresan como funciones que no toman argumentos (mejor dicho, toman la tupla vacía), por lo que si la lista es de enteros y llamo al tipo de esta lista [int], el tipo de cada una de estas funciones sería: [$$nil : 1 \to [int]$$]Que no toma argumentos y devuelve la lista de enteros vacía y[$$cons : (int \times [int]) \to [int]$$]Que toma un entero y una lista de enteros y devuelve otra con este elemento añadido.

Teniendo en mente estas funciones, decimos que el tipo lista de enteros [int] no es más que el conjunto de sus valores (que llamaré [$A_{[int]}$]) y las dos funciones que los construyen por inducción. [$$(A_{[int]}, nil : 1\to[int] , cons : (int \times [int]) \to [int] )$$]Muy similar a, por ejemplo, un monoide [$$(M,e:1 \to M ,\otimes:(M\times M)\to M )$$] donde [$M$] son los elementos del monoide, [$e$] el elemento neutro y [$\otimes$] la operación interna. O a la definición de los números naturales[$$(N,cero:1\to N, suc:N \to N)$$] donde [$cero$] es la constante cero y [$suc$] la operación que obtiene el siguiente número natural (el sucesor).

Generalizando de nuevo, vemos que todas estas definiciones tienen siempre la misma estructura.[$$(A, f_1: X_1 \to A,\dots, f_n: X_n \to A)$$]Donde los [$X_i$] son productos cartesianos de conjuntos en los cuales puede estar el propio [$A$] o no.

Bien. Eso es un álgebra. Un conjunto y varias operaciones cuyo codominio es tal conjunto.

Coálgebras

En un coálgebra lo que tenemos es [$$(A, f_1: A\to X_1,\dots, f_n: A\to X_n)$$] En este caso las operaciones tienen el conjunto en su dominio.

¿Qué significado tiene esto?

Pensemos en una lista. La operación cons tomaba una lista y un elemento e introducía ese elemento en la lista.

cons(7,[1,2,3])=[7,1,2,3]
cons(9,[8,1,3])=[9,8,1,3]
cons(4,[])=[4]

El tipo de cons era [$(int\times [int])\to [int]$]. En una coálgebra la operación correspondiente (que llamaremos headtail) deberá tener el tipo [$[int]\to(int\times [int])$] lo que significa que de una lista obtenemos un elemento y otra lista. Una forma de ver esto es pensar que, en la coálgebra, la operación headtail extrae un elemento de la lista. En general, las operaciones de una coálgebra deshacen lo que los constructores hacían en las álgebras. Por esta razón a las operaciones de una coálgebra se las denomina destructores.

headtail([1,2,3])=(1,[2,3])
headtail ([8,1,3])=(8,[1,3])
headtail ([])=????

¿Qué pasó en este último ejemplo? ¿Es realmente headtail una función sobre las listas o sólo sobre las listas no vacías?

Existen dos respuestas aquí.

La primera respuesta es introducir los tipos suma. De esa manera, headtail podría devolver un error sumando el conjunto unidad al tipo de su codominio ([$headtail: [int]\to 1+(int\times [int])$]). Esto es dual a la agrupación de todas las operaciones del álgebra de la lista en una única operación sumando sus dominios ([$nilcons: 1+(int\times [int])\to [int]$]) y por esta vía definimos el funtor polinómico [$F X = 1+(X\times [X])$] y llegamos a las F-(co)álgebras que es de lo que realmente estamos hablando.

Aún introduciendo la posibilidad de que headtail acabe de leer una lista, no significa que lo haga. Usar coinducción permite trabajar con listas infinitas en las cuales siempre podemos ir extrayendo elementos. Esto nos lleva a...

La segunda respuesta es modificar nuestro tipo de datos y decir que no trabajamos con listas, sino con listas infinitas (los llamados streams). Como la lista es infinita, nunca va a estar vacía y siempre podremos usar headtail. Estos tipos de datos infinitos definidos por coálgebras y coinducción se denominan codatos. Son útiles para modelar, por ejemplo, la entrada del usuario que, en principio, nunca acaba.

miércoles, 11 de mayo de 2011

El punto de la pereza

Hace unos días Bob Harper, que defiende SML con uñas y dientes, se dedicó a atacar a los elitistas del Haskell. Su idea era muy sencilla: los tipos de Haskell no son inductivos. Voy a intentar explicar esto de forma sencilla.

Tipos inductivos

Son los tipos cuyos valores se construyen con unos valores bases y unos constructores. El caso arquetípico son los números naturales.
  • El 0 es un valor base.
  • El siguiente número natural S(n), es un constructor que, dado un número, construye otro.
Con esto y la inducción estructural tenemos los números naturales (y podemos demostrar propiedades sobre ellos).
  • El cero es 0
  • El uno es S(0)
  • El dos es S(S(0))
  • Y así.
También es posible usar como argumento de un constructor el valor de otro tipo. Este otro tipo será un parámetro del nuevo tipo. De esa manera aterrizamos en los tipos algebraicos. Por ejemplo, las listas de valores de un tipo T que llamaremos L(T) será.
  • La lista vacía [] es un valor base.
  • El constructor de lista  cons(V,R) toma un valor V de un tipo T y el resto de la lista R de tipo L(T).
Con esto y la inducción estructural, obtenemos las listas que queramos (y podemos demostrar propiedades sobre ellas).
  • Tomamos la lista vacía [] como valor base de una lista de enteros L(int)
  • Añadimos  un entero  cons(-3, [])
  • Añadimos otro entero  cons(7, cons(-3, []) )
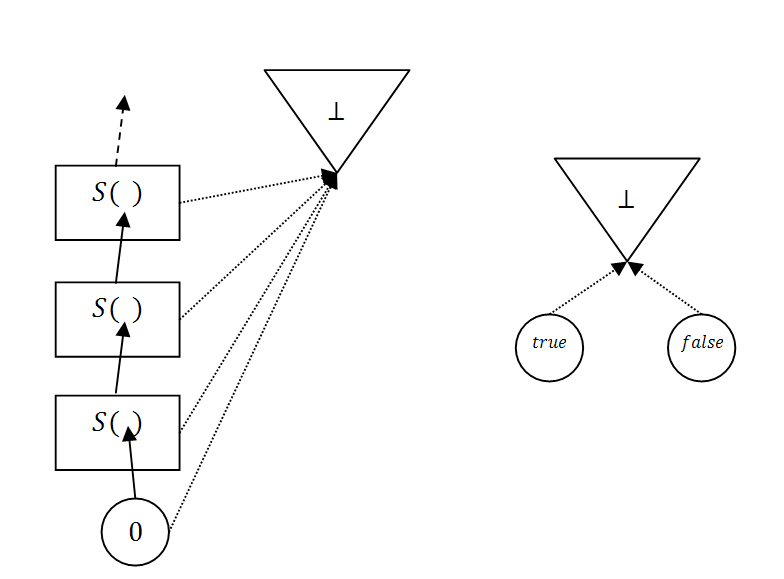
Todos estos tipos inductivos tienen una forma muy similar si se dibujan: son bosques de árboles (matemáticamente son órdenes parciales completos, también llamados dominios). En concreto, los números naturales son un árbol de una única rama.
Los números naturales son inductivos. El valor base es el 0, en un círculo, y el constructor es S(n), en rectángulos. De esta manera tenemos representados en la figura, de abajo arriba, los valores 0, S(0), S(S(0)), S(S(S(0))) y así sucesivamente.
Los booleanos son dos árboles sin ramas.
Los booleanos son dos valores base: true y false. No hay constructores. Estos tipos sin constructores suelen llamarse tipos enumerados.

Las listas de naturales son árboles con infinitas ramas ya que, cada vez que usamos un constructor con un natural distinto, generamos una nueva rama. Es difícil dibujar esto porque cada una de las infinitas ramas lleva a infinitos valores que, a su vez, vuelven a tener infinitas ramas. Con un poco de imaginación el diagrama sería algo así.
Lista de naturales. La lista vacía es el valor base [] que está abajo. A partir de él construimos infinitos valores, uno para cada natural. Serían las listas de un único natural. Asimismo, de cada uno de estos valores se obtienen otros infinitos valores. A este tipo de árboles infinitos pero con una estructura simple se los denomina árboles regulares.

Existen también los llamados tipos coinductivos en los cuales, en vez de tener una lista vacía (valores base) y usar constructores sobre ella, tenemos una lista llena (valores co-base) y usamos destructores (co-constructores) sobre ella. No hablaré mucho más de esto aquí.

Evaluación perezosa 

La evaluación perezosa, de la que hablamos alguna que otra vez, consiste básicamente en no evaluar hasta que no sea estrictamente necesario. Un caso clásico es la multiplicación por cero.

0*(7+5)

¿Para qué sumar siete y cinco si sabemos que al final la multiplicación va a ser cero? Bueno, existe un motivo por el que evaluar los argumentos y son los efectos laterales. Si en vez de sumar dos números imprimiésemos un mensaje, la cosa cambia.

0*(print "hola") 

Ahora sí que habría que imprimir "hola" aunque el resultado de esta multiplicación (si es que print devuelve un número, claro) sea cero. Pues bien, ocurre que en Haskell no hay efectos secundarios. Es un lenguaje funcional. En este lenguaje de programación sí que conviene no perder tiempo evaluando cosas que, al final, no se van a usar.

La idea fundamental de la crítica de Harper es que siempre existen los efectos secundarios. En concreto existe un efecto secundario que jamás puedes quitarte de encima en un lenguaje de programación Turing completo. Ese efecto es... que la computación no termine.

Imaginemos el siguiente programa:

f(x) = 1+f(x)  //Esta computación no termina 
0*f(3) 

Si el lenguaje es estricto y evalúa f(3), nunca llega a ejecutar la multiplicación. Si el lenguaje es perezoso y no evalúa f(3), la multiplicación ha aceptado un valor que no es un número (de hecho ni siquiera es un valor, es no terminación) y lo ha tratado como si fuera un número. ¿Cuál es el tipo del argumento que ha aceptado la multiplicación?

Los lenguajes con evaluación perezosa cuelan entre los valores de sus tipos la no terminación. O mejor dicho, algo todavía sin evaluar que puede ser no terminación o puede ser un valor concreto. Este valor tan especial que se puede convertir en otro (o no) se corresponde con el mínimo de un orden parcial completo con mínimo. Este mínimo tiene el nombre de "punto" y se suele representar con el símbolo [$\bot$].

Si añadimos el punto a los tipos inductivos el resultado es que ¡no son inductivos! Los naturales y los booleanos quedan algo así.
Los naturales y booleanos con punto. El punto representa la no evaluación (con la no terminación como posibilidad). El punto está más allá de la inducción. No se pueden usar técnicas inductivas para demostrar propiedades de él.
Esto rompe la posibilidad de usar la inducción estructural porque el punto queda más allá, más arriba, del resto de valores. Así que, según Harper, usar la evaluación perezosa es equivalente a olvidarse de la inducción estructural y, con ella, poder demostrar con facilidad múltiples propiedades en nuestro programa.

Epílogo

Por supuesto, esto es todo cuestión de compromisos. Usar evaluación perezosa abre la puerta a tener tipos coinductivos con mucha facilidad. De hecho la "lista llena" de la que hablé antes es precisamente el punto [$\bot$]. Una computación que puede no terminar, una lista infinita, de la cual vamos extrayendo valores, como los iteradores. Esto permite cosas nuevas como el uso de la composición en estos tipos coinductivos, lo que abre la posibilidad a la reutilización de código.

miércoles, 16 de marzo de 2011

Mónadas en un plis-plás

Como no hay blog de informática teórica que se precie sin un tutorial de mónadas, y aprovechando que Milewski está dedicándole unos posts a esto, voy a explicar cómo entendí lo de las mónadas (si es que lo entendí, claro).


De los efectos secundarios y de cómo evitarlos

Supongamos esta función.

int f(int x)
{
  a=x+2;
  return x*3;
}

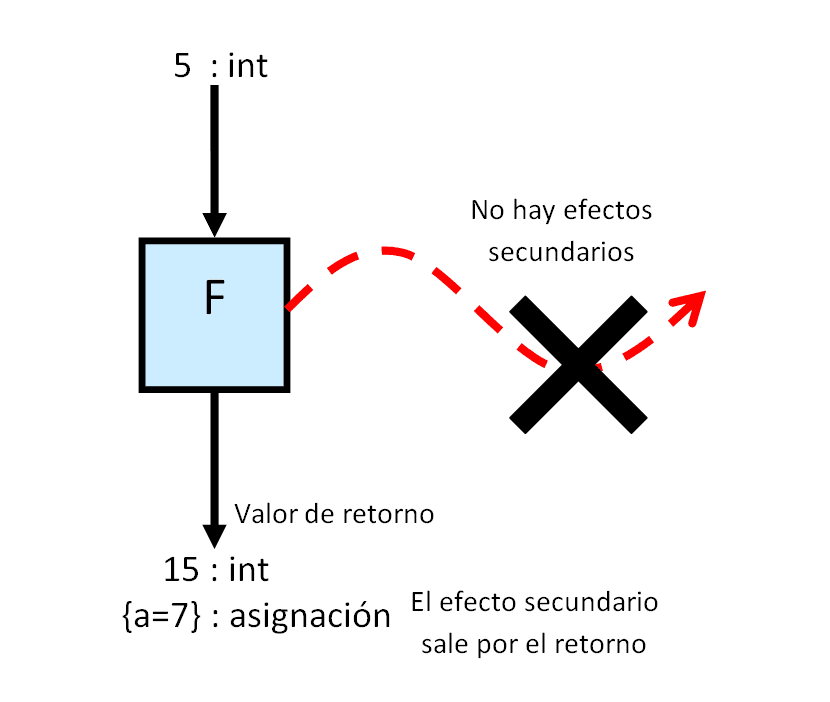
Realmente, está haciendo dos cosas: retornar el triple y asignar el argumento más dos a una variable externa “a”. Esta segunda acción es lo que se llama un efecto secundario porque modifica el estado global del programa. En este caso, el valor de “a”.


Muchas veces no es conveniente tener efectos secundarios: se simplifica la concurrencia, se permite la transparencia referencial, se permiten más optimizaciones, facilita la comprensión del programa, etc. Si queremos evitar que la función “f” tenga efectos secundarios la única solución es forzar a que éstos sean devueltos también por el retorno. Llamaremos a esta nueva función “F” para distinguirla de la original “f” con efectos secundarios.


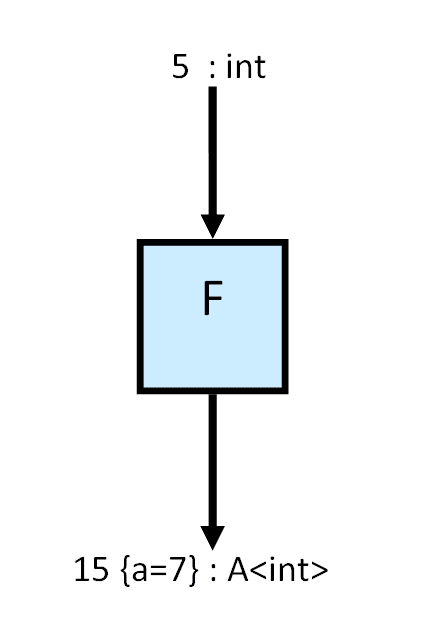
El problema ahora es que tenemos que devolver dos tipos. Además, no hemos dicho nada de que la función “f” pueda hacer más de una asignación. Tampoco hemos hablado de cómo cambia este nuevo retorno el estado global. Lo mejor es abstraernos de todos estos detalles y decir que “F” devuelve asignaciones y un entero. Inventaremos el tipo “A<int>” para eso usando un constructor de tipos "A".


Así que “F” vuelve a ser una función normal y corriente con un tipo a devolver exótico que engloba tanto el retorno normal (el entero) como los efectos secundarios (las asignaciones).

¡Pero hemos perdido una operación fundamental en la programación! ¿Cómo hacemos composiciones? ¿Cómo hacemos cosas como “f(f(5))”? Ahora que los tipos no coinciden, ¡no es posible escribir “F(F(5))”!


La solución pasa por hacer explícita la aplicación. ¿Pero qué es una aplicación explícita?


De la aplicación explícita y las restricciones que la composición le impone

En esta sección sólo hablaremos de cosas conocidas: funciones puras sin efectos secundarios. Llamaremos “g” y “h” a estas funciones puras. Nos olvidaremos por ahora del tipo “A<int>” y de las funciones “f” y “F” con efectos secundarios.

La aplicación explícita es sencillamente escribir “apply(x, g)” en vez de escribir “g(x)”.


Es únicamente un cambio en la notación, pero nos permite estudiar las propiedades de “apply” y realizar cosas tan potentes como la defuncionalización (de la que no hablaremos aquí). En concreto, para que “apply” sea coherente con la composición, debe mantener sus dos propiedades: elemento neutro y asociativa.

Para el elemento neutro hemos de introducir una función identidad. La llamaremos “id” y devuelve su argumento sin hacer nada de nada.

int id(int v) {return v;} //Función identidad de los enteros

Obviamente, componer esta función no debe hacer nada.

apply(x, id) == x
apply(id(x), g) == g(x)

Para la asociativa introduciremos una función compuesta “h” que aplique consecutivamente dos funciones “g1” y “g2”. En notación matemática escribiríamos [$h=g_2 \circ g_1$].

int h(int v) { return apply(g1(v), g2); }

Entonces, aplicar esta función compuesta “h” es igual que aplicar consecutivamente “g1” y “g2”.

apply(v, h) == apply(apply(v, g1), g2)

Con esto estamos seguros de que “apply” se comporta correctamente para la composición y podemos volver a pensar cómo solucionar el problema de la composición de la función “F”.

Nota: La propiedad asociativa aquí expuesta no parece ser la propiedad asociativa de toda la vida, pero si usamos “@” como operador infijo para el “apply” y la composición, entonces la propiedad queda algo así como “v@(g1@g2) = (v@g1)@g2” lo cual sí que se parece ya a la propiedad asociativa usual.

De la mezcla de efectos secundarios con aplicaciones explícitas

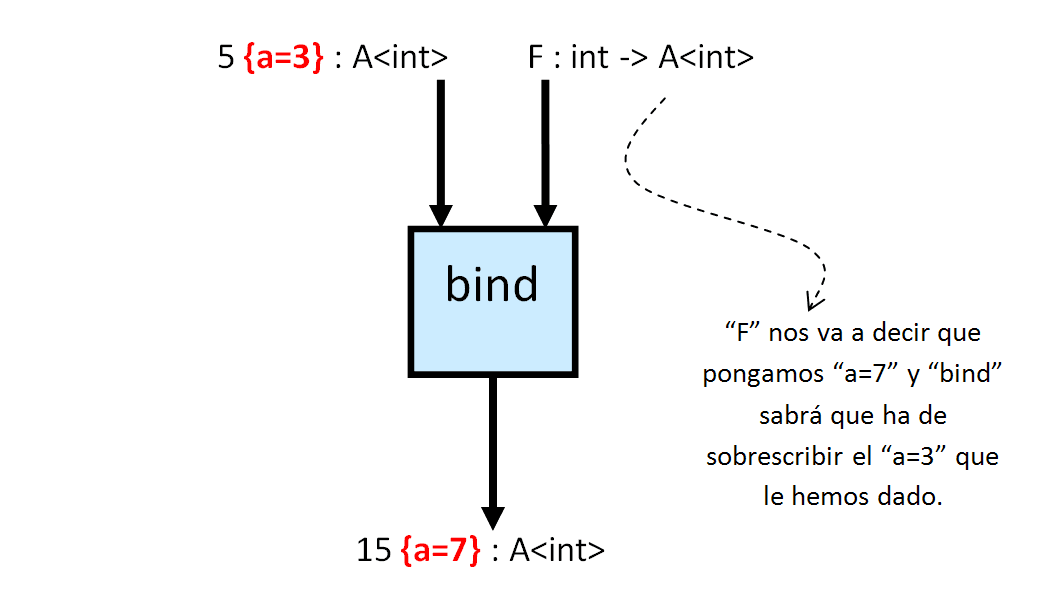
Lo interesante de hacer explícita la aplicación es que podemos adaptar el tipo de la misma a nuestros requisitos. Llamaremos “bind” a la aplicación con el tipo “A<int>” sobre funciones de tipo “int -> A<int>”, para no confundirla con “apply” que funciona sobre “int” y funciones “int -> int” únicamente.

apply: int -> (int->int) -> int
bind: A<int> -> (int -> A<int> ) -> A<int>


El truco está en que “bind(xx, F)” toma los efectos secundarios de “xx” y los mezcla con los efectos secundarios del resultado de “F” para luego devolverlos en su resultado.


Pero queda el asunto de la composición que nos forzó a introducir el “bind”: debe cumplir exactamente las mismas propiedades que “apply”.

La única salvedad es que “id” no debe ser la función identidad de los enteros. Tenemos que mantener el tipo “int -> A<int>” en las funciones. Así que se ha de convertir en una función que toma un entero y devuelve un “A<int>” de la manera más neutra posible. Es decir, sin efectos secundarios. También vamos a cambiar el nombre de esta función para no confundirla con la “id” original y la vamos a llamar “unit”.


Pues bien. Estas tres cosas son una mónada:
  • Un constructor de tipo como “A” que dado un tipo de retorno como “int” devuelve un tipo “A<int>” que engloba tanto ese tipo de retorno como los efectos secundarios.
  • Un par de funciones “bind” y “unit” que tienen los tipos antes mencionados.
  • Que se cumplan las propiedades de elemento neutro y asociativa.
Nota: El lector con conocimientos de álgebra habrá pensado “¿Elemento neutro y asociativa? ¿No era esto lo que definía un monoide? ¿Tiene que ver con el nombre de mónada?”. La respuesta es sí. Un monoide es lo que se forma con “int->int” donde el tipo de entrada es igual al tipo de salida. Una mónada es la generalización donde los tipos no son siempre iguales.

De los lugares en los que habitan las mónadas

La parquedad de los requisitos de las mónadas hace que aparezcan por todos los lados y no únicamente como modelo de efectos secundarios. Son en general un modelo de computación (ver ejemplo 1.1 en el articulo original de Moggi para una lista de cosas que puede modelar una mónada).

Por ejemplo, los punteros con NULL se usan generalmente como mónadas. El constructor de tipo está claro que es el de los punteros. De “int” pasamos a “int*”. La función “unit” es simplemente obtener la dirección de un entero.

int a;
int* p=&a; // p=unit(a)

La función “bind” consiste en comprobar que el puntero no es NULL.

return p==NULL ? NULL : p->OperaYDevuelvePuntero() ;
// return bind(p, OperaYDevuelvePuntero);

Es fácil comprobar las propiedades correspondientes con estas operaciones, pero aún hay más. Cualquier colección iterable es una mónada. Sí, así a lo bestia: vectores, conjuntos, listas, mapas, tablas hash, etc. Todos son mónadas. El constructor de tipo es el de la colección que queramos. Por ejemplo, “vector<int>”.

La función “unit” es bien sencilla: la colección con un único elemento.

vector<int> v;
v.push_back(3);
// v=unit(3)

La función “bind” es equivalente a iterar y mezclar.

vector<int> r;
foreach (x in v) r.append(Procesa(x));
// r=bind(v, Procesa)

Ojo que “Procesa” devuelve un vector y “append” mezcla vectores. Si “Procesa” fuera obtener la lista de divisores, entonces

bind([1, 6, 21], Procesa) = [1, 1, 2, 3, 6, 1, 3, 7, 21]

Esta propiedad del “bind” de separar, iterar y combinar es la que le da tanta utilidad. De hecho, debido a esto, “Procesa” también serviría para filtrar, transformar, unir y casi cualquier otra operación que se quiera realizar con la colección. Lo que no quita para que también la colección tenga sus operaciones propias no monádicas.


Pero con todo esto habría ya material para otra entrega en la que tendríamos que hablar de comprensiones monádicas, la notación “do” y empezar a usar muchas funciones anónimas.

miércoles, 10 de noviembre de 2010

Asincronía en C# 5.0

En octubre Eric Lippert empezó una serie en su blog dedicada a la nueva característica de C#: la posibilidad de escribir programas asíncronos. Es un paso lógico tras los cambios producidos en las versiones anteriores de C#.

¿Qué tienen en común las siguientes características de C#? (Todas convenientemente explicadas por Eric)
  1. Los iteradores
  2. Métodos anónimos
  3. LINQ
  4. Asincronía
Muy sencillo. Todas estas características se obtienen mediante una transformación sintáctica del código. Es decir. No hay una nueva semántica, sólo transformaciones sintácticas. ¿Y por qué es esto relevante? Porque se habrían evitado todo el follón si hubieran introducido un mecanismo de macros en el lenguaje. No algo tan crudo como el preprocesador de C. Quizás algo como los patrones de C++. O, mucho mejor, algo como las macros del LISP o Scheme.

Si es que al final volvemos al principio.

domingo, 9 de agosto de 2009

Punteros y demás hierbas

¿Qué maneras hay de referenciar un objeto en un programa? Que se me ocurran:

  • Referencia: Es la idea general de tener un valor que representa otra cosa. Realmente todos los mecanismos que vamos a ver son referencias. Nota: En algunos lenguajes como el C++ las referencias son concretamente una mezcla entre puntero y alias. 
  • Alias: Damos un nombre para el objeto. Usamos ese nombre para referenciarlo. Los alias no están reificados. Es decir, no existen durante la ejecución de un programa. Si así fuera, necesitaríamos algún tipo de almacén para guardar la relación nombre-objeto y estaríamos hablando de un identificador (ver más abajo). Entonces, un alias es un mecanismo externo al programa. Por ejemplo, los nombres de variables que viven en el compilador y se olvidan antes de llegar al programa ejecutable. Esta idea de "ser externo al programa" o "no sabido por el programa" lleva a la idea de alias como algo "no querido" que es el aliasing (múltiples referencias desconocidas para el mismo objeto).
  • Puntero: Es la dirección de memoria donde está el objeto. Generalmente los punteros son mala idea porque no abstraemos. Realmente nos da igual la dirección de memoria en concreto, lo que nos interesa es el objeto. Esto hace que haya limitaciones a la hora de usar el puntero. Por ejemplo, si el objeto se mueve a otra dirección de memoria, el puntero queda invalidado. El saber la dirección donde está el objeto significa que llegar a él es muy rápido. De complejidad O(1) (constante).
  • Índice: Si el objeto está en una colección lineal de objetos, se puede llegar al objeto en concreto sabiendo su posición dentro de la colección. Eso es el índice. En este caso no nos liamos con direcciones de memoria, aunque necesitamos una colección y que la colección esté ordenada de forma que podamos contar las posiciones. De hecho, nada impide que la colección esté en otro sitio en vez de memoria como un fichero en disco o en algún dispositivo de entrada/salida. Aunque, en general, se intenta que la complejidad de acceso al objeto sea O(1) (constante).
  • Identificador: Si el objeto está en un diccionario, se puede llegar al objeto en concreto sabiendo su clave dentro del diccionario. Eso es el identificador o asidor (handle) del objeto. Este identificador ya no tiene por qué ser numérico. Ahora puede ser un número (aunque no relacionado con una colección lineal), un nombre, una estructura compleja o cualquier cosa que sea comparable (y ordenable por motivos de eficiencia). Tampoco hay aquí problema con las relocalizaciones del objeto siempre y cuando se mantenga actualizado el diccionario. Eso sí, usualmente los identificadores tardan más en resolver la referencia (llegar al objeto) con una complejidad, en los casos usuales, de búsqueda en el diccionario. Sería O(log n) para árboles y O(n) amortizada para tablas hash.
  • Iterador: Es la abstracción de lo anterior. Un iterador es una posición, pero no de memoria. Es una posición abstracta. Podría ser un puntero, un índice, un identificador o cualquier otra cosa. El nombre de iterador proviene del hecho de que la operación más común que se suele realizar sobre él es "pasar a la siguiente posición" para recorrer colecciones (lo que se llama iterar). Sin embargo, su noción más abstracta es la de posición y existen iteradores que no iteran. Esta variedad hace que sea imposible dar una complejidad para los iteradores, cada tipo tendrá su complejidad a la hora de llegar al objeto que referencian.
  • Rangos: Extienen la idea de referencia a un objeto a referencias a colecciones de objeto. Como se sale un poco de la pregunta inicial, sólo dejaré constancia de su existencia.

sábado, 25 de julio de 2009

A vueltas con los rangos

Parece natural que, dado que una gran cantidad de algoritmos trabajan sobre una serie de datos, se realice una abstracción y lleguemos a la idea de rangos. Donde un rangos es una serie de datos.

Pero en la infomática seria las cosas no son tan fáciles y hay que definir la interfaz que tiene ese concepto. Es decir, qué operaciones se pueden realizar sobre los rangos y qué efecto tienen esas operaciones. Recientemente, en la BoostCon 2009, Alexandrescu dio una charla sobre las que él cree que serían esas operaciones básicas. Las transparencias de la charla están aquí y la interfaz que propone para los rangos (de entrada) es esta:

template struct InputRange {
bool empty() const;
void popFront();
T& front() const;
};


Esta simplicidad, y el hecho de que estén ya muy arraigados los iteradores, ha levantado una gran polvareda en la lista de desarrolladores de Boost. Rápidamente han salido detractores y defensores.

Particularmente, me parece una buena idea. Es otra abstracción y parece realmente versátil. Para algunas cosas valdrá y para otras tendrás que bajar al nivel de iteradores. Como siempre ha pasado en computación (y por eso aún hoy en día se usa el ensamblador.)