Mostrando entradas con la etiqueta rangos. Mostrar todas las entradas

jueves, 20 de enero de 2011

¿Secuencial o Paralelo?

Este es un resumen de la charla de Guy Steele sobre paralelismo en Strange Loop.

SECUENCIALPARALELO
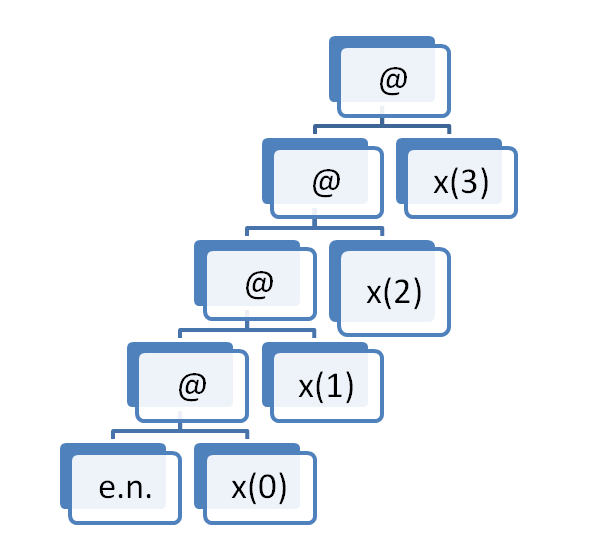
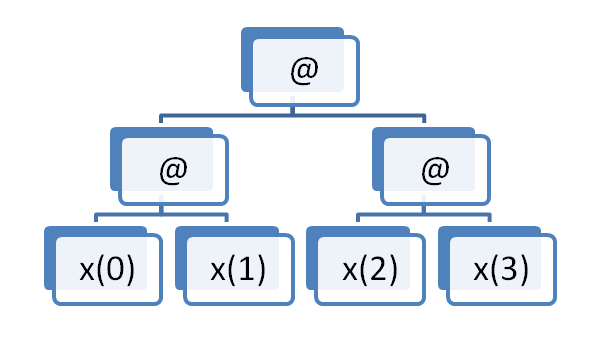
Se ejecuta un código A, luego se usa el resultado de A en otro código B.Se ejecutan los códigos A y B independientemente. Luego se mezclan los resultados.
Reusa el espacio. Sólo hay que almacenar un resultado.Usa espacio extra para desacoplar los cálculos.
Procesa una cosa cada vez y va acumulando resultados.Descompone y mezcla resultados. Divide y vencerás.
Requiere iniciar el acumulador con el elemento neutro de la operación.
acc=elem_neutro;
for(i=0; i<n; ++i)
   acc=acc @  x[i]
Requiere asociatividad en la operación para ir mezclando resultados. No se puede procesar en paralelo:
[$$ x_0 \star (x_1 \star (... )) $$]


Se basa en trucos para optimizar.
  • Reordenación de instrucciones.
  • Desplegado de bucles.
  • Reutilización de registros.
  • Ejecución especulativa.
  • Predicción de saltos.
  • etc. 
Se basa en propiedades algebraicas para optimizar.
  • Asociativa: La forma de agrupar operaciones no importa.
  • Conmutativa: El orden de los operandos no importa.
  • Idempotente: Las repeticiones no importan.
  • Identidad: El elemento neutro puede ser ignorado.
  • Cero: El resto de elementos puede ser ignorado. 

Así que hay que hacer que el programador deje de pensar en acumuladores y pase a pensar en propiedades algebraicas. Es decir, usar catamorfismos en vez de bucles. Los catamorfismos no son más que funciones que toman una estructura de datos y devuelven un valor a partir de ella con la propiedad de que son morfismos. En el caso de sumar una lista de números sería algo así como convertir la concatenación en suma.

[$$ f( [ 3, 5 ] .. [4, 7] ) = f( [3,5] ) + f( [4, 7] ) $$]

Esto significa a su vez que hay que buscar una operación con las propiedades algebraicas que deseemos (o podamos obtener), lo cual puede llevar a comprender más profundamente el problema.

La especificación del catamorfismo es similar al uso de sumatorios en matemáticas. No se especifica el orden de la suma, sólo que hay que sumar los elementos.

[$$ \sum_{i=1}^{n} {x_i} $$]

En programación esto se tendría que hacer usando funciones de alto nivel como fold pero asumiendo la asociatividad.

fold_assoc( suma, [3, 5, 4, 7] )

Así el compilador podría optimizar usando paralelismo sin que el programador tuviera que luchar con sincronizaciones y demás.

domingo, 9 de agosto de 2009

Punteros y demás hierbas

¿Qué maneras hay de referenciar un objeto en un programa? Que se me ocurran:

  • Referencia: Es la idea general de tener un valor que representa otra cosa. Realmente todos los mecanismos que vamos a ver son referencias. Nota: En algunos lenguajes como el C++ las referencias son concretamente una mezcla entre puntero y alias. 
  • Alias: Damos un nombre para el objeto. Usamos ese nombre para referenciarlo. Los alias no están reificados. Es decir, no existen durante la ejecución de un programa. Si así fuera, necesitaríamos algún tipo de almacén para guardar la relación nombre-objeto y estaríamos hablando de un identificador (ver más abajo). Entonces, un alias es un mecanismo externo al programa. Por ejemplo, los nombres de variables que viven en el compilador y se olvidan antes de llegar al programa ejecutable. Esta idea de "ser externo al programa" o "no sabido por el programa" lleva a la idea de alias como algo "no querido" que es el aliasing (múltiples referencias desconocidas para el mismo objeto).
  • Puntero: Es la dirección de memoria donde está el objeto. Generalmente los punteros son mala idea porque no abstraemos. Realmente nos da igual la dirección de memoria en concreto, lo que nos interesa es el objeto. Esto hace que haya limitaciones a la hora de usar el puntero. Por ejemplo, si el objeto se mueve a otra dirección de memoria, el puntero queda invalidado. El saber la dirección donde está el objeto significa que llegar a él es muy rápido. De complejidad O(1) (constante).
  • Índice: Si el objeto está en una colección lineal de objetos, se puede llegar al objeto en concreto sabiendo su posición dentro de la colección. Eso es el índice. En este caso no nos liamos con direcciones de memoria, aunque necesitamos una colección y que la colección esté ordenada de forma que podamos contar las posiciones. De hecho, nada impide que la colección esté en otro sitio en vez de memoria como un fichero en disco o en algún dispositivo de entrada/salida. Aunque, en general, se intenta que la complejidad de acceso al objeto sea O(1) (constante).
  • Identificador: Si el objeto está en un diccionario, se puede llegar al objeto en concreto sabiendo su clave dentro del diccionario. Eso es el identificador o asidor (handle) del objeto. Este identificador ya no tiene por qué ser numérico. Ahora puede ser un número (aunque no relacionado con una colección lineal), un nombre, una estructura compleja o cualquier cosa que sea comparable (y ordenable por motivos de eficiencia). Tampoco hay aquí problema con las relocalizaciones del objeto siempre y cuando se mantenga actualizado el diccionario. Eso sí, usualmente los identificadores tardan más en resolver la referencia (llegar al objeto) con una complejidad, en los casos usuales, de búsqueda en el diccionario. Sería O(log n) para árboles y O(n) amortizada para tablas hash.
  • Iterador: Es la abstracción de lo anterior. Un iterador es una posición, pero no de memoria. Es una posición abstracta. Podría ser un puntero, un índice, un identificador o cualquier otra cosa. El nombre de iterador proviene del hecho de que la operación más común que se suele realizar sobre él es "pasar a la siguiente posición" para recorrer colecciones (lo que se llama iterar). Sin embargo, su noción más abstracta es la de posición y existen iteradores que no iteran. Esta variedad hace que sea imposible dar una complejidad para los iteradores, cada tipo tendrá su complejidad a la hora de llegar al objeto que referencian.
  • Rangos: Extienen la idea de referencia a un objeto a referencias a colecciones de objeto. Como se sale un poco de la pregunta inicial, sólo dejaré constancia de su existencia.

sábado, 25 de julio de 2009

A vueltas con los rangos

Parece natural que, dado que una gran cantidad de algoritmos trabajan sobre una serie de datos, se realice una abstracción y lleguemos a la idea de rangos. Donde un rangos es una serie de datos.

Pero en la infomática seria las cosas no son tan fáciles y hay que definir la interfaz que tiene ese concepto. Es decir, qué operaciones se pueden realizar sobre los rangos y qué efecto tienen esas operaciones. Recientemente, en la BoostCon 2009, Alexandrescu dio una charla sobre las que él cree que serían esas operaciones básicas. Las transparencias de la charla están aquí y la interfaz que propone para los rangos (de entrada) es esta:

template struct InputRange {
bool empty() const;
void popFront();
T& front() const;
};


Esta simplicidad, y el hecho de que estén ya muy arraigados los iteradores, ha levantado una gran polvareda en la lista de desarrolladores de Boost. Rápidamente han salido detractores y defensores.

Particularmente, me parece una buena idea. Es otra abstracción y parece realmente versátil. Para algunas cosas valdrá y para otras tendrás que bajar al nivel de iteradores. Como siempre ha pasado en computación (y por eso aún hoy en día se usa el ensamblador.)