jueves, 10 de noviembre de 2011

Semántica natural de LISP - parte 2 - LISP imperativo

En la primera parte de esta serie homenaje a John McCarthy vimos una semántica de LISP sin permitir la modificación ni de los valores ni de las vinculaciones. Era un LISP funcional. En esta parte vamos a introducir esa posibilidad. Es por tanto un LISP imperativo.

La memoria y los contextos

En el momento que introducimos cambios, hemos de manejar estados. El estado con el que trabajaremos será la memoria [$M$]. Esta memoria será el conjunto libremente generado por [$$M::= \emptyset \mid M,m\Leftarrow c$$] Los identificadores [$m$] son las direcciones de memoria y los objetos sintácticos [$c$] son las celdas con el contenido de esa dirección. Veremos la sintaxis de las celdas más abajo.

Usaremos también los identificadores [$E$] como sinónimos a [$m$]. No son una nueva categoría, son la misma categoría sintáctica. Simplemente, vamos a usar [$E$] cuando hablemos de posiciones de memoria que guardan entornos. Esto nos hará mucho más legibles las ecuaciones y reglas a continuación.

Si bien recuerda el lector de la primera parte, esta definición de [$M$] es muy similar a la definición de contexto [$C$] que teníamos. Esta vez, nuestro contexto no podrá tener valores porque todo hemos de guardarlo en la memoria para que pueda ser modificado. Así pues, nuestro contexto ahora será [$$C::=\emptyset \mid C,x\leftarrow m$$] Donde [$x$] son los identificadores de variable.

Operaciones sobre memoria y contextos

Debido a la similitud entre la sintaxis de memoria y contexto, vamos a dar sus operaciones a la vez. La primera operación es el dominio que nos indica qué posiciones de memoria o qué identificadores de variable están en uso.

En primer lugar, la memoria vacía o el contexto vacío tienen un dominio vacío.
[$$dom(\emptyset)=\emptyset$$][$$dom(\emptyset)=\emptyset$$]
Para continuar, el dominio de la memoria o el contexto más una asignación de memoria o vinculación de variable se calcula recursivamente.
[$$dom(M,m\Leftarrow c)=dom(M)\cup\{m\}$$][$$dom(C,x\leftarrow m)=dom(C)\cup\{x\}$$]

La siguiente operación que vamos a especificar es la pertenencia a memoria o a contexto. El caso base es cuando la propia asignación o vinculación está en la parte más externa de la memoria o contexto.
[$$(m\Leftarrow c)\in(M,m\Leftarrow c)$$][$$  (x\leftarrow m)\in(M,x\leftarrow m)  $$]
El caso recursivo ocurre cuando no se encuentra en esa posición externa.
[$$\frac{m\ne m'\;\;\;\;\;\;  (m\Leftarrow c)\in M}{(m\Leftarrow c)\in(M,m'\Leftarrow c')}$$][$$\frac{x\ne x'\;\;\;\;\;\;(x\leftarrow c)\in C}{(x\leftarrow m)\in(C,x'\leftarrow m')}$$]

Finalmente, y dado que estamos hablando de mutaciones de memoria, tendremos que introducir las operaciones de cambio de memoria y de contexto. Es similar a la pertenencia, pero con una comprobación extra por si la dirección de memoria o variable que queremos modificar no está usada y, por tanto, hay que añadirla. Empecemos por esta regla extra.
[$$\frac{m\notin dom(M)}{M\langle m\Leftarrow c\rangle=M,m\Leftarrow c}$$][$$  \frac{x\notin dom(C)}{C\langle x\leftarrow m\rangle=C,x\leftarrow m}$$]
 Cuando lo que queremos cambiar sí está en el dominio, hemos de buscarlo y cambiarlo.
[$$(M,m\Leftarrow c)  \langle m\Leftarrow c'\rangle= (M,m\Leftarrow c') $$][$$  (M,x\leftarrow m)   \langle x\leftarrow m'\rangle =   (M,x\leftarrow m')    $$]
[$$\frac{m\ne m'\;\;\;\;\;\;  m' \in dom(M)}{  (M,m\Leftarrow c)\langle m'\Leftarrow c' \rangle =   (M \langle m'\Leftarrow c' \rangle ,m\Leftarrow c)  }$$][$$\frac{x\ne x'\;\;\;\;\;\; x'\in dom(C)}{(C,x\leftarrow m)\langle x'\leftarrow m'\rangle =   (C \langle x'\leftarrow m'\rangle ,x\leftarrow m)   }$$]


Celdas y entornos

Las celdas van a contener los valores del LISP funcional. Además, dado que las vinculaciones de variables van a poder ser modificadas, también vamos a introducir en ellas a los contextos. Su sintaxis es la que sigue [$$c::= l \mid x \mid (m.m) \mid \lambda^Emm \mid |p| \mid C $$] Es decir, que una celda podrá ser o bien un literal [$l$], o bien una variable [$x$], o bien un par [$(m.m)$], o bien una clausura [$\lambda^Emm$], o bien un valor predefinido [$|p|$], o bien un contexto [$C$]. Recordemos que la [$E$] no es más que una dirección de memoria como las [$m$].

Dentro de los literales incluimos la lista vacía que escribiremos [$()$]. Una lista de contextos es un entorno. La operación más importante en los entornos es la búsqueda de la vinculación de una variable. Lo haremos buscando en el contexto en posición de cabeza de la lista y luego, si no se encuentra, usando la recursión en el resto de la lista. Bastan dos reglas para realizar este procedimiento. 
[$$\frac{E\Leftarrow(m'.E')\in M\;\;\;\;\;\;m'\Leftarrow C\in M\;\;\;\;\;\;x\leftarrow m\in C}{x\leftarrow m\in_M E}$$]
[$$\frac{  E\Leftarrow(m'.E')\in M\;\;\;\;\;\;m'\Leftarrow C\in M\;\;\;\;\;\;x\leftarrow m\notin C \;\;\;\;\;\;  x \leftarrow m \in_M E' }{ x\leftarrow m\in_M E }$$]
Las dos reglas de arriba son muy similares. Primero, en ambas reglas, se comprueba que la dirección de memoria [$E$] sea un par y que su primer campo [$m'$] apunte a un contexto [$C$]. Luego, si encontramos la variable en [$C$], ahí está (primera regla) y, si no la encontramos, buscamos en el resto de la lista [$E'$] que es el llamado entorno padre (segunda regla).

Otra operación muy simple, y que más que nada es una abreviatura, es la introducción de un nuevo contexto en un entorno.[$$\frac{m' \notin dom(M)\cup\{m\}}{M\triangleright E\Leftarrow C\mid E' \triangleright M,m'\Leftarrow C, E\Leftarrow (m',E')}$$] Para empezar, usaremos [$M\triangleright$] a la izquierda y [$\triangleright M'$] a la derecha de un juicio cuando quiera indicar que la memoria [$M$] se cambia y como resultado obtenemos la memoria [$M'$]. En este caso, leemos el consecuente como "dada la memoria [$M$], obtengo el entorno [$E$] al introducir un nuevo contexto [$C$] en el entorno padre [$E'$] y la memoria con estos cambios es todo lo que hay a la derecha del [$\triangleright$]".

Relaciones auxiliares de evaluación

En la primera parte introdujimos un par de relaciones auxiliares de evaluación: la desestructuración o ajuste de patrones y el envoltorio. Hemos de adaptar ambas a la introducción de la memoria. Ahora hemos de explorar la memoria en vez de explorar valores. Todo esto hace las reglas un poco más largas, pero en el fondo son exactamente las mismas.

El ajuste de patrones sigue teniendo tres reglas: para literales (la llamaremos P-LIT), para variables (P-VAR) y para pares (P-PAIR).
   
[$$\frac{m\Leftarrow l\in M\;\;\;\;\;\;m'\Leftarrow l\in M}{C\{m\mid m'\}_M=C}$$]
[$$\frac{m\Leftarrow x\in M\;\;\;\;\;\; x\notin dom(C)}{C\{m\mid m'\}_M=(C,x\leftarrow m')}$$]
[$$\frac{m\Leftarrow (m_1.m_2)\in M\;\;\;\;\;\;m'\Leftarrow (m'_1.m'_2)\in M}{C\{m\mid m'\}_M=  C\{m_1\mid m'_1\}_M   \{m_2\mid m'_2\}_M   }$$]


El envoltorio sigue teniendo sus dos reglas: para la lista vacía (la llamaremos W-EMPTY) y para el par (W-PAIR). Esta vez se complica un poco más porque hemos de acarrear las memorias de una evaluación a la siguiente. De esta forma los cambios en la primera evaluación afectan a la segunda evaluación. 
[$$\frac{m\Leftarrow ()\in M}{M\triangleright E \vdash m \Downarrow m \triangleright M}$$]
[$$\frac{m\Leftarrow (m_1.m_2)\in M\;\;\;\;\;\; M\triangleright E \vdash m_1 \downarrow m_1' \triangleright M_1 \;\;\;\;\;\;    M_1\triangleright E \vdash m_2 \Downarrow m_2' \triangleright M_2 \;\;\;\;\;\;\; m' \notin dom(M_2)  }{  M\triangleright E \vdash m \Downarrow m' \triangleright M_2,m'\Leftarrow(m'_1.m'_2) } $$]
 En definitiva, lo que hace el envoltorio es evaluar los operandos para obtener los argumentos. En el proceso crea una lista de argumentos.


La evaluación

Ya tenemos todo lo necesario para la evaluación. Es exactamente igual que la evaluación en la versión funcional sólo que acarreando memorias de una evaluación a la siguiente y usando entornos en vez de contextos.

 
[$$\frac{m\Leftarrow l\in M}{M\triangleright E\vdash m\downarrow m \triangleright M}$$]
La primera regla, que sigue siendo E-LIT, mira lo que hay en la dirección de memoria [$m$] y, si es un literal [$l$], devuelve la propia dirección de memoria como su resultado. Eso significa que el resultado de evaluar un literal es él mismo.
[$$  \frac{m\Leftarrow x\in M\;\;\;\;\;\; x\leftarrow m'\in_M E}{M\triangleright E \vdash m \downarrow m' \triangleright M}  $$]
Esta segunda regla, E-VAR, mira lo que hay en la dirección de memoria y, si es una variable [$x$], busca su vinculación [$m'$] en el entorno [$E$] y devuelve esa vinculación. En ninguna de estas dos reglas se modifica la memoria.
 
[$$  \frac{\begin{array}{c}m\Leftarrow(m_1.m_2)\in M\;\;\;\;\;\;M\triangleright E\vdash m_1 \downarrow m'_1 \triangleright M_1 \;\;\;\;\;\; m'_1 \Leftarrow |p|\in M_1 \\  M_1 \triangleright E \vdash |p|m_2 \rightarrow_\delta m'_2 \triangleright M' \end{array}}{  M\triangleright E \vdash m \downarrow m' \triangleright M'  }  $$]
La regla E-PRE, que trata con los valores predefinidos, es algo más compleja. Primero, la regla observa que [$m$] apunta a un par [$(m_1.m_2)$] en la memoria. Eso significa que hay una combinación y hemos de evaluarla. Evalúa el operador [$m_1$] y observa que su resultado [$m'_1$] apunta a un valor predefinido [$|p|$]. Además, hemos modificado la memoria al evaluar el operador y hemos de buscar en [$M_1$]. Una vez que sabemos que es un valor predefinido, delegamos toda evaluación a la relación delta [$\rightarrow_\delta$] que se encarga de los valores predefinidos. La especificaremos más adelante.
[$$ \frac{  \begin{array}{c}m\Leftarrow(m_1.m_2)\in M\;\;\;\;\;\;M\triangleright E\vdash m_1 \downarrow m'_1 \triangleright M_1 \;\;\;\;\;\; m'_1 \Leftarrow \lambda^{E_c}m_f m_b\in M_1 \\ M_1 \triangleright E \vdash m_2 \Downarrow m'_2 \triangleright M_2 \;\;\;\;\;\;  M_2 \triangleright E' \Leftarrow \emptyset\{m_f \mid m'_2 \}_{M_2} \mid E_c \triangleright M_3 \;\;\;\;\;\;  M_3 \triangleright E' \vdash m_b \downarrow m' \triangleright M' \end{array}}{ M\triangleright E \vdash m \downarrow m' \triangleright M' } $$]
 La última regla, E-APP, es la más compleja y usa prácticamente todas las relaciones auxiliares vistas hasta ahora. Explicaremos lo que hace paso a paso:
  1. Los tres primeros antecedentes son exactamente iguales que los de la regla E-PRE. Es decir, comprobamos que es un par, evaluamos el primer componente y descubrimos que es, en este caso, una clausura con entorno de clausura en la dirección de memoria [$E_c$] con parámetros formales en la dirección de memoria [$m_f$] y el código a ejecutar en la dirección de memoria [$m_b$].
  2. A continuación, evaluamos los operandos para obtener los argumentos. Esto es justamente lo que hace la relación de envoltorio. Es el primer antecedente de la segunda fila.
  3. Una vez que tenemos los argumentos, usamos ajuste de patrones para generar un contexto en el cual estén vinculadas las variables de los parámetros formales [$m_f$] a los argumentos [$m'_2$]. Esta parte es [$\emptyset\{m_f\mid m'_2\}_{M_2}$].
  4. Luego, ese contexto se introduce en un nuevo entorno [$E'$] usando como entorno padre el [$E_c$] para obtener la memoria [$M_3$]. Es lo que hace [$ M_2 \triangleright E' \Leftarrow \emptyset\{m_f \mid m'_2 \}_{M_2} \mid E_c \triangleright M_3 $]
  5. Entonces, tenemos en la dirección de memoria [$E'$] el entorno donde evaluar el cuerpo de la clausura y obtener el resultado [$m'$] junto con la memoria final [$M'$]. Es lo que hace el último antecedente.
Para ver cómo funciona todo esto, haremos un ejemplo de evaluación.

Ejemplo de evaluación

Aunque va a ser un ejemplo muy simple, la memoria va a estar bastante llena. Para no liarnos voy a usar como identificadores de memoria los valores de la semántica funcional entre corchetes. De esta forma entendemos mejor qué hay en la dirección de memoria [$m_4$] si en vez de escribir [$m_4$] escribo [$[\lambda^{C_0}((x.y))x]$].

Entonces, nuestra memoria [$M_0$] va a ser la siguiente.


[$[C_0]$][$\Leftarrow$][$list\leftarrow [\lambda^{(C_0)}xx], car\leftarrow [\lambda^{(C_0)}((x.y))x] $]
[$ [\lambda^{(C_0)}xx] $][$\Leftarrow$][$ \lambda^{[(C_0)]}[x][x]$]
[$ [x] $][$\Leftarrow$][$x$]
[$ [\lambda^{(C_0)}((x.y))x] $][$\Leftarrow$][$\lambda^{[(C_0)]}[((x.y))][x]$]
[$ [((x.y))] $][$\Leftarrow$][$([(x.y)].[()])$]
[$ [(x.y)] $][$\Leftarrow$][$([x].[y])$]
[$ [y] $][$\Leftarrow$][$y$]
[$ [(car\ (list\ 1\ 2))] $][$\Leftarrow$][$([car].[((list\ 1\ 2))])$]
[$ [car] $][$\Leftarrow$][$car$]
[$ [((list\ 1\ 2))] $][$\Leftarrow$][$([(list\ 1\ 2)].[()])$]
[$ [(list\ 1\ 2)] $][$\Leftarrow$][$([list].[(1\ 2)])$]
[$ [()] $][$\Leftarrow$][$()$]
[$ [list] $][$\Leftarrow$][$list$]
[$ [(1\ 2)] $][$\Leftarrow$][$([1].[(2)])$]
[$ [1] $][$\Leftarrow$][$1$]
[$ [(2)] $][$\Leftarrow$][$([2].[()])$]
[$ [2] $][$\Leftarrow$][$2$]
[$ [(C_0)] $][$\Leftarrow$][$([C_0].[()])$]

Ahora vamos a querer evaluar la dirección de memoria [$m=[(car\ (list\ 1\ 2))]$] en el entorno [$E_0=[(C_0)]$] y usando la memoria [$M_0$]. Necesitaremos hallar los interrogantes de [$$ M_0\triangleright E_0 \vdash m \downarrow\ ????\ \triangleright\ ????$$] Deberemos proceder con la regla E-APP en la cual encontramos que [$[(car\ (list\ 1\ 2))]\Leftarrow ([car].[((list\ 1\ 2))])\in M_0$] Entonces, [$m_1=[car]$] y hemos de evaluar [$$ M_0 \triangleright E_0 \vdash m_1 \downarrow\ ????\ \triangleright\ ????$$] Hay que aplicar la regla E-VAR en la cual obtenemos como resultado la dirección de memoria [$[\lambda^{(C_0)}((x.y))(x)]$].

A continuación hemos de realizar el envoltorio. Aparcamos E-APP(car). Ahora, como [$[((list\ 1\ 2))]\Leftarrow ([(list\ 1\ 2).[()]) \in M_0$] es un par, hay que entrar en W-PAIR. Nos dice que evaluemos el primer componente del par que es[$[(list\ 1\ 2)]$]. Tendremos que usar E-APP otra vez.

Aparcamos W-PAIR(car) y E-APP(car) para entrar en E-APP(list). Como [$[(list\ 1\ 2)]\Leftarrow ([list].[(1\ 2)]) \in M_0$], la regla E-APP me dice que evalúe el primer componente del par. En este caso [$[list]$]. Aplicando E-VAR obtenemos que el resultado es la celda [$\lambda^{[(C_0)]}[x][x]$] y tengo que entrar en envoltorio otra vez.

Tenemos en suspenso E-APP(list), W-PAIR(car) y E-APP(car). Y estamos trabajando con W-PAIR para envolver [$[(1\ 2)]\Leftarrow ([1].[(2)])\in M_0$]. Esta regla me dice que evalúe el primer componente que por E-LIT es él mismo [$[1]$] y que vuelva a aplicar el envoltorio sobre el segundo componente [$[(2)]$]. Aparco este W-PAIR(1) y voy con W-PAIR otra vez.

En este punto están en suspenso W-PAIR(1), E-APP(list), W-PAIR(car) y E-APP(car). Seguimos trabajando con la memoria [$M_0$] y hemos de aplicar W-PAIR a [$[(2)]\Leftarrow ([2].[()])\in M_0$]. El resultado es que [$[2]$] se evalúa por E-LIT a él mismo y W-EMPTY me devuelve el propio [$[()]$].

Ahora ocurre una cosa muy importante. La regla W-PAIR modifica la memoria. Añade un par en una nueva dirección. El primer componente del par es el resultado de la evaluación del primer componente, que era [$[2]$] y el segundo, el del envoltorio, que era [$[()]$]. Entonces, mi nueva memoria será [$$M_1=M_0,m_0\Leftarrow ([2].[()])$$] y el resultado de W-PAIR es [$$ M_0 \triangleright E_0 \vdash [(2)] \Downarrow m_0 \triangleright M_1$$] Este cambio de memoria es importante porque ahora recuperamos W-PAIR(1) y usa [$M_1$] en vez de [$M_0$].

Nota: Escribo [$m_0$] en vez de [$[(2)]$] porque [$[(2)]$] ya está usado en [$M_0$] y se confundiría. Tenemos dos celdas con el mismo contenido en memoria.

Retomamos W_PAIR(1) y sigue en suspenso E-APP(list), W-PAIR(car) y E-APP(car). La regla W_PAIR vuelve a modificar la memoria. En este caso [$$M_2=M_1,m_1\Leftarrow ([1].m_0)$$] y lo que hemos demostrado es [$$ M_0 \triangleright E_0 \vdash [(1\ 2)] \Downarrow m_1 \triangleright M_2$$].

Retomamos E-APP(list) y sigue en suspenso W-PAIR(car) y E-APP(car). El siguiente antecedente de la regla E-APP es el que realiza el ajuste de patrones. En este caso hemos de ajustar [$\emptyset\{[x]\mid m_2\}_{M_2}$]. Es sencillo usando la regla P-VAR. El ajuste devuelve el contexto [$C_1=x\leftarrow m_2$].

A continuación, la regla E-APP introduce el nuevo contexto [$C_1$] en la memoria. La nueva memoria es [$$M_3=M_2, [C_1]\Leftarrow C_1, [(C_1 C_0)]\Leftarrow ([C_1].[(C_0)]$$] y el nuevo entorno está en [$[(C_1 C_0)]$]. En este nuevo entorno y con esta nueva memoria evaluamos el cuerpo de la clausura que era [$[x]$]. Usamos para ello la regla E-VAR y encontramos que [$x\leftarrow m_2 \in_{M_3} [(C_1 C_2)]$] por lo que el resultado es [$m_2$] con la propia memoria [$M_3$]. Entonces lo que hemos demostrado hasta ahora es que [$$ M_0 \triangleright E_0 \vdash [(list\ 1\ 2)] \downarrow m_2 \triangleright M_3 $$]

Retomemos W-PAIR(car) y mantengamos en suspenso E-APP(car). La regla W-PAIR, tras evaluar el primer componente del par, envuelve el segundo. Usando la regla W-EMPTY obtenemos [$[()]$] como resultado de este envoltorio. A continuación, modifica la memoria incluyendo un nuevo par en [$m_3$] con ambos resultados. Es decir que [$M_4=M_2,m_3\Leftarrow (m_2.[()])$] y hemos demostrado que [$$ M_0 \triangleright E_0 \vdash [((list\ 1\ 2))] \Downarrow m_3 \triangleright M_4$$]

Retomamos, por fin, E-APP(car). Hemos de realizar primero el ajuste de patrones en el cual obtenemos el contexto [$C_2=x\leftarrow [1],y\leftarrow m_1$]. Luego, incluimos un nuevo entorno en la memoria con ese contexto y con entorno padre el de la clausura. [$$M_5=M_4, [C_2]\Leftarrow C_2, [(C_2 C_0)]\Leftarrow ([C_2].[(C_0)])$$] Y, finalmente, evaluamos el cuerpo de la clausura. Es sencillo porque consta únicamente de una variable y aplicamos E-VAR. Demostramos, por fin, que [$$M_0 \triangleright E_0 \vdash [(car\ (list\ 1\ 2))] \downarrow [1] \triangleright M_5$$]

Valores predefinidos y formas especiales

Especificaremos muy pocas formas predefinidas. La más usual en un lenguaje imperativo es la evaluación en secuencia. Usaremos el valor predefinido [$|begin|$] para esta evaluación. Necesitamos tres reglas. La primera dice que la evaluación en secuencia de la lista vacía es la propia lista vacía.[$$\frac{m\Leftarrow ()\in M}{M\triangleright E \vdash |begin|m \rightarrow_\delta m \triangleright M}$$] La segunda regla indica que si la lista a evaluar en secuencia sólo tiene un elemento, el resultado es la evaluación de ese elemento. [$$\frac{m\Leftarrow (m_1.m_2)\in M \;\;\;\;\;\; m_2\Leftarrow () \in M \;\;\;\;\;\; M \triangleright E \vdash m_1 \downarrow m' \triangleright M'}{M\triangleright E \vdash m \rightarrow_\delta m' \triangleright M'}$$]Finalmente, si hay más de un elemento, evaluamos el primero y evaluamos en secuencia el resto.[$$\frac{m\Leftarrow (m_1.m_2)\in M \;\;\;\;\;\; m_2\Leftarrow () \notin M \;\;\;\;\;\; M \triangleright E \vdash m_1 \downarrow m'_1 \triangleright M_1 \;\;\;\;\;\; M_1 \triangleright E \vdash |begin|m_2 \rightarrow_\delta m' \triangleright M'}{M\triangleright E \vdash m \rightarrow_\delta m' \triangleright M'}$$]

Para definir una vinculación usamos el valor predefinido [$|def!|$].[$$\frac{m\Leftarrow (m_1.m_2) \in M \;\;\;\;\;\; m_1 \Leftarrow x \in M \;\;\;\;\;\; M \triangleright E \vdash |begin|m_2 \rightarrow_\delta m' \triangleright M'}{ M\triangleright E \vdash |def!|m \rightarrow_\delta m' \triangleright M' \langle E \Leftarrow x \leftarrow m'\rangle}$$] La relación auxiliar [$M \langle E \Leftarrow x \leftarrow m\rangle$] es la que realmente modifica la memoria con la nueva definición.[$$\frac{E\Leftarrow (m_1.E_2)\in M \;\;\;\;\;\; m_1 \Leftarrow C \in M}{M \langle E \Leftarrow x \leftarrow m\rangle = M\langle M_1 \Leftarrow C \langle x \leftarrow m \rangle \rangle}$$]

Es posible definir el valor predefinido [$|set!|$] que modifica una vinculación preexistente. La dificultad de esta definición estriba en hacerla recursiva (hacia el entorno padre) si no se halla la variable a modificar en el contexto actual.

viernes, 28 de octubre de 2011

El combinador Y en C++ (y II)

La primera parte de esta serie está aquí.

Como se comentó en la primera parte, el combinador Y toma una función g que representa un paso de recursión y devuelve una función p que es el punto fijo de g. Esto del punto fijo no es más que la función recursiva obtenida aplicando g a sí misma infinitas veces. El problema con este planteamiento es que currificar en C++ es difícil. Por esta razón usaremos una versión de g que no esté currificada. El prototipo de esta función sería:
#include <functional>

int g(std::function<int(int)> f,int v);
El tipo de los objetos función en C++ es muy largo y escribir "std::function" cada vez va a emborronar el código. Usaré una macro para aligerar la notación.
#include <functional>

//F(X,Y) es X->Y
#define F(X,Y) std::function<Y(X)>

//F(X,Y,Z) es (X,Y)->Z
#define F2(X,Y,Z) std::function&lg;Z(X,Y)>

int g(F(int,int) f,int v);
Ahora vamos a tratar de definir el combinador Y. La mejor forma de hacerlo es, en vez de usar las funciones lambda de C++ que son muy tediosas, usando la ecuación recursiva que obtuvimos en la primera parte.

Y(g)=g(Y(g))

Como ahora tengo a g sin currificar, he de añadir un argumento extra. Queda así:

Y(g)=[](x){g(Y(g),x)}

Entonces, el código del combinador Y para los enteros sería

F(int,int) Y(  F2( F(int,int) ,int,int)  f)
{
    return [=](int x){return f(Y(f),x);};
}

Realmente la parte difícil es la de los tipos, aunque se pueden obtener poco a poco estudiando la expresión.

Cambiar los int por un tipo genérico nos da el combinador Y genérico en C++:

template<typename T>
F(T,T) Y(  F2( F(T,T) ,T,T)  f)
{
    return [=](T x){return f(Y(f),x);};
}

Ahora sólo tenemos que usarlo. Definimos para eso la función g del factorial y lo volcamos a la salida. El código final es el que sigue:

#include <functional>

#include <iostream>

//F(X,Y) es X->Y
#define F(X,Y) std::function<Y(X)>
 

//F(X,Y,Z) es (X,Y)->Z
#define F2(X,Y,Z) std::function&lg;Z(X,Y)>

int g(F(int,int) f,int v)
{
    return v==0 ? 1 : v * f(v-1);
}

template<typename T>
F(T,T) Y(  F2( F(T,T) ,T,T)  f)
{
    return [=](T x){return f(Y(f),x);};
}

int main(int argc,char** argv)
{
std::cout << Y<int>(g)(5) << std::endl;
    return 0;
}

En este punto sólo queda advertir al lector que es necesario usar un compilador compatible con el estándar de C++ de 2011.

jueves, 27 de octubre de 2011

Semántica natural de LISP - parte 1 - LISP funcional

Como homenaje a McCarthy, voy a dedicar una serie de posts a descubrir la semántica natural del LISP. Empezaremos por un LISP reducido que llamaré LISP funcional en el cual no hay mutaciones de las vinculaciones de variables. Cualquiera que haya leído el SICP reconocerá que ésto se corresponde a la primera parte del libro.

La semántica natural o semántica de paso grande no es más que una relación que a cada programa [$t$] en un contexto [$C$] le proporciona un valor [$v$]. Escribiremos esta relación así [$$C \vdash t \downarrow v$$] y se lee "[$t$] se evalúa a [$v$] bajo el contexto [$C$]". Aunque antes debemos especificar claramente cuáles son las estructuras sintácticas que forman [$t$], [$C$] y [$v$].

Sintaxis

La sintaxis de los programas son términos [$t$] que son a su vez, o bien una variable [$x$], o bien un literal [$l$], o bien un par de términos [$(t.t)$]. Esto se escribe así: [$$t ::= x \mid l \mid ( t . t )$$] Dentro de los literales incluimos la lista vacía [$()$] que permite, junto con el par, formar listas. Una lista [$(1 2 3)$] es realmente [$(1.(2.(3.())))$]. Es decir, el primer componente del par es el término que está en la cabeza de la lista y el segundo componente es otra lista que representa al resto de los términos. Es común llamar a estos componentes "head" y "tail"  (cabeza y cola en inglés) o "car" y "cdr". Estos dos últimos nombres tienen una historia más larga.

Los literales son símbolos como [$1, 53, "hola",$] etc. que tienen un valor en sí mismos. Las variables son símbolos como [$x, y, z,$] etc. que requieren un contexto para saber el valor que representan.

La sintaxis de los valores [$v$] es o bien un término [$t$], o bien una clausura [$\lambda ^C t t$], o bien una forma predefinida [$|p|$]. [$$v::=t\mid \lambda^C tt \mid |p|$$] Escribiremos las formas predefinidas entre barras para distinguirlas de las variables y literales, aunque el símbolo que sea [$p$] puede coincidir con ellos.

Los contextos no son más que una colección de vinculaciones de valores a variables.[$$ C::= \emptyset \mid C,x\leftarrow v$$] Construímos los contextos con el contexto vacío [$\emptyset$] al que le vamos agregando vinculaciones de la forma [$x\leftarrow v$]. Aunque la forma correcta de escribir un contexto sea [$\emptyset, x \leftarrow 5, y \leftarrow 8$], omitiremos el [$\emptyset$].

Operaciones sobre contextos

Vamos a necesitar un par de operaciones para trabajar con los contextos. Son muy simples. La primera es el dominio del contexto [$dom\ C$] que nos dice qué variables se han usado en un contexto. [$$ dom\ \emptyset = \emptyset $$][$$ dom(C,x\leftarrow v)=dom(C)\cup\{x\}$$]

La segunda operación busca una variable en un contexto. Lo escribiremos como una relación de pertenencia [$x\leftarrow v \in C$] para simplificar la lectura. [$$x\leftarrow v\in C,x\leftarrow v$$][$$\frac{x\ne x'\;\;\;\;\;\;x\leftarrow v\in C}{x\leftarrow v\in C,x'\leftarrow v'}$$]La primera línea es una regla tan obvia que lo mismo es difícil de entender: [$x\leftarrow v$] pertenece a [$C,x\leftarrow v$]. La segunda regla dice que [$x\leftarrow v$] pertenece a [$C,x'\leftarrow v'$] si [$x$] es distinta a [$x'$] y [$x\leftarrow v$] pertenece a [$C$]. Si llega un momento que [$C=\emptyset$], no podremos usar ninguna de las dos reglas (y por tanto [$x\leftarrow v$] no pertenecerá).

Ajuste de patrones

Llegará un momento en la evaluación en el cual tendremos que relacionar argumentos con parámetros. La forma más inteligente de hacerlo es usando el ajuste de patrones, también llamado asignación desestructurante. El ajuste de patrones que vamos a ver aquí es muy simple: toma un término y un valor, devolviendo las vinculaciones que deberían tener las variables del término para que se ajuste al valor proporcionado. Por ejemplo. Si quiero ajustar [$x$] y [$3$], lo escribiré así [$\{x\mid 3\}$] y el resultado será que la variable [$x$] ha de vincularse al valor [$3$]. Esta vinculación es la que hemos escrito [$x\leftarrow 3$] en los contextos. Como no tenemos contexto al que añadir la vinculación, lo incluiremos en nuestro ajsute de patrones. El resultado es que el ajuste de patrones es una relación [$C\{t\mid v\}=C$]. El ejemplo de arriba se podría completar entonces con [$$z\leftarrow 8\;\{x\mid 3\}=z\leftarrow 8,x\leftarrow 3$$]Más ejemplos serían [$$z\leftarrow 8\;\{(x\; y)\mid (3\;7)\}=  z\leftarrow 8,x\leftarrow 3,y\leftarrow 7$$][$$\emptyset\{(x y. z)\mid(1 \; (2 \; 3) \; 4 \; 5 \; 6)\}=x\leftarrow 1,y\leftarrow(2\;3), z\leftarrow(4  \;5  \; 6)$$][$$x\leftarrow 5\{x\mid 5\}=???$$] En el último ejemplo no es posible calcular el ajuste de patrones porque [$x$] ya está definida. ¡Incluso si le vamos a dar el mismo valor! De esta manera cada contexto sólo tendrá una única aparición de cada variable.

Las reglas del ajuste de patrones son muy sencillas. En primer lugar, la regla D-LIT dice que los literales han de coincidir.[$$C\{l\mid l\}=C$$] La regla D-VAR modifica el contexto vinculando la variable, que no está definida previamente, al valor.[$$\frac{x\notin C}{C\{x\mid v\}=C,x\leftarrow v}$$] Finalmente, la regla D-PAIR es meramente estructural.[$$C\{(t_1.t_2)\mid(v_1.v_2)\}=C\{t_1\mid v_1\}\{t_2\mid v_2\}$$]

La evaluación

Llega la hora de dar la relación de evaluación [$C \vdash t \downarrow v$] que antes mencionábamos. Son cuatro reglas. La primera, que llamaremos E-LIT, es para saber el valor de un literal. Es muy sencillo porque es él mismo. [$$C \vdash l \downarrow l$$] La segunda (E-VAR) es para saber el valor de una variable. Necesitamos consultar el contexto.[$$\frac{x\leftarrow v \in C}{C \vdash x\downarrow v}$$] La tercera la usaremos para pares cuya cabeza se evalúe a un valor por predefinido. La llamaremos E-PRE. [$$\frac{C\vdash t_0 \downarrow |p|  \;\;\;\;\;\; C\vdash (|p| t_1 \cdots t_n) \rightarrow_\delta v}{C\vdash (t_0 t_1 \cdots t_n)\downarrow v}$$] Aquí hemos usado una relación auxiliar [$C\vdash v\rightarrow_\delta v$] en la que introduciremos la semántica de los valores predefinidos (ver más abajo). Finalmente, la regla E-APP, formaliza el uso de una clausura.[$$\frac{C\vdash t_0 \downarrow \lambda^{C'}t't''  \;\;\;\;\;\; C\vdash (t_1 \cdots t_n) \Downarrow (v_1 \cdots v_n)   \;\;\;\;\;\;  C' \{ t' \mid (v_1 \cdots v_n) \}\vdash t''\downarrow v}{C\vdash (t_0 t_1 \cdots t_n) \downarrow v}$$] Hemos usado el ajuste de patrones en el último antecedente (a la derecha del todo.) También hemos usado una relación auxiliar [$ C\vdash (t_1 \cdots t_n) \Downarrow (v_1 \cdots v_n) $] que llamaremos de "envoltorio" que lo único que hace es evaluar una lista de términos, término a término, para obtener una lista de valores.

Las reglas de esta relación auxiliar de envoltorio son muy simples. Primero, la lista vacía se envuelve a sí misma. [$$C\vdash () \Downarrow ()$$] Y segundo, un par evalúa su cabeza y envuelve el resto. [$$\frac{C\vdash t_1 \downarrow v_1  \;\;\;\;\;\; C\vdash t_2 \Downarrow v_2}{C \vdash (t_1.t_2) \Downarrow (v_1.v_2)}$$] En general podemos ver la relación de envoltorio como una abreviatura de
[$$C\vdash t_1 \downarrow v_1   \;\;\;\;\;\;     C\vdash t_2 \downarrow v_2     \;\;\;\;\;\;  \cdots   \;\;\;\;\;\;   C\vdash t_n \downarrow v_n  $$]  que escribimos [$$ C\vdash (t_1t_2\cdots t_n) \Downarrow (v_1v_2\cdots v_n)$$]

Formas predefinidas

Las formas predefinidas nos pueden servir para trabajar con los literales. Por ejemplo, la suma se puede formalizar así (llamaremos a esta regla P-ADD): [$$\frac{C\vdash (t_1 \cdots t_n)\Downarrow (N_1 \cdots N_n) }{  C\vdash (|+| t_1 \cdots t_n)\rightarrow_\delta \sum_{k=1}^n{N_k}  }$$] Donde los [$N$] mayúsculas han de ser literales de número como el [$3$] o el [$75.82$].

Entre todas las formas es especialmente importante la que genera clausuras. Llamaremos a este valor predefinido[$|\lambda|$] y se define con la regla P-LAMBDA [$$C\vdash (|\lambda| t_1 t_2) \rightarrow_\delta \lambda^Ct_1 t_2 $$] Con esta forma especial podemos definir funciones.

Ejemplos de evaluación

Si usamos un contexto inicial [$$C_0 = lambda \leftarrow |\lambda|, +\leftarrow |+|$$] tenemos suficiente potencia expresiva para calcular el doble de [$3$] (realmente, con lambda y usando la codificación de Church, tenemos la potencia expresiva de un modelo computacional Turing completo). Me he tomado algunas libertades para simplificar la derivación (no he usado la abreviatura del envoltorio y le he dado nombres a los contextos). El resultado es el que sigue (clic para ampliar):


En el contexto inicial podemos incluir más definiciones. Algunas funciones típicas son:[$$car\leftarrow \lambda^{C_0}((x.y))x$$][$$cdr\leftarrow\lambda^{C_0}((x.y))y$$][$$list\leftarrow\lambda^{C_0}xx$$][$$cons\leftarrow\lambda^{C_0}(x y)(x.y)$$] Con este nuevo contexto inicial podemos calcular el segundo elemento de la lista [$(1 2 3)$]. La derivación (omitiendo ya nombres de reglas) es la que sigue:


Hasta aquí por hoy. En la siguiente parte de esta serie permitiremos mutaciones en la vinculación de las variables.

martes, 25 de octubre de 2011

Muere John McCarthy

Estamos teniendo un mes bastante triste en el mundo de la informática. Primero, muere el carismático Jobs, luego el creador del lenguaje C, Dennis Ritchie,  y ayer murió John McCarthy el creador del LISP (en 1959) y casi todas las tecnologías asociadas a él, entre otras:
Además, leo que inventó la lógica no monótona por circunscripción. Esta lógica viene a decir más o menos que si no enciende el televisor, no enciende la tostadora, no enciende la nevera y no enciende la estufa, lo que fallan son los fusibles. Esto que parece una tontería es uno de los puntales en inteligencia artificial. Campo al que se dedicó en vida. Descanse en paz.

sábado, 22 de octubre de 2011

El extraño caso del disco duro resucitado

Se me fastidió el disco duro. Es una lata perder varios gigas de información. Antiguamente, si se te rompía un floppy, tampoco era un trauma. Eran 1.44 MB. La cosa ha cambiado. En la actualidad, cualquier fallo se lleva gigas y gigas por delante.

Afortunadamente los discos duros suelen fallar por motivos mecánicos. Las piezas se van deformando poco a poco. Los encajes son cada vez menos perfectos. El rozamiento va limando lentamente las zonas de fricción. ¿Por qué digo afortunadamente? Porque los discos duros suelen empezar a hacer ruidos raros antes de dejar de funcionar definitivamente. El mío, particularmente, además de los ruidos raros, dejaba de responder y se reiniciaba.


Así que, al primer ruido raro que oí, apagué el ordenador, desconecté el disco duro físicamente y empecé a buscar sustituto. Tras unos días de espera por el pedido (hace años que las tiendas de informática no tienen casi nada en stock), procedí a instalar el nuevo disco. Cada vez que me compro un disco nuevo es más silencioso, se calienta menos y tiene más capacidad. Es maravilloso. Mientras no fallen, claro.


Ahora quedaba el lento traspaso de la información del disco a punto de romperse al disco nuevo. Es un proceso muy tenso, ya que en cualquier momento el disco termina por romperse y pierdes lo que no hayas copiado. Un pequeño truco que he descubierto para hacer la espera algo menos tensa es poner el disco a punto de romperse en una caja externa conectado por USB. De esta manera, el SO se comporta de otra forma cuando el disco deja de responder. Cuando el disco no es extraíble, el SO se queda bloqueado; pero cuando es extraíble, te pregunta por si quieres reintentar la lectura. Esto es maravilloso cuando, después de varios minutos de copia de un fichero de varios gigas, el disco duro se reinicia solo. Si no fuera por que está en modo extraíble se perdería la información. En modo extraíble esperas a que se reinicie y le dices que reintente. Continua por el mismo sector por donde lo dejó.


El adaptador USB para discos duros que tengo es uno barato que estaba de oferta. Tan barato era que, en medio del tenso traspaso de información, algo explotó dentro de la fuente de alimentación con el consiguiente olorcillo a electrónica tostada y el típico humillo blanco. En principio, no era problemático porque tengo la fuente del propio PC a la pude conectar el disco duro directamente. Con eso conseguí salvar el 80% de la información... hasta que el disco duro dejó de funcionar definitivamente.

Como fui astuto a la hora de volcar la información, el 20% restante estaba en DVDs y, tras una breve búsqueda entre los DVDs medio olvidados, tenía recuperado todo lo que había perdido. Menos mal.


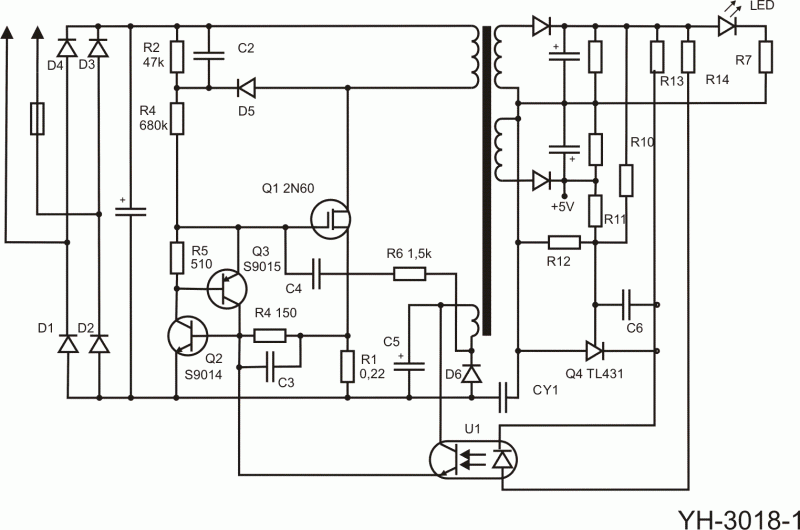
Una vez tranquilizado, me dispuse a arreglar la fuente de alimentación del adaptador USB. No sé qué tipo de fusible le habían puesto porque se había volatilizado. Con él un diodo de los gordos, de tres amperios. Con ayuda de los esquemáticos encontrados en internet pude comprobar que todos los semiconductores del primario y la mitad del secundario estaban en corto. Por un par de euros conseguí recambios equivalentes en la tienda de electrónica local. Puse más fusibles, por si las moscas, y más ajustados al valor nominal. Enchufé la fuente y empezó a funcionar de nuevo.


Para probar la fuente qué podría haber mejor que el disco duro recién roto. Como el fallo era mecánico, el PC debería reconocerlo aunque no pudiera acceder a la información. Bastaría con eso para comprobar que la alimentación era correcta. Sin embargo, en cuanto enchufé la alimentación, olí de nuevo a electrónica algo tostada. Muy sutilmente esta vez. Apagué con rapidez y procedí a probar el disco duro con la fuente del PC para comprobar si había pasado, definitivamente, a mejor vida electrónica.

¡Y empezó a funcionar sin fallo alguno!

Pero, ¿cómo puede ser? Medí los voltajes que daba la fuente de alimentación y en vez de 5V daba 8V; en vez de 12V daba 18V. ¿Cómo puede ser? ¿Un calentón eléctrico repara un fallo mecánico? Imposible. Las explicaciones que me vienen a la mente son muy rebuscadas: que los motores estuvieran algo sucios y al calentarse han disuelto algo la porquería que los bloqueaba, que se haya quemado el circuito que detecta que hay un fallo mecánico y por eso ahora es feliz, que el sobrevoltaje haya forzado la pieza mecánica y la haya vuelto a colocar en su sitio... Muy improbable todo.


La cosa es que ese disco duro resucitado venía en una caja externa de Maxtor. Lo he vuelto a montar ahí y está funcionando. O parece que lo hace...

No me fío y nunca me fiaré.

jueves, 13 de octubre de 2011

Muere un grande de la informática

Hace unos días murió Dennis Ritchie, uno de los creadores del lenguaje más usado en la breve historia de la informática: el lenguaje C. Fue un premio Turing y uno de los desarrolladores de UNIX. Como tantas veces, su muerte ha pasado desapercibida en los medios generalistas.


domingo, 9 de octubre de 2011

miniSL parte 16 - El código hasta ahora

Como prometí en la última entrada de esta serie, aquí está el código que tenemos desarrollado hasta ahora. Ya llevamos 425 líneas de código. Más o menos la mitad de toda la implementación. Faltan por desarrollar el reconocimiento sintáctico, las funciones nativas y el REPL. Empezaremos en la siguiente entrada con el reconocimiento sintáctico.

//Standard includes
#include <string>
#include <map>
#include <deque>
#include <fstream>
#include <sstream>
#include <iostream>
#include <vector>

//Forward declarations
class Script;
struct CELL;

//
// Type declarations
//

typedef std::wstring STRING;
typedef std::wistream ISTREAM;
typedef std::wostream OSTREAM;
typedef std::map<STRING, CELL*> STRING_MAP;
typedef std::map<CELL*, CELL*> ENVIR_TABLE;
typedef std::deque<CELL> CELL_STORAGE;
typedef CELL& (*NATIVE) (Script& script, CELL& args, CELL& envir);


//
// CELL STRUCTURE
//

enum CELL_TYPE
{
 UNUSED, 

 //Literals
 EMPTY_LIT, INT_LIT, STRING_LIT,

 //Value constructors
 LAMBDA_VAL, NATIVE_VAL, ENVIR_VAL, BOOL_VAL, 

 //Code constructors
 NAME_CODE, COMBINE_CODE,

 //Value and code constructors
 CONS_CTOR
};

struct CELL
{
 CELL_TYPE type;
 bool mark;      //Garbage collection mark
 union
 {
  CELL* next_unused;   //UNUSED
  int int_val;    //INT_LIT
  bool bool_val;    //BOOL_VAL
  STRING const* string_val; //STRING_LIT
  CELL* head;     //CONS.
  CELL* code;     //LAMBDA_VAL. The cell must be a CONS_CTOR with parameters and body
  NATIVE native;    //NATIVE_VAL
  ENVIR_TABLE* envir_table; //ENVIR_VAL
  CELL* op;     //COMBINE_CODE. The cell must be code (Any *_CODE type or CONS or EMPTY)
 };

 union
 {
  CELL* tail;   //CONS. Must be CONS or EMPTY.
  CELL* closure;  //LAMBDA_VAL. The cell must be an environment (ENVIR_VAL)
  CELL* parent_envir; //ENVIR_VAL. The pointer may be NULL or an environment cell (ENVIR_VAL)
  CELL* operands;  //COMBINE_CODE. The cell must be a list of code.
 };

 void Print(OSTREAM& o)const;
 void PrintList(OSTREAM& o, STRING const& separator)const;
 static void PrintEscapedString(OSTREAM& o, STRING const& s);

 int GetInteger()const   { if(type==INT_LIT) return int_val; else throw L"Integer expected"; }
 bool GetBoolean()const   { if(type==BOOL_VAL) return bool_val; else throw L"Boolean expected"; }
 STRING const& GetString()const { if(type==STRING_LIT) return *string_val; else throw L"String expected"; }
};

//
// SCRIPT CLASS
//

class Script
{
public:
 Script() : m_FirstUnused(NULL) { m_GlobalEnvir=&CreateEnvir(NULL); }
 ~Script() { GCSweep(); GCSweep(); } //Sweep twice to delete everything

 CELL& CreateCell(CELL_TYPE ct, CELL* first=NULL, CELL* second=NULL);
 CELL& CreateInteger(int val){ CELL& c=CreateCell(INT_LIT); c.int_val=val; return c; }
 CELL& CreateBool(bool val) { CELL& c=CreateCell(BOOL_VAL); c.bool_val=val; return c; }
 CELL& CreateString(STRING const& val);
 CELL& CreateName(STRING const& val);
 CELL& CreateEnvir(CELL* parent);
 CELL& CreateNative(NATIVE native);

 ENVIR_TABLE& GlobalEnvirTable()const { return *m_GlobalEnvir->envir_table; }
 void DefineUsualSymbols();

 void DefineGlobalNative(STRING const& name, NATIVE nat)
 {
  (*m_GlobalEnvir->envir_table)[&CreateName(name)]=&CreateNative(nat);
 }

 CELL& Evaluate(CELL& c, CELL& envir);
 CELL& EvaluateInSequence(CELL& listc, CELL& envir);
 CELL& Evaluate(CELL& c)     { return Evaluate(c, *m_GlobalEnvir); }

 int GarbageCollect();
 static void GCMark(CELL* c);

 static CELL* FindName(CELL& name, CELL& envir);
 static void ChangeName(CELL& name, CELL& envir, CELL& value);

 void* m_User;
private:
 enum TOKEN_TYPE { T_NONE, T_RAW, T_LITERAL, T_SYMBOL, T_NAME };

 struct TOKEN
 {
  TOKEN() : type(T_NONE) {}
  TOKEN(TOKEN_TYPE t, CELL* d) : type(t), data(d) {}
  TOKEN(ISTREAM::int_type r) : type(T_RAW), raw(r) {}

  TOKEN_TYPE type;
  union
  {
   CELL* data;
   ISTREAM::int_type raw;
  };
 };

private:
 int GCSweep();

 CELL& ApplyLambda(CELL& code, CELL& args, CELL& closure, CELL& envir);
private:
 CELL* m_FirstUnused;
 CELL* m_GlobalEnvir;
 CELL_STORAGE m_Cells;
 STRING_MAP m_InternedStrings;
 TOKEN m_Ahead;
};

//
// (CELL) PRINTING
//

void CELL::Print(OSTREAM& o)const
{
 switch(type)
 {
 default:  o << L"{{**UNKNOWN**}}"; break;
 case UNUSED: o << L"{{**UNUSED**}}"; break;
 case INT_LIT: o << std::dec << int_val; break;
 case BOOL_VAL: o << (bool_val ? L"true" : L"false"); break;
 case LAMBDA_VAL:o << L"{{ "; code->Print(o); o << L" }}"; break;
 case NATIVE_VAL:o << L"{{NATIVE}}"; break;
 case STRING_LIT:PrintEscapedString(o, *string_val); break;
 case NAME_CODE: o << L"@"; PrintEscapedString(o, *string_val); break;

 case CONS_CTOR: case EMPTY_LIT:
  o << L"[";
  PrintList(o, L", ");
  o << L"]";
  break;

 case ENVIR_VAL: o << L"{{ENVIR ";
  for(ENVIR_TABLE::const_iterator i=envir_table->begin(); i!=envir_table->end(); ++i)
  {
   o << *i->first->string_val << L"= ";
   i->second->Print(o);
  }
  o << L"}}";
  break;

 case COMBINE_CODE:
  op->Print(o);
  o << L"(";
  operands->PrintList(o, L", ");
  o << L")";
  break;
 }
}

void CELL::PrintList(OSTREAM& o, STRING const& separator)const
{
 for(CELL const* c=this; c->type==CONS_CTOR; c=c->tail)
 {
  if(c!=this)
   o << separator;
  c->head->Print(o);
 }
}

void CELL::PrintEscapedString(OSTREAM& o, STRING const& s)
{
 o << L"\"";
 for(STRING::const_iterator i=s.begin(); i!=s.end(); ++i)
 {
  if(*i<32) o << L"\\x" << std::hex << (unsigned int)(unsigned)*i << L";";
  else  o << *i;
 }
 o << L"\"";
}


//
// ALLOCATION AND GARBAGE COLLECTION
//

CELL& Script::CreateCell(CELL_TYPE ct, CELL* first, CELL* second)
{
 CELL* p;
 if(m_FirstUnused==NULL)
 {
  CELL c;
  m_Cells.push_back(c);
  p=&m_Cells.back();
 }
 else
 {
  p=m_FirstUnused;
  m_FirstUnused=p->next_unused;
 }
 p->mark=false;
 p->type=ct;
 p->head=first;
 p->tail=second;
 return *p;
}

CELL& Script::CreateString(STRING const& val)
{
 CELL& c=CreateCell(STRING_LIT);
 c.string_val=new STRING(val);
 return c;
}

CELL& Script::CreateName(STRING const& val)
{
 STRING_MAP::const_iterator i=m_InternedStrings.find(val);
 if(i==m_InternedStrings.end())
 {
  CELL& c=CreateCell(NAME_CODE);
  i=m_InternedStrings.insert(std::make_pair(val, &c)).first;
  c.string_val=&i->first;
 }
 return *i->second;
}

CELL& Script::CreateEnvir(CELL* parent)
{
 CELL& c=CreateCell(ENVIR_VAL);
 c.envir_table=new ENVIR_TABLE;
 c.parent_envir=parent;
 return c;
}

CELL& Script::CreateNative(NATIVE native)
{
 CELL& c=CreateCell(NATIVE_VAL);
 c.native=native;
 return c;
}

int Script::GarbageCollect()
{
 GCMark(m_GlobalEnvir);
 return GCSweep();
}

void Script::GCMark(CELL* c)
{
 if(c==NULL || c->mark)
  return;

 c->mark=true;

 switch(c->type)
 {
 case UNUSED:  throw L"Marking unused cell";
 case CONS_CTOR:  GCMark(c->head); GCMark(c->tail);  break;
 case LAMBDA_VAL: GCMark(c->code); GCMark(c->closure);  break;
 case COMBINE_CODE: GCMark(c->op);  GCMark(c->operands); break;

 case ENVIR_VAL:
  GCMark(c->parent_envir);
  for(ENVIR_TABLE::const_iterator i=c->envir_table->begin(); i!=c->envir_table->end(); ++i)
  {
   GCMark(i->first);
   GCMark(i->second);
  }
  break;
 }
}

int Script::GCSweep()
{
 int count=0;
 for(CELL_STORAGE::iterator i=m_Cells.begin(); i!=m_Cells.end(); ++i)
 {
  if(i->mark)
  {
   i->mark=false;
   continue;
  }

  if(i->type==UNUSED)
   continue;

  ++count;

  switch(i->type)
  {
  case STRING_LIT: delete i->string_val;      break;
  case ENVIR_VAL:  delete i->envir_table;      break;
  case NAME_CODE:  m_InternedStrings.erase(*i->string_val); break;
  }

  i->type=UNUSED;
  i->next_unused=m_FirstUnused;
  m_FirstUnused=&*i;
 }
 return count;
}

//
// EVALUATION
//

CELL& Script::Evaluate(CELL& c, CELL& envir)
{
 CELL* aux;
 switch(c.type)
 {
  //Non evaluable
 case UNUSED: throw L"Evaluating an unused cell";
 default:  throw L"Evaluating an unknown cell";
 case LAMBDA_VAL:throw L"Evaluating a lambda value";
 case NATIVE_VAL:throw L"Evaluating a native";
 case ENVIR_VAL: throw L"Evaluating an environment";

  //Literals
 case INT_LIT: case BOOL_VAL: case STRING_LIT: case EMPTY_LIT:
  return c;

  //Code constructors
 case CONS_CTOR:  return CreateCell(CONS_CTOR, &Evaluate(*c.head, envir), &Evaluate(*c.tail, envir));

 case NAME_CODE: 
  if((aux=FindName(c, envir))==NULL)
   throw L"Unknown name";
  return *aux;

 case COMBINE_CODE:
  switch((aux=&Evaluate(*c.op, envir))->type)
  {
  case LAMBDA_VAL: return ApplyLambda(*aux->code, *c.operands, *aux->closure, envir);
  case NATIVE_VAL: return aux->native(*this, *c.operands, envir);
  default:   throw L"Non-combinable value";
  }
 }
}

CELL& Script::EvaluateInSequence(CELL& c, CELL& envir)
{
 CELL* aux=&CreateCell(EMPTY_LIT);
 for(CELL* p=&c; p->type==CONS_CTOR; p=p->tail)
  aux=&Evaluate(*p->head, envir);
 return *aux;
}

CELL* Script::FindName(CELL& name, CELL& envir)
{
 //Try to find the name in current environment
 ENVIR_TABLE::const_iterator i=envir.envir_table->find(&name);
 if(i!=envir.envir_table->end())
  return i->second;

 //Failed, try parent
 if(envir.parent_envir!=NULL)
  return FindName(name, *envir.parent_envir);

 //Failed also, not found
 return NULL;
}

void Script::ChangeName(CELL& name, CELL& envir, CELL& value)
{
 //Try to find the name in current environment
 ENVIR_TABLE::iterator i=envir.envir_table->find(&name);
 if(i!=envir.envir_table->end())
 {
  (*envir.envir_table)[&name]=&value;
  return;
 }

 //Failed, try parent
 if(envir.parent_envir!=NULL)
  return ChangeName(name, *envir.parent_envir, value);

 //Failed also, not found
 throw L"Name to be changed is undefined";
}

CELL& Script::ApplyLambda(CELL& code, CELL& args, CELL& closure, CELL& envir)
{
 CELL& new_envir=CreateEnvir(&closure);
 CELL* params=code.head;
 CELL* arguments=&args;
 while(params->type==CONS_CTOR && arguments->type==CONS_CTOR)
 {
  (*new_envir.envir_table)[params->head]=&Evaluate(*arguments->head, envir);
  params=params->tail, arguments=arguments->tail;
 }

 if((params->type!=CONS_CTOR) != (arguments->type!=CONS_CTOR))
  throw L"Invalid arity";

 return EvaluateInSequence(*code.tail->head, new_envir);
}